联邦学习技术:数据孤岛破局者,为什么现在才火?
去年刷隐私计算行业峰会的嘉宾PPT,十个里面有八个把联邦学习技术放在封面C位。有人说这是未来十年数据合作的核心底座,也有人骂这是资本炒出来的伪概念,割完一波韭菜就跑。
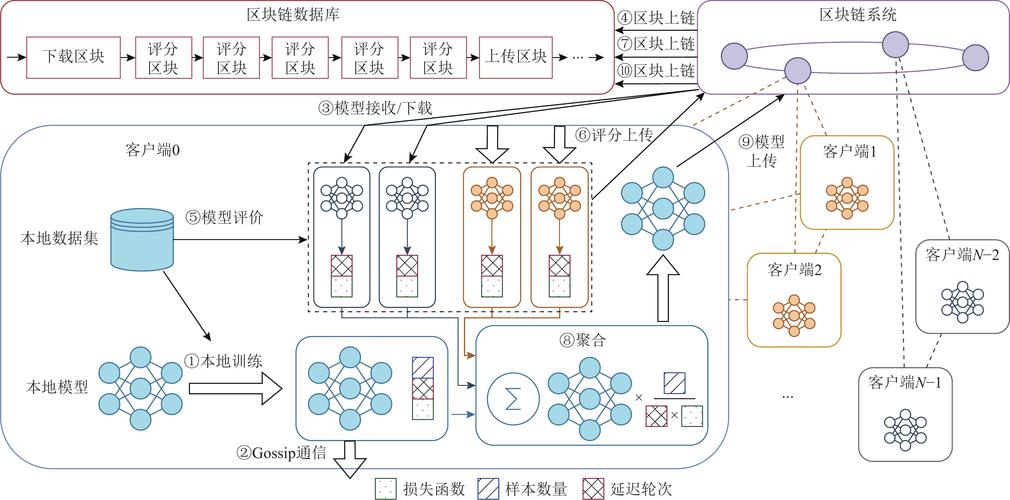 横向联邦学习训练流程示意图
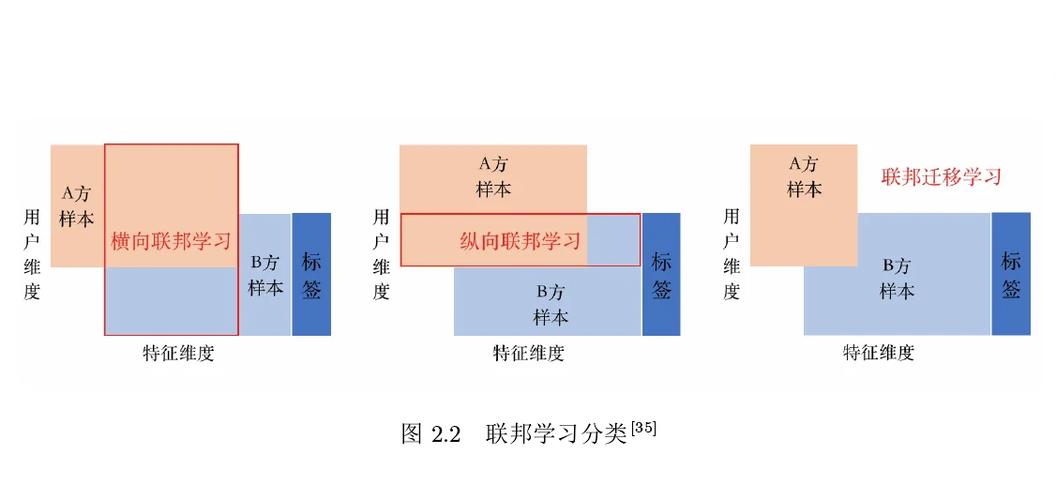
很多文章喜欢把横向联邦、纵向联邦讲得云里雾里,其实人话就是这么回事:横向联邦,是你我做一样的业务,只是用户不一样,凑一起扩大训练样本量;纵向联邦,是你我手里有对方没有的用户特征,拼起来让模型特征更丰富,效果更好。
说实话,就这个思路,放在十年前其实也能做。为什么那时候没人用?
一来那时候大家对数据隐私合规的要求没这么严,买数据卖数据的灰色产业链还活的好好的,犯不上费这么大劲。二来那时候算力带宽也没现在这么便宜,传参数攒模型的成本比直接买数据还高,犯不着。
刚好这两年监管收紧,算力成本降了,它就顺理成章火了。
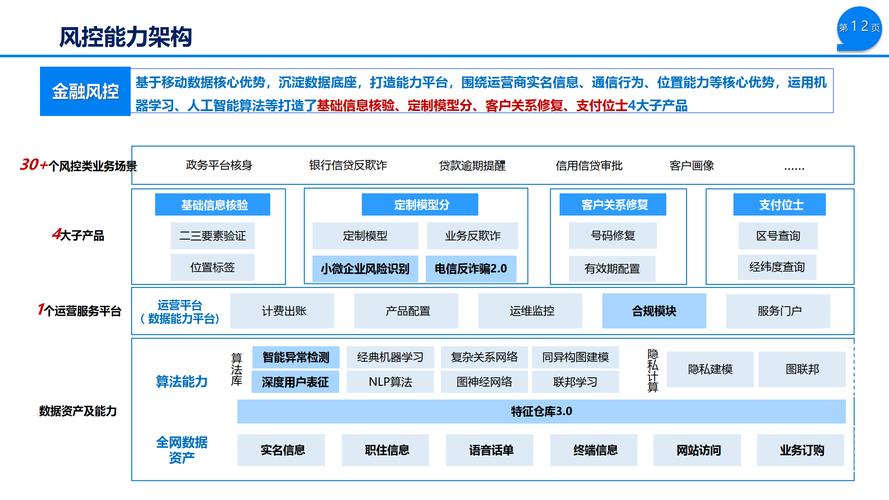 金融风控联邦学习应用架构图
不过话说回来,联邦学习也不是完美无缺的。
现在最大的痛点就是通信开销,几百个参与方一起训练模型,每次迭代都要传参数,对带宽的要求很高,中小机构真不一定扛得住。还有安全问题,早年确实有研究证明,可以通过传出去的梯度反推原始用户信息,这些年学术界把这个坑补的差不多了,结合差分隐私、同态加密这些技术,现在安全系数已经足够满足大多数行业的需求了。
最烦的就是那帮割韭菜的,把联邦学习包装成解决所有数据问题的万能神药,不管客户有没有数据合作需求,先把框架卖出去再说,很多小公司花了几百万买回来,放在服务器里落灰,纯纯浪费钱。
 联邦学习技术下一步,会往哪个方向走?
现在最火的方向,肯定是联邦大模型。
大家都在抢着训行业大模型,每个机构都有自己独有的私有数据,谁敢把自己的核心数据拿出来凑在一起训?没人敢。联邦学习刚好适配这个需求:每个机构在自己本地用私有数据微调大模型,只传微调后的参数,聚合之后就能得到一个效果比单机构训好太多的行业大模型,数据隐私还能保住。
前不久字节跳动和北京大学联合发布的联邦大模型科研成果,在十几个多模态行业任务上做了测试,准确率比单机构训练的 baseline 高了10个百分点以上,效果真的挺惊艳。
还有一个方向很有潜力,就是和边缘计算结合。
现在到处都是物联网设备,智能汽车、智能家居、监控摄像头,每个设备都在产生数据,把所有数据传到云端训模型,一来带宽成本太高,二来用户隐私也没保障,用联邦学习在边缘设备本地训模型,只传参数,刚好解决这个问题。
我接触联邦学习快六年了,看着它从实验室里没人关注的小方向,变成现在千亿隐私计算市场的核心技术,真的挺感慨。
一开始没人信它能做出来,现在一堆人把它吹上天,还有人把它踩成伪需求,其实都没必要。它就是一个刚好踩中了时代需求的技术——解决了数据不能共享,又要一起用的矛盾,既符合监管要求,又能给各个行业带来实际的收益。
未来它不会一直站在风口C位,只会慢慢沉下去,变成数据合作领域的一项基础技术,就像现在大家用云计算一样,没人会天天把云计算挂在嘴边,但各行各业都离不开它。联邦学习未来也会是这样。对吧?
别听那帮人瞎扯,先搞懂联邦学习到底解决什么问题
说白了,所有做数据合作的公司,都会撞到一座绕不开的墙——数据孤岛。 银行手里有用户的金融行为数据,电商手里有用户的消费偏好数据,运营商手里有用户的出行通信数据,三家都知道,把数据凑一起训出来的模型,效果肯定比自己单打独斗好太多。 但现在谁敢随便把原始数据往外传?《个人信息保护法》摆在那,数据出域就是合规事故,搞不好罚到你肉疼。 这个矛盾,联邦学习刚好解决。模型出门,数据在家——就这么简单一句话。 所有参与合作的机构,都在自己本地训练模型,不需要把原始数据传给任何人,只需要把训练过程中更新的参数、梯度传出去聚合,最后大家拿到的共同模型,效果和凑齐所有数据训出来的差不多,原始数据自始至终都没离开过自己的地盘。横向联邦学习训练流程示意图
很多文章喜欢把横向联邦、纵向联邦讲得云里雾里,其实人话就是这么回事:横向联邦,是你我做一样的业务,只是用户不一样,凑一起扩大训练样本量;纵向联邦,是你我手里有对方没有的用户特征,拼起来让模型特征更丰富,效果更好。
说实话,就这个思路,放在十年前其实也能做。为什么那时候没人用?
一来那时候大家对数据隐私合规的要求没这么严,买数据卖数据的灰色产业链还活的好好的,犯不上费这么大劲。二来那时候算力带宽也没现在这么便宜,传参数攒模型的成本比直接买数据还高,犯不着。
刚好这两年监管收紧,算力成本降了,它就顺理成章火了。
吹上天的联邦学习,真的落地出成果了吗?
别听很多PPT瞎吹,联邦学习真不是停在实验室的概念。现在落地最多的,就是金融行业的风控场景。 我上个月跟某股份制银行的科技岗朋友吃饭,他说他们去年上了基于联邦学习的联合风控系统,今年线上消费贷的坏账率真降了两个百分点。原来银行只有自己积累的用户还款、行为数据,训练出来的风控模型AUC大概在0.78左右,接入联邦学习,联合电商平台的消费特征、运营商的行为特征之后,AUC直接能涨到0.85往上,风险识别的准确率提升真的肉眼可见。 全程没有任何原始数据跨机构流动,合规检查一遍过,一点毛病没有。 除了金融,医疗科研领域现在的应用成果也不少。 多家三甲医院联合训练癌症早期预测模型,每个医院的病历数据都不能随便对外共享,用联邦学习就能解决这个问题,训练出来的模型比单个医院用自己的数据训出来的,准确率高了快15%,去年 Nature 子刊还发过相关的科研成果,可信度没问题。金融风控联邦学习应用架构图
不过话说回来,联邦学习也不是完美无缺的。
现在最大的痛点就是通信开销,几百个参与方一起训练模型,每次迭代都要传参数,对带宽的要求很高,中小机构真不一定扛得住。还有安全问题,早年确实有研究证明,可以通过传出去的梯度反推原始用户信息,这些年学术界把这个坑补的差不多了,结合差分隐私、同态加密这些技术,现在安全系数已经足够满足大多数行业的需求了。
最烦的就是那帮割韭菜的,把联邦学习包装成解决所有数据问题的万能神药,不管客户有没有数据合作需求,先把框架卖出去再说,很多小公司花了几百万买回来,放在服务器里落灰,纯纯浪费钱。
联邦学习技术下一步,会往哪个方向走?
联邦学习技术下一步,会往哪个方向走?
现在最火的方向,肯定是联邦大模型。
大家都在抢着训行业大模型,每个机构都有自己独有的私有数据,谁敢把自己的核心数据拿出来凑在一起训?没人敢。联邦学习刚好适配这个需求:每个机构在自己本地用私有数据微调大模型,只传微调后的参数,聚合之后就能得到一个效果比单机构训好太多的行业大模型,数据隐私还能保住。
前不久字节跳动和北京大学联合发布的联邦大模型科研成果,在十几个多模态行业任务上做了测试,准确率比单机构训练的 baseline 高了10个百分点以上,效果真的挺惊艳。
还有一个方向很有潜力,就是和边缘计算结合。
现在到处都是物联网设备,智能汽车、智能家居、监控摄像头,每个设备都在产生数据,把所有数据传到云端训模型,一来带宽成本太高,二来用户隐私也没保障,用联邦学习在边缘设备本地训模型,只传参数,刚好解决这个问题。
我接触联邦学习快六年了,看着它从实验室里没人关注的小方向,变成现在千亿隐私计算市场的核心技术,真的挺感慨。
一开始没人信它能做出来,现在一堆人把它吹上天,还有人把它踩成伪需求,其实都没必要。它就是一个刚好踩中了时代需求的技术——解决了数据不能共享,又要一起用的矛盾,既符合监管要求,又能给各个行业带来实际的收益。
未来它不会一直站在风口C位,只会慢慢沉下去,变成数据合作领域的一项基础技术,就像现在大家用云计算一样,没人会天天把云计算挂在嘴边,但各行各业都离不开它。联邦学习未来也会是这样。对吧?