别被大模型忽悠:重新认识真正落地的可信AI技术
前阵子帮一个做金融AI的朋友看BP,翻完整整三十页,一大半篇幅在吹他们大模型的准确率,翻到最后,我问了一句:你们的可信机制怎么做的?对方愣了三秒,说:我们加了内容审核,这不就是可信吗?哦,合着现在可信AI就是这么用的?
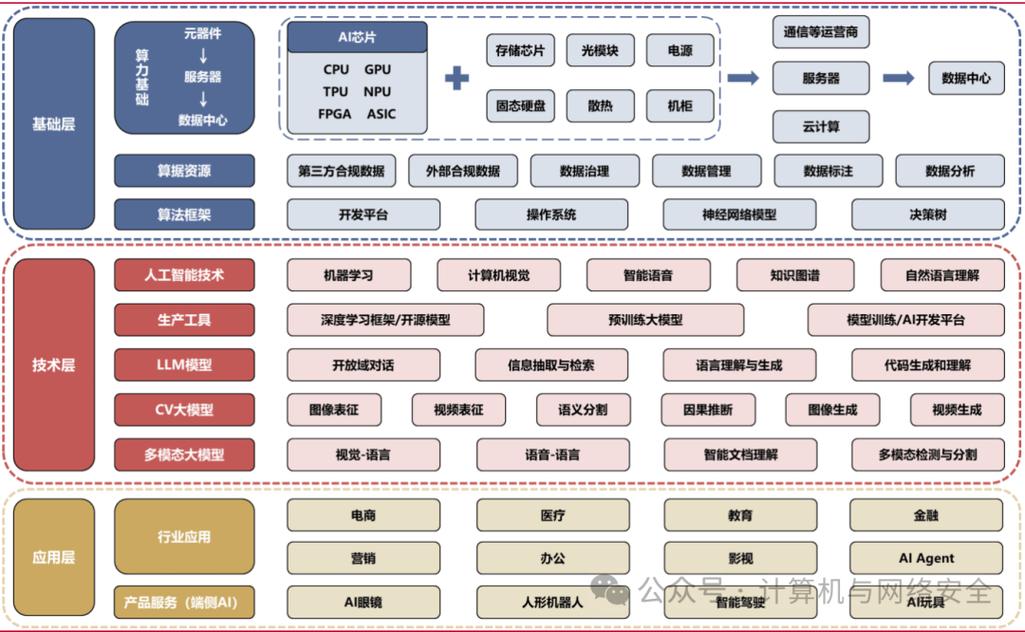 工业界可信AI技术核心框架图
举个最简单的例子,现在大家天天吐槽的大模型幻觉,本质就是模型输出不可信,没有达到可信AI的要求。上个月我身边就有例子,某上市公司用生成式AI做年报初稿,AI把公司三年前的营收数据编错了两个亿,差点闯了大祸。要是做了可信AI的事实校验锚定,能出这种错?
现在监管的要求也越来越明确,从去年的生成式AI管理办法,到今年年初的人工智能法草案征求意见,都把“可信”“可靠”“可控”放在最前面,这不是随口说的要求,是给所有AI从业者划的底线。
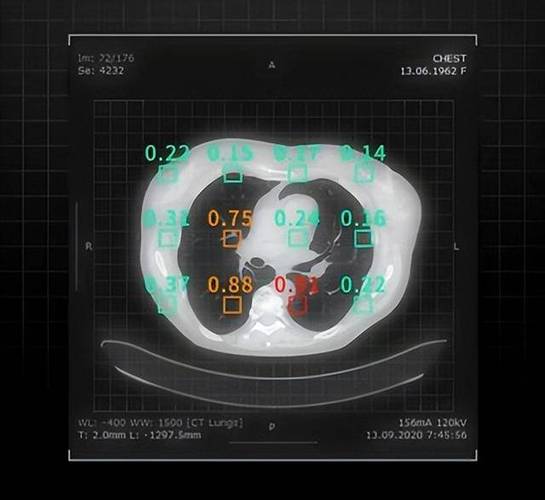 可解释AI肺结节检测病灶标注图
AI判断有结节,直接就能在CT图上圈出病灶位置,告诉你是哪些影像特征支撑了这个判断,医生一眼就能验证,审批的时候直接就过了。现在他们的产品已经进了三百多家医院,这不是落地是什么?
不过话说回来,圈里混水摸鱼的也不少。我见过好几个项目,就是在原来的AI模型外面加了一层内容审核,就敢对外吹“全链路可信AI”,骗政府项目的补贴,脸都不红。连大模型最基本的幻觉问题都解决不了,谈什么可信?
 做可信AI技术,最容易踩的几个坑
第一个坑,就是为了可信牺牲模型性能。很多人做可信AI,觉得复杂模型不可信,那我换成简单的线性模型不就行了?结果可解释性是上去了,准确率掉了快十个点,这样的模型拿来能用吗?
现在真正做得好的可信AI,都是在不损失核心性能的前提下做可信增强。比如现在大火的检索增强生成,也就是大家说的RAG,本质就是给大模型加了一层可信锚点,所有生成内容都要先跟知识库的事实做对齐,大大降低了幻觉,生成能力几乎不受影响,这才是正确的思路。
第二个坑,就是把可信AI做成了纯合规项目,为了凑指标,不解决实际问题。比如说鲁棒性测试,很多公司只拿标准测试集测,分数好看得很,结果稍微改一点点输入,加个人类都看不出来的扰动,模型直接就判断错了,这样的可信有什么用?骗监管而已。
第三个坑,就是觉得可信AI只是合规部门的事,技术团队不用管。我接触过好几个大厂的AI团队,提起可信AI,都说这是合规组的活,我们只管把模型能力做上去。其实大错特错。AI越大,能力越强,出问题的代价就越大。前两年的大数据杀熟,今年层出不穷的AI换脸诈骗,哪一个不是AI不可信闹出的事?对吧?
OpenAI现在把对齐研究当成头号工程,核心不就是解决大模型的可信问题吗?国内现在大模型备案,可信能力是核心考察项,你连基本的输出真实性都保证不了,根本拿不到备案,连入场的资格都没有。
再过三年,AI肯定会渗进我们生活的每个角落。小到手机支付的身份核验,大到医院的手术方案制定,银行的授信审批,自动驾驶的行车决策,哪一步错得起?可信AI技术从来不是AI行业的锦上添花,是活下去的入场券。你说对不对?
到底什么才是真的可信AI技术?不是喊口号蹭热点
现在圈里把可信AI炒得烂大街,好像什么东西沾个边就能吹。实际上现在学术界和工业界公认的可信AI,核心就是四个硬指标:可解释、可审计、鲁棒性、隐私保护。四个缺一个,都算不上真的可信。工业界可信AI技术核心框架图
举个最简单的例子,现在大家天天吐槽的大模型幻觉,本质就是模型输出不可信,没有达到可信AI的要求。上个月我身边就有例子,某上市公司用生成式AI做年报初稿,AI把公司三年前的营收数据编错了两个亿,差点闯了大祸。要是做了可信AI的事实校验锚定,能出这种错?
现在监管的要求也越来越明确,从去年的生成式AI管理办法,到今年年初的人工智能法草案征求意见,都把“可信”“可靠”“可控”放在最前面,这不是随口说的要求,是给所有AI从业者划的底线。
已经落地的可信AI技术,真的能解决问题吗
很多人觉得可信AI都是实验室里的概念,赚经费的噱头。说实话,真不是。现在在金融、医疗、自动驾驶这些对容错率极低的领域,可信AI已经是标配了。 比如说隐私保护这块,现在联邦学习作为可信AI的核心落地技术,已经被十几家全国性银行用在反欺诈模型训练里。原来多家银行要联合训练,必须把用户数据汇总到一起,不仅违反个人信息保护法,还容易出数据泄露的事。用联邦学习,每家银行的原始数据都不出自己的域,只把训练过程中的模型参数加密传出来联合更新,最后训出来的模型,比单家银行自己训的准确率高15%以上,还全程满足合规要求,这不就是实实在在的价值? 再讲可解释性,我去年去一家拿了三类证的医疗AI公司参观,他们做肺结节CT检测,原来的老模型是纯深度学习黑盒,AI告诉你这张片子有结节,但是不说为什么,医生不敢用,审批也过不了。后来他们加了基于可信AI的可解释模块,效果完全不一样。可解释AI肺结节检测病灶标注图
AI判断有结节,直接就能在CT图上圈出病灶位置,告诉你是哪些影像特征支撑了这个判断,医生一眼就能验证,审批的时候直接就过了。现在他们的产品已经进了三百多家医院,这不是落地是什么?
不过话说回来,圈里混水摸鱼的也不少。我见过好几个项目,就是在原来的AI模型外面加了一层内容审核,就敢对外吹“全链路可信AI”,骗政府项目的补贴,脸都不红。连大模型最基本的幻觉问题都解决不了,谈什么可信?
做可信AI技术,最容易踩的几个坑
做可信AI技术,最容易踩的几个坑
第一个坑,就是为了可信牺牲模型性能。很多人做可信AI,觉得复杂模型不可信,那我换成简单的线性模型不就行了?结果可解释性是上去了,准确率掉了快十个点,这样的模型拿来能用吗?
现在真正做得好的可信AI,都是在不损失核心性能的前提下做可信增强。比如现在大火的检索增强生成,也就是大家说的RAG,本质就是给大模型加了一层可信锚点,所有生成内容都要先跟知识库的事实做对齐,大大降低了幻觉,生成能力几乎不受影响,这才是正确的思路。
第二个坑,就是把可信AI做成了纯合规项目,为了凑指标,不解决实际问题。比如说鲁棒性测试,很多公司只拿标准测试集测,分数好看得很,结果稍微改一点点输入,加个人类都看不出来的扰动,模型直接就判断错了,这样的可信有什么用?骗监管而已。
第三个坑,就是觉得可信AI只是合规部门的事,技术团队不用管。我接触过好几个大厂的AI团队,提起可信AI,都说这是合规组的活,我们只管把模型能力做上去。其实大错特错。AI越大,能力越强,出问题的代价就越大。前两年的大数据杀熟,今年层出不穷的AI换脸诈骗,哪一个不是AI不可信闹出的事?对吧?
OpenAI现在把对齐研究当成头号工程,核心不就是解决大模型的可信问题吗?国内现在大模型备案,可信能力是核心考察项,你连基本的输出真实性都保证不了,根本拿不到备案,连入场的资格都没有。
再过三年,AI肯定会渗进我们生活的每个角落。小到手机支付的身份核验,大到医院的手术方案制定,银行的授信审批,自动驾驶的行车决策,哪一步错得起?可信AI技术从来不是AI行业的锦上添花,是活下去的入场券。你说对不对?