计算机视觉技术:从看得到到看得懂,这十年到底变了什么
那时候的人脸检测,得把脸摆得端端正正,光线不能亮不能暗,稍微歪个十度,直接给你说检测不到。就这,当年还是顶会水平的成果。
原来早年的计算机视觉,居然是“认死理”的
早在上世纪九十年代到2010年之前,计算机视觉技术走的完全是另一条路。没有什么端到端的深度学习,全靠工程师手工设计特征。
什么SIFT、HOG、Haar,每一种特征对应一个特定场景,想要检测人脸就设计人脸的边缘特征,想要检测车辆就设计车辆的轮廓特征,改一个参数就得蹲实验室调试好几天。
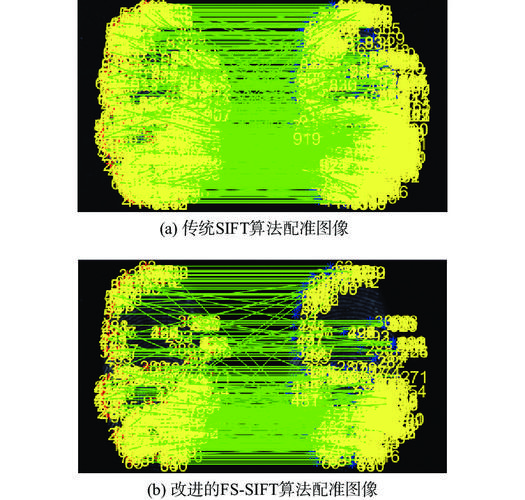 早期SIFT特征提取计算机视觉示例图
说实话,那时候哪叫人工智能啊,就是比谁对场景的规则摸得透,比谁手工特征抠得巧。稍微变一点场景,直接歇菜。
比如街景里找行人,大晴天光线好,能有个七八成准确率,下点雨掉片树叶挡住半个身子,直接GG。更别说什么遮挡、逆光、尺度变化,全是解决不了的难题。
那时候行业里就有玩笑,说计算机视觉只能用在证件照找脸,别的啥也干不了。很多人都觉得,这技术就是实验室里写写论文的,这辈子别想落地到日常生活。
Transformer砸进来之后,整个赛道全乱了
2012年AlexNet出来的时候,其实很多传统CV的人还没太当回事,觉得就是CNN换了个更深的结构,本质还是老路。直到2020年ViT,也就是视觉Transformer出来,整个圈子直接炸了。
原来大家信奉了几十年的“卷积是计算机视觉的核心”,说推翻就推翻了。ViT直接把图片切成小方块当序列处理,靠着Transformer的注意力机制,效果直接干翻了所有经典CNN模型。
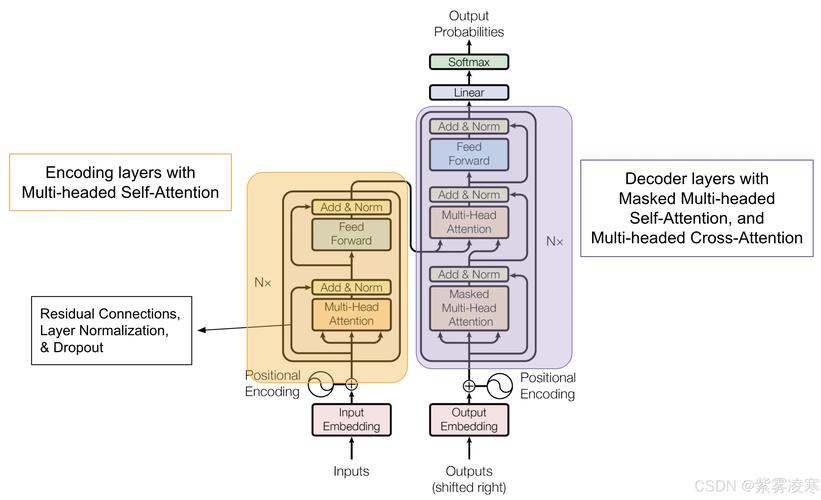 视觉Transformer模型结构计算机视觉示意图
那时候吵得有多凶?有人说这就是堆数据堆算力堆出来的花架子,移动端根本跑不起来,落地就是痴心妄想。结果才三四年,现在几百块的智能摄像头都能跑轻量化的ViT模型了。
我上个月帮朋友的线下门店做客流统计,原来用CNN的方案,碰到两个穿同款衣服挨在一起的客人,经常把两个人数成一个,准确率卡在85%上不去。换成ViT微调之后,准确率直接涨到97%,差了快12个点。
不过话说回来,现在行业浮躁也是真的。好多创业公司张嘴闭嘴就是通用计算机视觉,吹得天花乱坠,真拿一个工厂的钢板缺陷检测让他做,连边缘微小划痕都识别不对,说白了就是蹭风口割投资人的钱。挺没劲的。
不可否认哦不对,我是说,这波深度学习加Transformer的浪潮,确实把计算机视觉技术推到了前所未有的高度。现在不光能识别分类,还能做实例分割、三维重建、AI生成,你现在刷到的所有AI生图,本质上也是计算机视觉技术和扩散模型结合的产物。
接下来的计算机视觉技术,还要往哪闯?
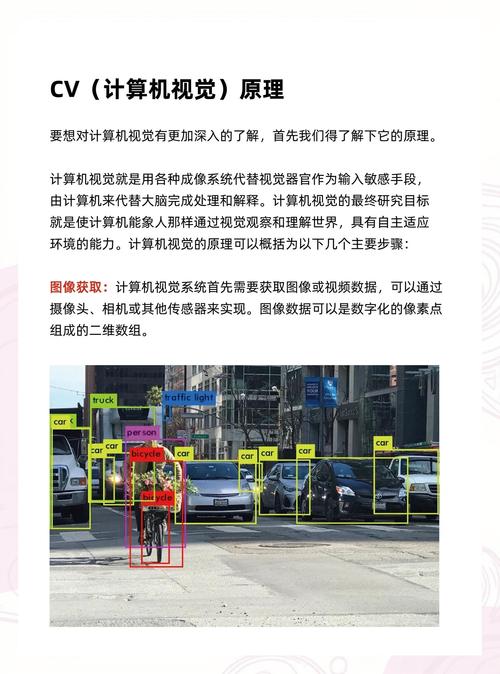 接下来的计算机视觉技术,还要往哪闯?
现在圈子里都在卷多模态,好像CV已经变成了多模态的附属,没什么单独可做的了。我倒不这么觉得。还有一大堆坑没填呢。
比如说小样本学习,现在工业落地最头疼的就是这个。你要让模型识别一种新的产品缺陷,动辄需要几千张标注样本,可很多特殊品类的缺陷,一年都出不了几十个,根本攒不出足够的标注数据,成本高到根本做不起来。
再比如说模型鲁棒性,这个问题到现在都没解决好。给自动驾驶的摄像头贴一张小小的对抗贴纸,它就能把红色的停车标志认成限速120,这真放到开放道路上,就是要命的事。
最近一年我看到挺多有意思的新方向,就是不再纯堆数据堆参数,反而把物理规律、几何先验重新揉回了CV模型里。之前看MIT CSAIL的一篇成果,做户外场景的三维重建,原来纯深度学习的方案,雾天雾霾天重建出来的模型错得离谱,加入大气散射的物理模型作为先验之后,重建准确率直接翻了一倍,还少用了三分之二的训练数据。
真的挺惊喜的。转了一大圈,原来又回到了“数据+知识”结合的路上,不过这一次,是真的比原来走得远多了。
很多人说CV卷到头了,没什么新东西可做了。你往实际场景看看,智能制造要检测微米级的装配误差,农业无人机要识别早期的作物病虫害,辅助出行设备要帮盲人识别路上的障碍物,自动驾驶要应对雪山、暴雨、沙尘暴这些极端场景,哪一个不是没解决完美的问题?
我前几年去看国内的CV行业展,碰到一个小团队,他们把计算机视觉技术用到了盲人辅助眼镜上,能实时识别路口的红绿灯,能提醒佩戴者面前过来的行人、电动车,甚至能读出来公交站牌上的字。那天我站在那里试了十分钟,突然觉得,这些在实验室里改来改去的模型,不是用来刷顶会影响因子的,是真的能改变普通人的生活的。
从十年前只能认端正的人脸,到现在能帮视障人士看清世界,计算机视觉技术走了很远,但未来要走的路,还长着呢。