语音识别技术:从只能听懂指令到接住你的方言梗
上个月跟奶奶视频,输入法随手开了语音转写,居然把奶奶一口带卷舌的温州乐清方言“晚上要不要吃糯米饭”,整句转对了。我当时惊得手机差点掉饭碗里。
放十五年前,这根本是天方夜谭。对吧?
十年前的语音识别,还得你来适应机器
我还记得2010年那会,第一次用带语音拨号的诺基亚,对着说明书录了三遍“爸爸”,换了个声调打过去,它居然给我拨给了“巴巴”——就是我存的淘宝店铺巴巴运动网。
那时候的语音识别,本质就是模板匹配+统计模型,先把你的声音拆成一个个音素,跟提前存好的模板对上,差一点都认不出来。后来用GMM-HMM模型好了一点,但还是得你慢慢说,字正腔圆,不能有口音,不能有背景噪音。
那时候想去做方言识别?想都别想,连标注数据都凑不出来。整个行业都在纠结,怎么把普通话的准确率从90%提到95%,哪有空管小众的需求。
 2010年智能手机语音拨号功能界面图
说实话,那时候的语音识别,更像是个炫技的功能,没人真的天天用。发语音还是得自己打字,开会记录还是得找速记员。
Transformer进场,语音识别才真正“活”了
Transformer出来之后,整个方向全变了。端到端模型直接把语音转文字,跳过了中间繁琐的音素对齐步骤,一下子把准确率拉上去不说,对数据的利用效率也高了太多。
2022年OpenAI把Whisper开源的时候,整个行业都炸开了。我当时下载下来试了,把大学时候录的山区支教的音频找出来,背景有鸟叫还有风声,当地人说的一口贵州苗语夹杂普通话,Whisper居然转了个七七八八。我当时对着电脑愣了半天。
现在业内最热的方向,是低资源语音识别。什么概念?就是针对那些没有几十万上百万标注数据的小语种、小众方言,靠大模型预训练的能力,把高资源语言的知识迁移过来,只需要几千句甚至几百句标注数据,就能训出能用的模型。
这个方向真的太有意义了。国内很多少数民族语言,很多地方的小众方言,现在都能做语音识别了,不光方便当地人,对文化记录保护都是大功一件。
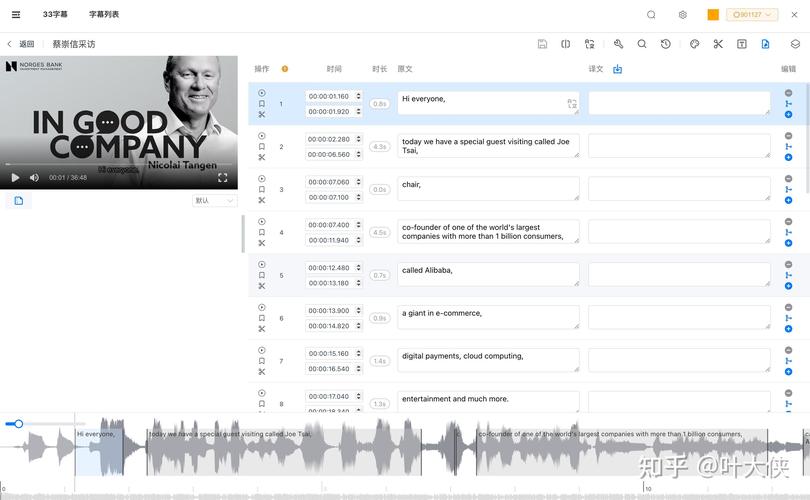 OpenAI Whisper多语言语音识别支持列表截图
现在通用场景下的普通话语音识别,准确率已经超过98%了,跟人打字的错误率差不多。你说惊喜不惊喜?
语音识别技术现在,卷到什么地方了?
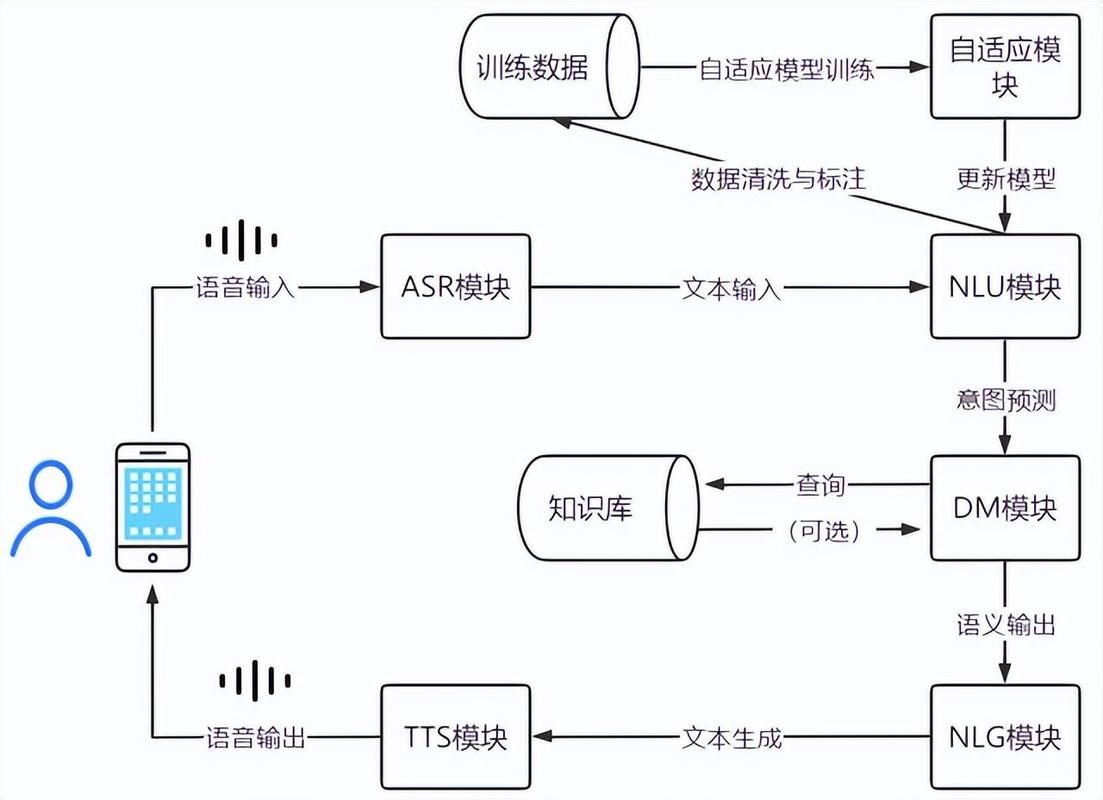 语音识别技术现在,卷到什么地方了?
准确率卷得差不多了,现在大家都在卷什么?
第一个是场景适配。别小看这个,你在安静的房间里说话准确率99%,到地铁站那种嘈杂的地方,很多产品直接就瞎了。还有手术室里医生小声说专业术语,战场上士兵带面罩说话,都得专门调模型,不是拿个通用大模型就能用的。
第二个是跟大语言模型结合。现在的语音识别早就不是只给你转文字了。你开会说“王工负责的那个项目,下周五要交原型稿”,转完之后直接能帮你提取成待办,打上标签,分到王工的日程里。边说边处理,不用事后再整理。
第三个是端侧化。说白了就是不用把你的语音传到云端处理,全部运算都在你自己的手机、手表里跑。既解决了延迟问题,又保护了隐私。现在小米、谷歌都推出了可用的端侧语音识别模型,准确率跟云端差不了多少,日常用完全够。
不过话说回来,现在的产品还是有不少槽点。我前阵子打银行客服,反复说“转人工”,它硬给我转成“查询余额”,来回折腾五分钟,差点把我手机扔了。其实根本不是技术做不到,是很多企业为了省成本,不肯用新模型,不肯针对场景做优化,硬拿几年前的老模型凑活用,坑的还是用户。
还有同音异义的问题,现在很多模型还是搞不对。你说“我要去买一瓶啤酒”,上下文说跟朋友吃饭,它能转对,要是你半路插一句,它可能给你转成“皮九”,这种低级错误还是时常出现。不过最近看arXiv上的新成果,结合上下文的语义语音识别已经把这个问题解决得七七八八了,估计再过两年,这种错误就很少见了。
你有没有发现,我们早就已经离不开语音识别了。发微信懒得打字,开语音转文字,开车导航说个地址就走,开会不用带速记,自动出字幕,甚至写稿子都有人直接说,转完改改就成了。
对那些听障朋友来说,实时语音转字幕更是帮了大忙,能跟上正常人聊天,能自己去超市买东西,不用麻烦别人。技术的温度,其实就藏在这些不起眼的地方。
再过三五年,估计语音识别就能真的做到跟人耳一样,什么口音什么环境,都能听得明明白白。到那时候,我们跟机器的交互,真的就跟跟人聊天一样了。