自然语言处理:从实验室走到日常的隐形技术
你以为NLP是遥不可及的黑科技?其实你每天都在使唤它
前阵子刷短视频刷到一个卖海鲜的东北大叔,一口大碴子味,自动字幕居然准确率能到九成八,我当时就惊了。换十年前,哪里能想到机器能听懂这么接地气的口语?
那时候我刚接触NLP,实验室里处理语料,全是人工标,标一句"我买苹果"还要标注是吃的苹果还是电子产品,累死个人,识别准确率能到六成就能发论文。
现在呢?你对着手机说再绕口的梗,它都能给你转对。
 手机端自然语言处理语音转文字应用界面
说实话,我帮出版社整理过旧书扫描版的电子化,原来要一个字一个字敲,现在用OCR加NLP纠错,一天就能弄完一本十万字的书。省了多少人力?
还有大家深恶痛绝的垃圾短信,现在能自动帮你拦在垃圾桶里,靠的也是NLP识别垃圾语义,不是原来那套死板的关键词规则。你发"中奖"正规活动短信不会被拦,骗子发"领奖"直接给你挡掉,这就是NLP的进步。
当然也有翻车的时候。上次我点奶茶,说"要三分糖少冰",智能客服给我做成全糖去冰。给我气的,当场就给了差评——这就是模型训练的时候没吃透本地奶茶店的常用说法,数据没喂够罢了。
最近两年顶会里的真干货,其实不是千亿大模型套壳
现在打开创投圈的新闻,十个AI项目九个说自己做垂直大模型,扒开底裤一看,不就是拿 Llama 或者通义千问的开源模型改改prompt,套个行业壳就敢卖几百万。
割韭菜罢了。
说实话,真的科研成果,最近两年NLP圈最有实际价值的,是低资源小参数NLP模型和领域知识语义对齐这两个方向。去年ACL顶会上有一篇成果,针对国内小众方言和小语种,不用动辄几千张卡训几个月,只需要不到一千小时的标注语料,就能把语义识别准确率拉到92%以上,比原来的方法提升了快15个点。
 ACL顶会自然语言处理学术论文展示海报
这个成果有多实用?我上个月参加一个非遗保护的沙龙,有个团队做浙南畲语的数字化保护,原来找学生标语料,标了大半年才攒够能用的数据集,花了二十多万。用这个新方法,不到两周就搞定了,成本才一万多。
不只是保护方言,很多细分行业都缺标注数据啊。比如说做煤矿的运维日志识别,哪里去找那么多标注好的语料?矿工说的都是"机头响""底板滑"这种行话,外面的标注员根本听不懂。低资源NLP就能解决这个问题,用少量数据就能训出能用的模型。
不过话说回来,现在资本就爱炒大模型概念,说我这个参数多少多少亿,能写论文能写代码,听得投资人热血沸腾就投钱。没人愿意理这种小而美解决实际问题的方向,真的挺遗憾。
NLP接下来的方向,其实要往下沉,不是往上堆
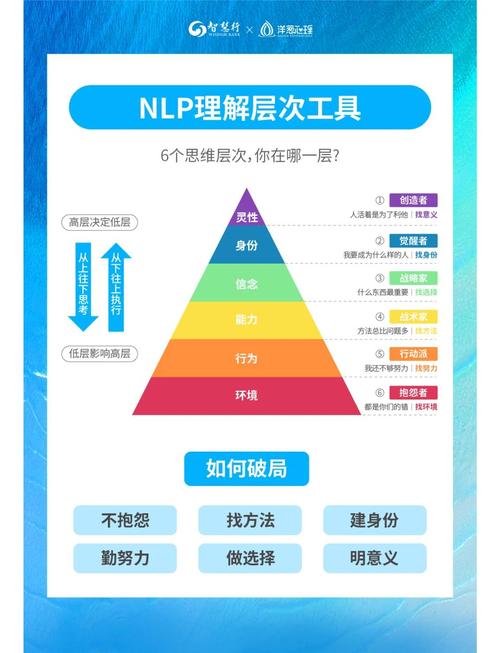 NLP接下来的方向,其实要往下沉,不是往上堆
我接触过不少行业客户,没人关心你模型参数有多大,人家只关心能不能解决我的问题,成本够不够低,推理够不够快。
上个月有个做律所数字化的朋友找我聊,他们原来用GPT4做合同信息抽取,抽一份合同要两块钱,慢不说,还担心数据泄露。后来他们用7B参数的小模型,拿一百万份真实合同微调,现在抽合同里的标的额、违约条款、管辖法院,准确率比GPT4还高两个百分点,抽一份才不到一分钱。
这才是行业真需要的NLP啊。垂直领域轻量化,比通用大模型值钱一百倍。
还有一个方向我特别看好,就是NLP和认知科学结合。现在的大模型都是靠统计语料里的词频概率生成内容,它根本不知道语言背后的常识。你说"把大象放进冰箱分几步",它能背出标准答案,但它不知道大象多大冰箱多大,为什么放不进去。真的要让NLP不犯低级错误,就得把人类的认知常识嵌进去,让模型不是猜下一个词是什么,而是真的懂这句话说的是什么意思。
现在很多人天天喊AGI,喊通用人工智能,喊着几年就要颠覆世界。我反倒觉得,先把工厂里的运维日志识别对,把方言保护的成本降下来,把中小企业用得起的合同模型做出来,比什么都强。
路要一步一步走,饭要一口一口吃。
急什么。