强化学习技术:从实验室游戏到产业落地的隐形突破
前年帮一家无人仓做路径规划项目,聊到一半甲方技术负责人拍桌子说,试过深度学习,试过遗传算法,就是搞不定动态仓储的拣货路径,一碰突发的临时补货就乱成狗。最后换了强化学习技术调了俩月,运营成本直接降了30%。
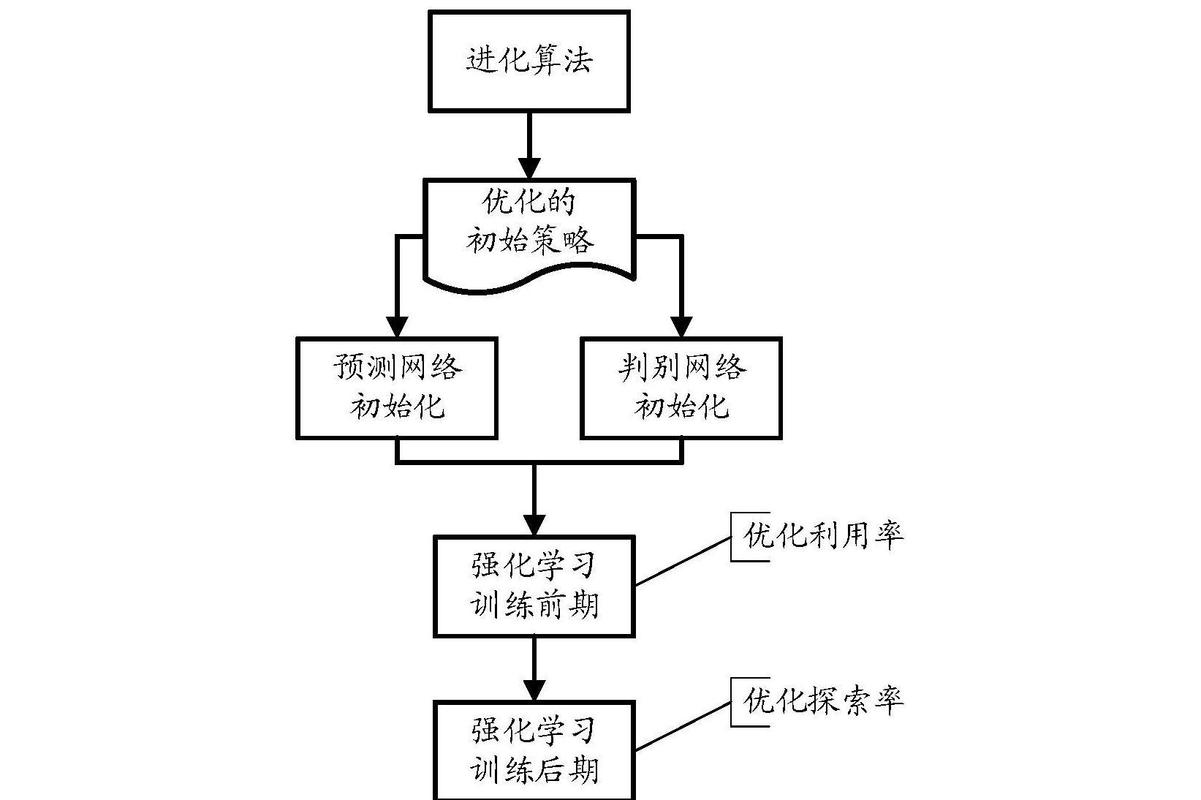 强化学习试错训练流程示意图
说穿了,和我们人类小孩学走路一模一样。摔了疼(惩罚),走到目的地有夸奖(奖励),摔个几十次自然就走稳了,哪有那么多玄乎的概念?
不少人刚入门就被一堆马尔可夫决策过程的公式给唬住,觉得这东西门槛高得离谱,其实剥掉公式的外衣,核心逻辑就是这么简单。
不过话说回来,现在很多自媒体把它吹得天花乱坠,好像什么问题都能解决。放屁,它天生就带缺陷。最大的问题就是试错成本太高,想要训出一个靠谱的模型,得千百万次的试错,换成很多真实场景,根本耗不起。总不能让自动驾驶真撞几千次车来训模型吧?
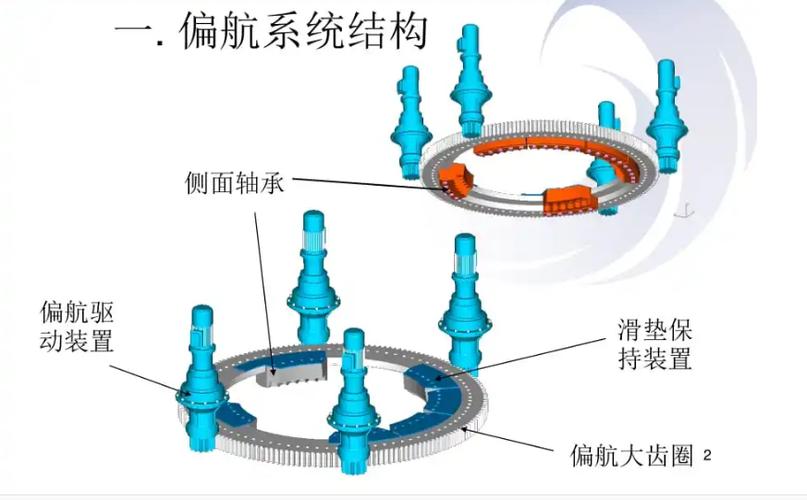 风电场风机偏航角强化学习优化示意图
还有我接触的无人仓拣货,原来的路径都是固定规则算出来的,一旦某个货架被临时补货占用,或者插进来一个紧急订单,系统就得重新卡半天,出来的路径还绕远。强化学习训好之后,遇到任何突发情况,半秒就能出最优路径,效率提升真的肉眼可见。
当然,也不是什么场景都适合硬上。我见过一个创业者拿强化学习去做电商推荐,烧了大半年算力钱,最终效果还不如传统的协同过滤,钱烧完了公司也没了,别提多懊恼了。
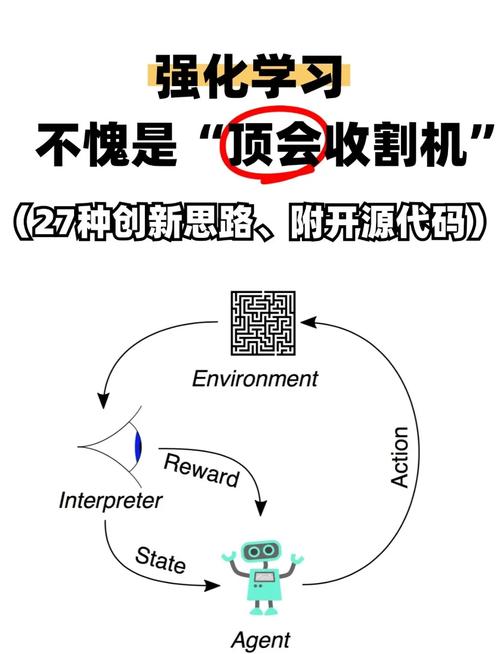 强化学习技术接下来的坑,和藏着的大机会
现在行业里公认的最大的坑,还是样本效率太低,说白了还是试错成本的老问题。训一个工业级能用的模型,动辄上千万次迭代,就算放在虚拟仿真里训,那算力成本也不是中小公司能扛得起的。
这两年火起来的离线强化学习,其实就是冲着解决这个问题来的。不用实时在线试错,直接用之前收集好的海量历史数据来训练,一下子把成本砍了一大半,现在已经有不少创业公司靠着这个切了好多工业场景,活得还不错。
另一个坑就是泛化性差。在A仓库训好的路径规划模型,换去布局不一样的B仓库,基本上就得重新训,这点灵活性还不如传统的算法,改一改规则就能用。这个问题现在也还没找到完美的解法,还在研究阶段。
那机会在哪?我最看好的两个方向,一个是和大模型的深度结合。除了已经用开的RLHF,大模型本身现在就是一个超强的低成本环境模拟器。原来做工业场景的训练仿真,搭个引擎就得三五个月,花几百万,现在用大模型生成模拟环境,几天就能搞定,直接给强化学习降了准入门槛,这个进展真的太快了。
另一个就是服务机器人。现在国内好多做家用机器人、灵巧手的团队,都在往强化学习上砸钱。原来教机器人抓一个没见过的物体,工程师得写好半天规则,力度大了捏碎,力度小了掉,换个形状就得重新调。现在用强化学习训,机器人自己试错几十次,就能摸清楚调整力度的规律,哪怕是没见过的不规则物体,也能抓得稳稳的。我上周和一个做机器人的朋友吃饭,他给我看演示的时候,我真的被惊艳到了。
所有真实世界都是动态的,永远充满不确定性,规则写死的算法,永远应付不了没完没了的变化。只有能自己试错、自己进化的强化学习,才能真的适配这个乱七八糟的真实世界。
现在所有人都盯着大模型的风口挤破头,其实强化学习才是那个藏在背后的隐形冠军,好多卡了好几年的落地难题,最后估计都得靠它来破局。
多数人对强化学习技术的误解,从一开始就错了
很多人提起强化学习,第一反应就是阿尔法狗下围棋,是近十年才火起来的新玩法。其实早在上世纪五十年代,相关的理论框架就已经提出来了。对吧? 它和我们常说的监督学习、无监督学习,核心逻辑完全不一样。监督学习是喂给你海量标准答案让你背,考的是记忆力;强化学习是扔你到一个未知环境里,自己摸爬滚打试错,做对了给糖做错了打板子,玩得多了自然就找到最优解法。强化学习试错训练流程示意图
说穿了,和我们人类小孩学走路一模一样。摔了疼(惩罚),走到目的地有夸奖(奖励),摔个几十次自然就走稳了,哪有那么多玄乎的概念?
不少人刚入门就被一堆马尔可夫决策过程的公式给唬住,觉得这东西门槛高得离谱,其实剥掉公式的外衣,核心逻辑就是这么简单。
不过话说回来,现在很多自媒体把它吹得天花乱坠,好像什么问题都能解决。放屁,它天生就带缺陷。最大的问题就是试错成本太高,想要训出一个靠谱的模型,得千百万次的试错,换成很多真实场景,根本耗不起。总不能让自动驾驶真撞几千次车来训模型吧?
这两年强化学习技术最让人惊喜的产业落地
说实话,我最早对强化学习的印象,还停留在实验室里打游戏。反正虚拟世界试错不要钱,阿尔法狗赢李世石,OpenAI打职业DOTA,都是炫技一样的存在,离普通人很远。 这两年不一样了,越来越多落地的跑通项目冒出来,不少都直接改变了我们每天用到的产品。 最典型的就是现在所有大模型都在用的RLHF,也就是基于人类反馈的强化学习。你以为现在ChatGPT、国产大模型能那么懂人话,都是预训练的功劳?不对,预训练完的大模型就是个会背书的书呆子,说话容易歪,经常答非所问,甚至会跟你抬杠。就是靠强化学习,用人类给的反馈做奖励信号调优,才把大模型掰回了人类喜欢的轨道上。你现在用着顺手,一半功劳要算给强化学习技术。 另一个让我惊讶的是新能源领域的落地。去年看国内电网团队发的成果,风电场的风机发电效率优化,原来风机的偏航角都是设计的时候定死的,前排风机转起来会产生尾流,后排风机受风就不均匀,平白浪费好多风能。用强化学习动态调整每台风机的角度,遇到不同风向风速都能实时调整,整体发电量直接提了5%以上。什么概念?一个百万千瓦的风电场,一年就是多赚大几千万的真金白银。风电场风机偏航角强化学习优化示意图
还有我接触的无人仓拣货,原来的路径都是固定规则算出来的,一旦某个货架被临时补货占用,或者插进来一个紧急订单,系统就得重新卡半天,出来的路径还绕远。强化学习训好之后,遇到任何突发情况,半秒就能出最优路径,效率提升真的肉眼可见。
当然,也不是什么场景都适合硬上。我见过一个创业者拿强化学习去做电商推荐,烧了大半年算力钱,最终效果还不如传统的协同过滤,钱烧完了公司也没了,别提多懊恼了。
强化学习技术接下来的坑,和藏着的大机会
强化学习技术接下来的坑,和藏着的大机会
现在行业里公认的最大的坑,还是样本效率太低,说白了还是试错成本的老问题。训一个工业级能用的模型,动辄上千万次迭代,就算放在虚拟仿真里训,那算力成本也不是中小公司能扛得起的。
这两年火起来的离线强化学习,其实就是冲着解决这个问题来的。不用实时在线试错,直接用之前收集好的海量历史数据来训练,一下子把成本砍了一大半,现在已经有不少创业公司靠着这个切了好多工业场景,活得还不错。
另一个坑就是泛化性差。在A仓库训好的路径规划模型,换去布局不一样的B仓库,基本上就得重新训,这点灵活性还不如传统的算法,改一改规则就能用。这个问题现在也还没找到完美的解法,还在研究阶段。
那机会在哪?我最看好的两个方向,一个是和大模型的深度结合。除了已经用开的RLHF,大模型本身现在就是一个超强的低成本环境模拟器。原来做工业场景的训练仿真,搭个引擎就得三五个月,花几百万,现在用大模型生成模拟环境,几天就能搞定,直接给强化学习降了准入门槛,这个进展真的太快了。
另一个就是服务机器人。现在国内好多做家用机器人、灵巧手的团队,都在往强化学习上砸钱。原来教机器人抓一个没见过的物体,工程师得写好半天规则,力度大了捏碎,力度小了掉,换个形状就得重新调。现在用强化学习训,机器人自己试错几十次,就能摸清楚调整力度的规律,哪怕是没见过的不规则物体,也能抓得稳稳的。我上周和一个做机器人的朋友吃饭,他给我看演示的时候,我真的被惊艳到了。
所有真实世界都是动态的,永远充满不确定性,规则写死的算法,永远应付不了没完没了的变化。只有能自己试错、自己进化的强化学习,才能真的适配这个乱七八糟的真实世界。
现在所有人都盯着大模型的风口挤破头,其实强化学习才是那个藏在背后的隐形冠军,好多卡了好几年的落地难题,最后估计都得靠它来破局。