深度学习技术:藏顶流光环下,不为人知的行业新变化
上周刷NeurIPS 2024的接收论文列表,翻到一半差点把冰美式撒键盘上。
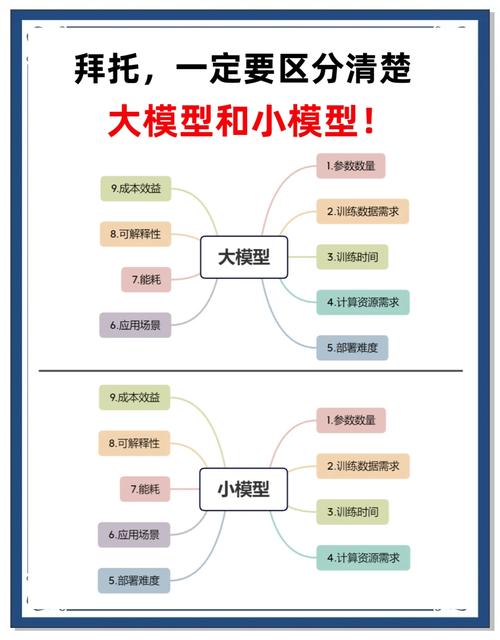 2024深度学习大小模型性能成本对比图
说实话,现在圈子里很多人都心里有数,那些喊着大力出奇迹的,大多是为了融资讲故事,真要落地,谁傻谁堆参数。
 神经符号融合深度学习推理架构图
不过话说回来,这不就是技术发展的正常规律吗?早些年深度学习刚出来,大家觉得这玩意儿能解决一切,把过去的东西全扔了,结果走了几年才发现,原来老方法里有好多宝贝。比如我们做医疗影像分析,现在好多做的好的团队,都会把放射科医生总结的影像特征,揉进深度学习模型里,比纯端到端训练的模型,准确率高不说,还更容易解释,医生也敢用。
我之前跟一个做临床AI的创始人聊天,他说他们最开始就是纯端到端,结果出来的模型,哪里出问题都不知道,出一次误判的投诉就够头疼,后来加了人工规则约束,稳多了。对吧?
 普通人玩深度学习,现在还有机会吗?
最近半年,好多学生和刚入行的小朋友问我,现在深度学习都是大厂玩的,千亿大模型我们碰都碰不起,是不是根本没机会了?
我每次都告诉他们,错了,机会比之前还多。原来堆参数堆卡的时候,门槛确实在钱那里,你没有几个亿买卡,根本玩不起,现在不一样了。我认识一个普通二本的本科生,今年发了篇ACL的短文,做的是中文小模型的推理加速,就是改了一下剪枝的策略,没用什么大算力,整个实验下来,GPU租费花了不到一千八百块,就做出来了。
现在国内创业圈做垂直领域AI的,十有八九都是用小模型,根本不碰千亿大模型。你懂某个垂直领域,能挖到干净的领域数据,知道用户真正的痛点是什么,比你有一堆卡有用多了。我上个月见了一个做农业AI的团队,一共才五个人,做出来的病虫害识别模型,比大厂做的还好用,为什么?因为他们自己去田间地头拍了三万多张真实的病虫害照片,不是用网上爬的那种库存图,模型参数才几十M,装到农民的旧手机里都能跑,一年卖软件卖了几百万。
说白了,深度学习技术只是个工具,不是用来炫富的。你能解决问题,就有价值。
现在网上到处都是AI焦虑,一会儿说大模型要取代所有人,一会儿说只有大厂能玩AI。其实静下心翻一翻最新的论文就知道,整个行业正在从疯狂堆料,回归到解决问题的本质。那些被我们扔到垃圾堆的老思路,一个接一个的又回来了。那些只想着堆参数讲故事的公司,慢慢也撑不下去了。
你要是真喜欢这个方向,不用怕没资源,找个小问题,沉下心挖,说不定就能做出有意思的东西。对吧。
大力出奇迹的神话,正在被打破
从Transformer出来之后,整个圈子都疯了,堆参数,堆数据,堆卡,仿佛谁的模型参数多一个零,谁就是行业老大。我前两年参加行业峰会,台上的人开口闭口都是千亿参数,好像不做千亿大模型,就不配叫做深度学习。结果呢?这两年出来的一堆论文,脸都打肿了。参数规模早就不是决定性能的第一要素了。去年斯坦福那帮人做的实验,同样是做通用文本理解,13B参数的微调小模型,效果比175B的GPT-3还强,训练成本只有不到十分之一。 我自己就踩过这个坑。之前帮朋友做工业零件表面缺陷检测,一开始脑子发热跟风,上来就租A100调10B的大模型,跑了三天三夜才收敛,推理速度慢到生产线根本等不及,成本直接超了预算三倍。后来听了一个干了三十年的老工程师劝,换成不到1B参数的蒸馏小模型,专门挑了一万多张标注清晰的正负样本,删掉了两万多张模糊凑数的垃圾数据,重新训练之后,准确率反而涨了两个点,推理速度翻了二十倍,成本直接砍到原来的十分之一。 太打脸了。2024深度学习大小模型性能成本对比图
说实话,现在圈子里很多人都心里有数,那些喊着大力出奇迹的,大多是为了融资讲故事,真要落地,谁傻谁堆参数。
被淘汰的老方法,居然又火回来了
我刚入行的时候,导师就跟我说,深度学习就是端到端,不需要人工设计规则,不需要符号推理,那些都是上世纪淘汰的老东西。结果这两年,神经符号融合的深度学习技术直接杀回顶流,一堆顶刊顶会的论文往出冒。 之前大模型最让人吐槽的就是做逻辑推理,做数学题,十道错五道,你跟它说半天,它还是转不过弯。DeepMind今年发的新论文,把符号推理模块直接嵌到大模型的中间层,让模型先把问题拆解成符号逻辑步骤,再做计算,复杂数学题的错误率直接降了42%,而且完全不需要额外堆参数。我翻完那篇论文,对着屏幕愣了五分钟。 绕了一大圈,原来我们又回到起点了?神经符号融合深度学习推理架构图
不过话说回来,这不就是技术发展的正常规律吗?早些年深度学习刚出来,大家觉得这玩意儿能解决一切,把过去的东西全扔了,结果走了几年才发现,原来老方法里有好多宝贝。比如我们做医疗影像分析,现在好多做的好的团队,都会把放射科医生总结的影像特征,揉进深度学习模型里,比纯端到端训练的模型,准确率高不说,还更容易解释,医生也敢用。
我之前跟一个做临床AI的创始人聊天,他说他们最开始就是纯端到端,结果出来的模型,哪里出问题都不知道,出一次误判的投诉就够头疼,后来加了人工规则约束,稳多了。对吧?
普通人玩深度学习,现在还有机会吗?
普通人玩深度学习,现在还有机会吗?
最近半年,好多学生和刚入行的小朋友问我,现在深度学习都是大厂玩的,千亿大模型我们碰都碰不起,是不是根本没机会了?
我每次都告诉他们,错了,机会比之前还多。原来堆参数堆卡的时候,门槛确实在钱那里,你没有几个亿买卡,根本玩不起,现在不一样了。我认识一个普通二本的本科生,今年发了篇ACL的短文,做的是中文小模型的推理加速,就是改了一下剪枝的策略,没用什么大算力,整个实验下来,GPU租费花了不到一千八百块,就做出来了。
现在国内创业圈做垂直领域AI的,十有八九都是用小模型,根本不碰千亿大模型。你懂某个垂直领域,能挖到干净的领域数据,知道用户真正的痛点是什么,比你有一堆卡有用多了。我上个月见了一个做农业AI的团队,一共才五个人,做出来的病虫害识别模型,比大厂做的还好用,为什么?因为他们自己去田间地头拍了三万多张真实的病虫害照片,不是用网上爬的那种库存图,模型参数才几十M,装到农民的旧手机里都能跑,一年卖软件卖了几百万。
说白了,深度学习技术只是个工具,不是用来炫富的。你能解决问题,就有价值。
现在网上到处都是AI焦虑,一会儿说大模型要取代所有人,一会儿说只有大厂能玩AI。其实静下心翻一翻最新的论文就知道,整个行业正在从疯狂堆料,回归到解决问题的本质。那些被我们扔到垃圾堆的老思路,一个接一个的又回来了。那些只想着堆参数讲故事的公司,慢慢也撑不下去了。
你要是真喜欢这个方向,不用怕没资源,找个小问题,沉下心挖,说不定就能做出有意思的东西。对吧。