知识图谱构建:从论文到落地踩过的那些真实坑
很多人对着开源教程搭知识图谱,搭完才发现啥用都没有。上个月帮朋友改一个企业项目,他花了三个月爬数据灌进去,跑出来的关联推荐还没Excel手工分类好用。
哭丧个脸跟我说,网上说的知识图谱那么神,怎么到我这就成了占存储空间的垃圾?
其实哪是知识图谱不行,是构建的时候从根上就错了。
别上来就堆数据,schema设计才是核心骨架
新手最容易犯的错,就是打开爬虫先爬十万条数据再说,schema随便列几个分类就完事儿。说实话,这一步错了,后面花多少力气都救不回来。
什么是schema?就是你知识图谱的实体分类和关系规则,相当于盖房子的钢筋骨架,骨架歪了,砖堆得再多也得塌。
举个例子,做金融风控的知识图谱,有人把“企业”“法人”分成两个实体就满足了,可你有没有想过,法人会代持股份、会兼职多家企业、会和其他企业实控人有亲属关系?这些关系没提前写到schema里,后续你要挖关联风险的时候,根本挖不出来。
之前有个本科生找我看毕设,为了显得工作量大,一口气列了30多个实体类,20多种关系,结果爬下来的数据一半不符合规则,灌不进去,剩下灌进去的全是脏数据,改都没法改,临近答辩天天熬夜返工,何苦呢?
好的schema从来不是堆出来的,是对着你要解决的问题倒推出来的。你要做小说人物关系图谱,只需要“人物”“作品”“事件”三个实体,关系就留“亲属”“敌对”“盟友”足够了,多一个都是累赘。
 电商知识图谱schema设计示例图
不信你去看大厂落地的知识图谱,核心schema也就几十种,哪有动辄上百种的,那不叫专业,那叫炫技。
实体对齐:最磨人也最容易被忽略的脏数据环节
schema搭对了,下一个坑就是实体对齐。我敢说,90%的开源教程都一笔带过这个环节,可实际做项目的时候,这个环节要占你一半以上的时间。
什么是实体对齐?说白了就是把指向同一个东西的不同叫法,合并成一个。比如“腾讯”,有人叫“腾讯控股”,有人叫“深圳腾讯计算机”,还有输入错误打成“腾迅”,这些其实都是同一家公司,你要是当成三个不同实体放进去,知识图谱就全乱了。
我之前做一个政企项目,一万多家中小企业的实体数据,前前后后调了三周的匹配规则,最后还是留了两千多条给标注员人工核对,你说麻烦吧?真麻烦。但你要是跳过这一步,最后出来的关联结果全错,用户用一次就不会再用了。
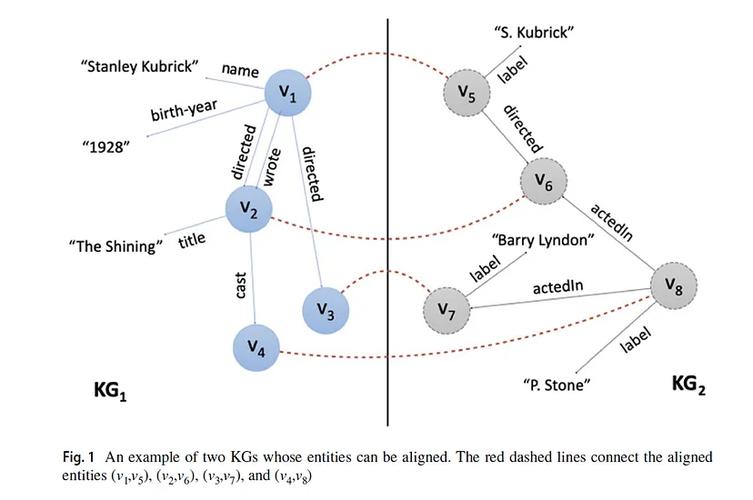 知识图谱实体对齐错误样例对比图
现在很多人说大模型能自动搞定实体对齐,我试过不下十次,开放域随便做做还行,垂直领域根本不行。就说医疗领域的“二甲双胍”,有化学名,有十几个商品名,还有缩写,大模型经常把不同剂型的同一种药分成两个,把不同成分的同名药合在一起,错的离谱。
所以啊,别信什么全自动构建知识图谱的神话,实体对齐这一步,不管工具再怎么先进,多多少少都要人工介入校验,急不得。
大模型时代,知识图谱构建真的变简单了吗
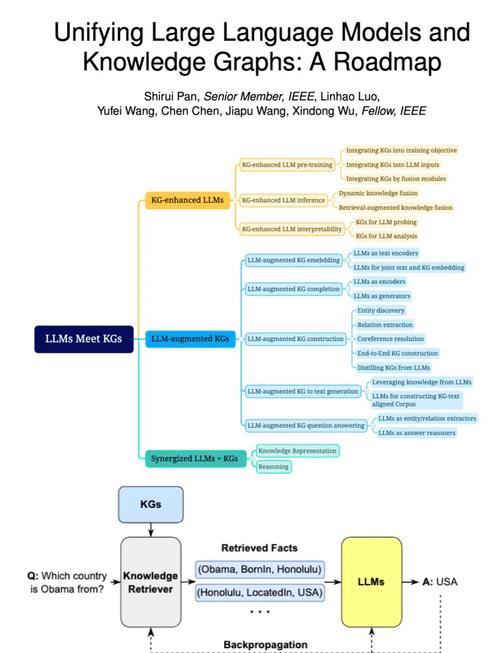 大模型时代,知识图谱构建真的变简单了吗
这两年大模型火了,到处都在说知识图谱要被淘汰了,还有人说大模型一句话就能生成知识图谱,不用自己搭了。
我就一句话:说这话的人,肯定没做过落地项目。
op>大模型确实给知识图谱构建省了不少事,原来要攒几千条标注数据训命名实体识别模型,现在大模型零样本就能抽,准确率还不低,原来要花半个月做的粗提取,现在一天就能做完。这是好事。
但大模型也带歪了一波新手,觉得知识图谱构建就是让大模型抽完实体连个边就完了,哪有这么简单。大模型会瞎编啊,编不存在的实体,编不存在的关系,你把这些错误内容灌进知识图谱,那就是垃圾进垃圾出,最后做出来的东西根本没法用。
现在业内真正落地的玩法,其实是大模型+传统构建流程结合:用大模型做粗提取,省人力,然后用规则做过滤,再用少量人工做校验,核心的schema还是要靠人对着需求设计,一点都偷不了懒。
op>我上个月看了国内几家大厂出的知识图谱构建工具,都是这个思路,把大模型嵌到流程里辅助人,不是替换人,原来三个月的活,现在两周就能做完,准确率还不降,这才是真的进步。
新手要是想练手知识图谱构建,我给你个建议:别上来就搞几亿实体的大项目,先找个小场景练手。比如你就做自己书架的知识图谱,先定schema:书、作者、出版社、标签,四个实体,三种关系,完了抽实体、对齐、入库,跑通一遍,你就知道哪里坑了,比你看十篇论文都有用。
真的,别上来就玩花活,知识图谱构建这活,拼的不是你有多少数据,是你有没有贴着问题做,每一步都踩实了。做出来能用,比什么都强。