语音识别技术:从实验室黑科技到日常标配的十年跃迁
上周帮我奶奶调智能手机输入法,她八十岁,眼睛花得连按键都看不清,这辈子没学过拼音,以前发消息只能让我叔替她打字。现在倒好,张嘴说话就出文字,连她一口带着山东乡下口音的普通话,十个字能对九个。换十五年前,你敢信?
早年的语音识别:只是特定人的玩具
我听行业里做了三十年的前辈说,九十年代国内搞语音识别的团队,没几个能拿出能用的产品。那时候主流还是用隐马尔可夫模型的统计方法,把语音切割成一个个小单元,再一个个匹配字典,稍微有一点口音或者环境杂音,直接全错。
那时候要能用,条件苛刻到离谱。你得在安静房间,得说话一字一顿,得提前给机器训练半小时你的声音。换个人说话,直接抓瞎。
 1990年代IBM语音识别实验室设备实拍
就算做到顶,也就支持几千个词汇量,也就做做专线电话的声控拨号,普通人根本碰不到。那时候科研论文里吹的“语音解放双手”,全是画饼,谁信谁上当。
说实话,直到2010年前后,我用早期的安卓手机试语音识别,说“我要吃火锅”,能给我转成“我要吃火车”,气得我直接把功能关了半年。
Transformer进场之后,语音识别彻底换了赛道
2017年Transformer出来之后,最先改变的其实是NLP,紧接着就炸了语音识别的圈子。之前大家折腾了几十年的三段式架构:声学模型、语言模型、解码器,改来改去识别率也就涨一点点,结果端到端一出来,直接把老路线干没了。
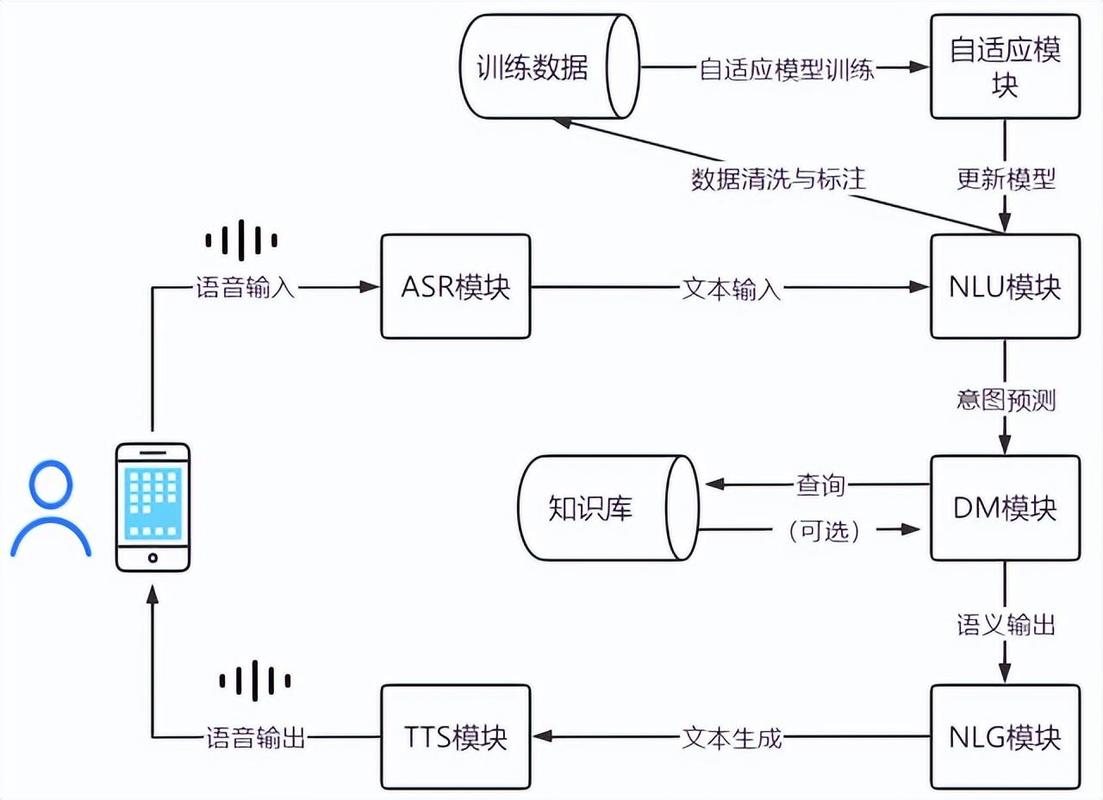 端到端语音识别技术处理流程示意图
什么是端到端?说白了就是不用拆那么多步骤,直接把原始语音信号喂给模型,模型直接输出文字,省了无数中间调参的麻烦。现在通用场景下,普通话识别准确率已经做到了98%以上,这个准确率,普通人日常用完全够打了。
不光普通话,现在方言识别都做得有模有样。我上次跟我广东朋友聊天,他一口懒音粤语,微信转写比我听的都准。连我那一口改不掉的湖南塑普,十个字能对九个,放十年前想都不敢想。
不过话说回来,也不是完美无缺。你在酒吧闹哄哄的环境打电话,转写能错一半。要是感冒嗓子哑了,变声了,机器也认不出来。碰到专业术语更离谱,我上次说“Transformer编码器”,能给我转成“变身编码器”,笑了我一整天。
语音识别技术现在偷偷藏在了哪里
 语音识别技术现在偷偷藏在了哪里
很多人觉得,语音识别不就是输入法转文字吗?那你可太浅了。现在这东西早就渗透到各行各业了。
快递网点的分拣,快递员扫件直接报地址,不用停下来打字,一分钟能多扫好几个件,一天下来能多送几十单。医院里面,医生做完手术,口述病历直接转文字,不用熬大夜补病历,这真的是救人的改进。就连果园里摘果子,果农带着耳麦报果重,直接录入系统,不用放下果子手写登记,效率翻了一倍。
最近大模型火了之后,语音识别又玩出新花样了。原来只是转文字,现在转完直接给你做结构化整理。你开三个小时会,录完音十分钟就能给你出分点的会议纪要,连待办事项都给你标好,省了不知道多少整理的时间。我上个月出差开研讨会,亲测了一次,本来要花一下午整理录音,结果二十分钟就弄完了,剩下的时间我还去逛了逛西湖,太爽了。
当然,还有没解决的问题。小众方言和小语种,缺训练数据,商业公司没动力投钱做,现在识别率还是上不去。还有带口音的小语种,更是没人碰。还有就是隐私问题,你说话的时候会不会被偷偷录音传出去?这点大家都在意,现在很多厂商也在做端侧语音识别,就是数据不用上传,就在你自己手机上处理,也算解决了一部分顾虑。
回头看看,也就十年功夫,当年实验室里连专家都觉得难用的黑科技,现在变成了连八十岁老人都天天用的标配。技术这东西,真的是越好用越让人感觉不到它的存在。你现在用输入法发语音,会不会想到,你天天用的,就是全世界最先进的语音识别技术?