强化学习技术:从棋盘游戏到工业落地,那些藏在顶会里的真实进展
大部分人对强化学习的第一印象,还停留在AlphaGo虐杀人类围棋棋手的热搜上。十年过去了,很多人还是觉得这玩意儿就是实验室里用来玩游戏的,跟日常生产生活不搭边。错得离谱。
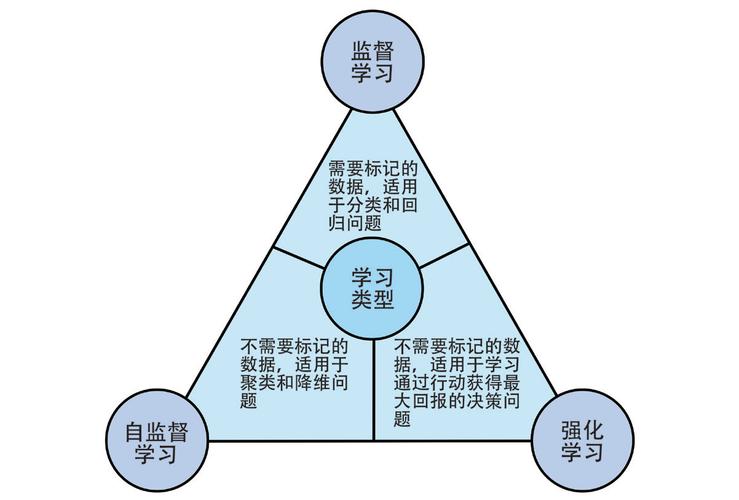 监督学习与强化学习数据流对比图
就说现在每天刷的短视频推荐,你以为是谁在帮你挑内容?最早的推荐模型是死的,按用户标签推,推错了也没法快速改。现在大厂主流的推荐框架,都加了实时强化学习模块。你点进去停留三秒还是三分钟,给不给点赞评论,这些即时反馈都会立马传给模型,下一秒给你推的内容就已经调整过方向了。不少头部平台实测,加了强化学习之后,用户日均使用时长能涨5%到10%,这就是真金白银的流量增长。
还有工业机器人的路径控制,汽车自动泊车的路径规划,甚至大模型训练的时候的算力分配,都在悄悄用强化学习技术。哪还有什么只玩游戏的说法。
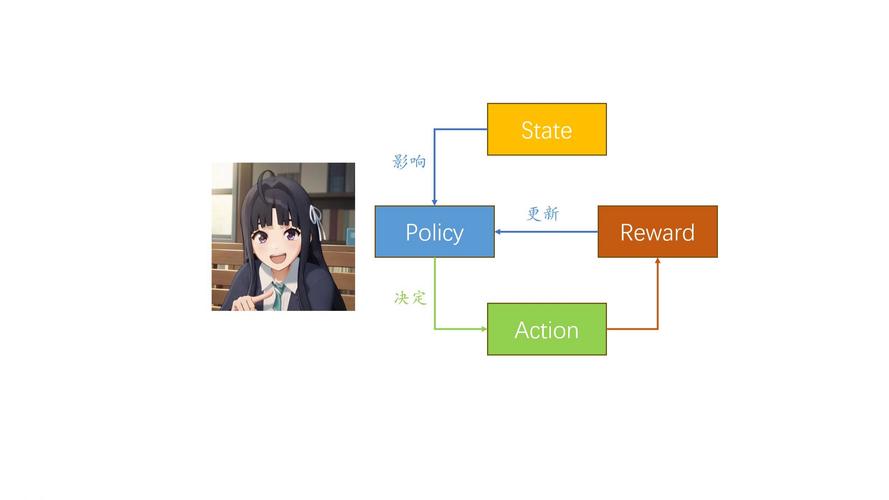 强化学习落地Reward设计常见误区示意图
不过话说回来,学界最近几年也一直在盯着这些坑填。现在火得一塌糊涂的离线强化学习,就是冲着样本问题来的。不用实时跟环境交互试错,直接用业务里已经攒好的历史离线数据训练,一下子把试错成本砍掉了九成。最近两年顶会上面,一半左右的强化学习相关论文都沾离线强化学习的边,足见这个方向的热度。
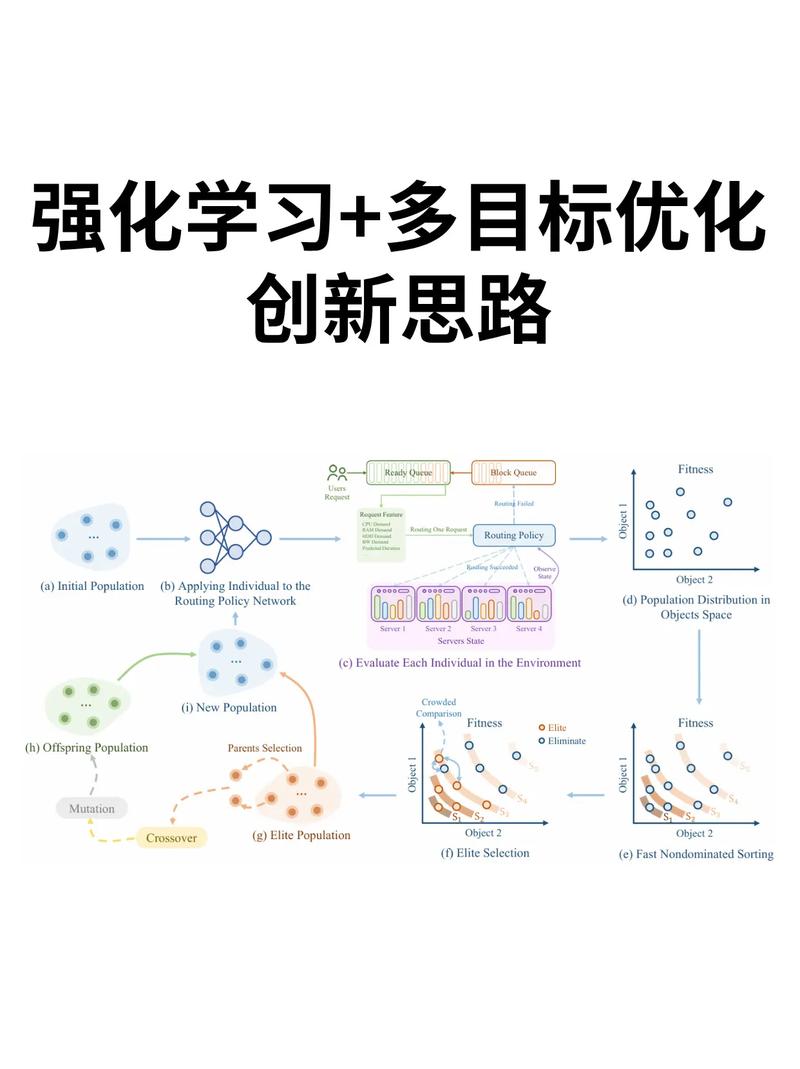 未来两年最值得期待的强化学习技术方向
现在大模型火得发烫,很多人说强化学习已经过时了?哪有的事,现在大模型能走到今天,强化学习还居功至伟呢。大家都知道大模型对齐要用RLHF,也就是人类反馈的强化学习,这套技术的核心就是强化学习,没有它,大模型输出的内容根本没法看,到处都是胡说八道的幻觉。
第一个最值得关注的方向,就是大模型 + 强化学习的结合。现在已经有人用大模型做强化学习的“世界模型”,原来要在真实环境里试一万次才能拿到的反馈,大模型直接就能给你模拟出来,省下来的算力成本不知道有多少。OpenAI最近放出来的Q*,传闻就是用大模型增强强化学习的推理能力,不管传闻真的假的,这个方向的潜力已经被所有人看在眼里了。
第二个方向,是人形机器人的通用策略训练。现在硅谷国内都在卷人形机器人,要让机器人应对不同的家庭场景,做不同的家务,靠人工写规则根本不可能,靠监督学习标注,要标到猴年马月?只有强化学习,能让机器人先在虚拟模拟环境里练几百万次,把基础策略摸熟了,拿到真实环境做几天微调就能用,效率比原来的方法高太多。特斯拉Optimus最新的运动控制算法,核心就是用强化学习训出来的,对比原来人工调的模型,适应复杂地形的能力翻了一倍还多。
第三个方向,就是产业级的动态优化,比如刚才说的算力调度,物流路径规划,电网调度,这些场景每天的环境都在变,原来的传统优化算法根本跟不上变化,强化学习能实时根据新的情况调整策略,帮企业省下来的成本都是真金白银。现在国内头部的云厂商,给大模型客户做算力调度,已经悄悄用上强化学习了,能把GPU利用率提10%以上,摊下来每个大模型训练能省几百万的成本。
强化学习发展这么多年,起起伏伏,早已经从那个只会下围棋的“实验室明星”,变成了藏在各个产业背后的无名英雄。你今天刷到合心意的短视频,用到响应快的云服务,说不定都有强化学习技术在背后起作用。
谁知道再过两年,它还能给我们带来什么惊喜呢?对吧。
强化学习技术真的不是只会玩游戏
从核心逻辑上说,强化学习和我们常见的监督学习完全不是一个路数。监督学习是你把标注好的标准答案喂给模型,让模型死记硬背规律。强化学习不一样,它更像我们人类学东西:把一个智能体扔到环境里,它做对了给奖励,做错了罚分,摔过几次跟头,自己就摸出了能拿最多奖励的最优策略。监督学习与强化学习数据流对比图
就说现在每天刷的短视频推荐,你以为是谁在帮你挑内容?最早的推荐模型是死的,按用户标签推,推错了也没法快速改。现在大厂主流的推荐框架,都加了实时强化学习模块。你点进去停留三秒还是三分钟,给不给点赞评论,这些即时反馈都会立马传给模型,下一秒给你推的内容就已经调整过方向了。不少头部平台实测,加了强化学习之后,用户日均使用时长能涨5%到10%,这就是真金白银的流量增长。
还有工业机器人的路径控制,汽车自动泊车的路径规划,甚至大模型训练的时候的算力分配,都在悄悄用强化学习技术。哪还有什么只玩游戏的说法。
强化学习落地绕不开的三个硬坑
说实话,我见过太多团队倒在落地的路上,不是技术方向错了,是这些坑没提前想到。 第一个坑,样本效率太低。强化学习要试错才能攒样本,可真实场景哪给你那么多试错的机会?做自动驾驶的,总不能让车真撞十次护栏才能学会躲障碍吧?做金融交易策略的,总不能亏几个亿才能攒出合格的训练样本吧?实验室里刷Atari游戏,千万级样本说有就有,放到工业场景,百万级样本都能要了团队的命。 第二个坑,分布偏移。训练的时候的环境,和上线之后的环境,永远不一样。你训练推荐模型用的是几年前的历史数据,上线之后用户喜好跟着热点变了一圈,模型没见过新情况,直接就懵了,输出的推荐策略歪到姥姥家。这个问题到现在都没有完美的解决方案,只能靠不停的微调,靠在线更新,耗的算力和人力海了去。 第三个坑,Reward 设计太玄学。你要怎么用一个数字,定义“好”和“坏”?想让AI生成符合品牌调性的文案,你给“通顺”给多少分?给“符合要求”给多少分?给高了,AI会走捷径,专门堆关键词骗奖励,内容完全没法看。给低了,AI干脆躺平,输出全是套话,没有一点新意。我去年接触过一个做AI药物分子设计的团队,大半年时间啥都没干,光调Reward函数了…太熬人了。强化学习落地Reward设计常见误区示意图
不过话说回来,学界最近几年也一直在盯着这些坑填。现在火得一塌糊涂的离线强化学习,就是冲着样本问题来的。不用实时跟环境交互试错,直接用业务里已经攒好的历史离线数据训练,一下子把试错成本砍掉了九成。最近两年顶会上面,一半左右的强化学习相关论文都沾离线强化学习的边,足见这个方向的热度。
未来两年最值得期待的强化学习技术方向
未来两年最值得期待的强化学习技术方向
现在大模型火得发烫,很多人说强化学习已经过时了?哪有的事,现在大模型能走到今天,强化学习还居功至伟呢。大家都知道大模型对齐要用RLHF,也就是人类反馈的强化学习,这套技术的核心就是强化学习,没有它,大模型输出的内容根本没法看,到处都是胡说八道的幻觉。
第一个最值得关注的方向,就是大模型 + 强化学习的结合。现在已经有人用大模型做强化学习的“世界模型”,原来要在真实环境里试一万次才能拿到的反馈,大模型直接就能给你模拟出来,省下来的算力成本不知道有多少。OpenAI最近放出来的Q*,传闻就是用大模型增强强化学习的推理能力,不管传闻真的假的,这个方向的潜力已经被所有人看在眼里了。
第二个方向,是人形机器人的通用策略训练。现在硅谷国内都在卷人形机器人,要让机器人应对不同的家庭场景,做不同的家务,靠人工写规则根本不可能,靠监督学习标注,要标到猴年马月?只有强化学习,能让机器人先在虚拟模拟环境里练几百万次,把基础策略摸熟了,拿到真实环境做几天微调就能用,效率比原来的方法高太多。特斯拉Optimus最新的运动控制算法,核心就是用强化学习训出来的,对比原来人工调的模型,适应复杂地形的能力翻了一倍还多。
第三个方向,就是产业级的动态优化,比如刚才说的算力调度,物流路径规划,电网调度,这些场景每天的环境都在变,原来的传统优化算法根本跟不上变化,强化学习能实时根据新的情况调整策略,帮企业省下来的成本都是真金白银。现在国内头部的云厂商,给大模型客户做算力调度,已经悄悄用上强化学习了,能把GPU利用率提10%以上,摊下来每个大模型训练能省几百万的成本。
强化学习发展这么多年,起起伏伏,早已经从那个只会下围棋的“实验室明星”,变成了藏在各个产业背后的无名英雄。你今天刷到合心意的短视频,用到响应快的云服务,说不定都有强化学习技术在背后起作用。
谁知道再过两年,它还能给我们带来什么惊喜呢?对吧。