机器学习技术:跳出PPT概念,落地才是真本事
去年帮顶会做了两个月审稿辅助,翻了快三百篇投过来的机器学习方向稿子。一半都透着一股敷衍味——把五年前的模型换个行业数据集,改改参数,就敢吹成“全新突破”。
看多了真的烦。
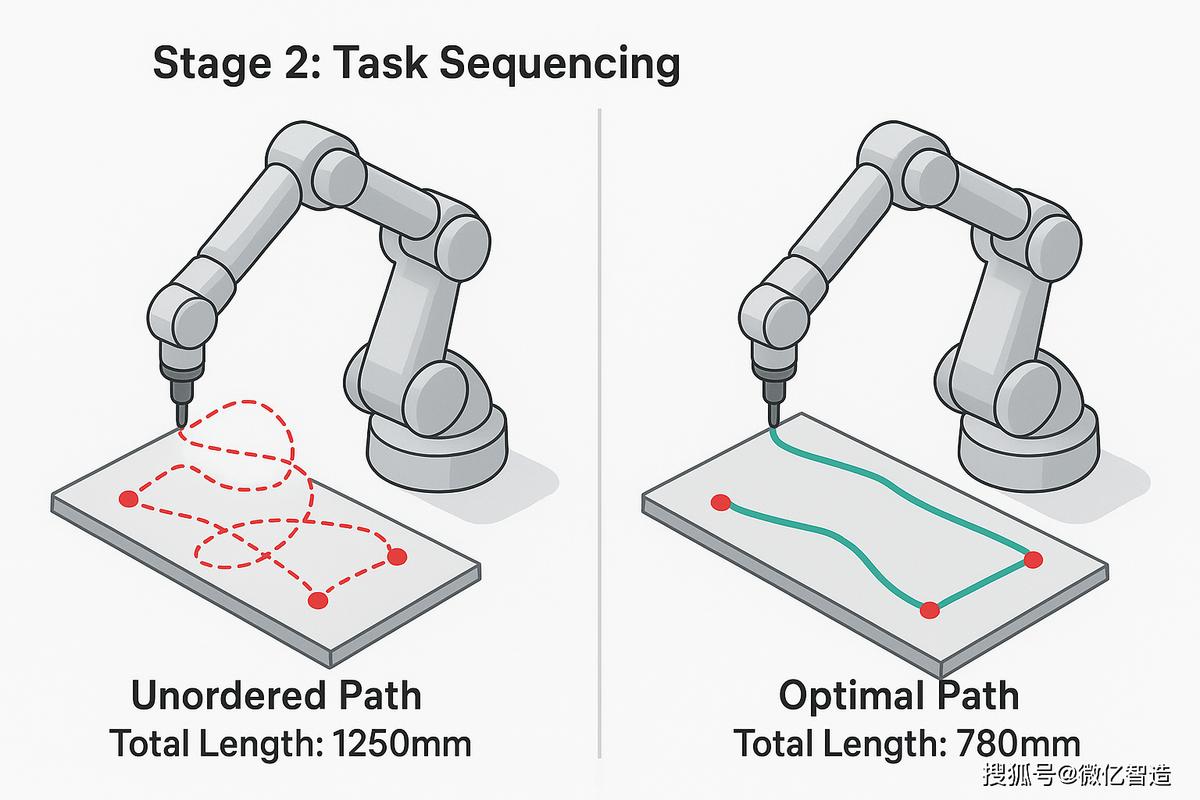 工业机器人机器学习路径规划训练界面
说实话,很多普通人对机器学习的印象还停留在ChatGPT聊天、AI生成头像,最多是短视频的推荐算法。其实这玩意儿早就渗到你生活的方方面面了,只是你没发现。
你去医院拍胸部CT,现在初筛找小结节的步骤,十家有八家已经用机器学习模型筛一遍了。医生只需要看模型标出来的可疑区域就行。前年发在《柳叶刀》的大样本统计,用模型辅助之后,小结节的漏诊率直接降了38%。这就是实实在在救人性命的东西。
那些天天在创投圈炒概念喊“AGI”的,转头连个商品条码都识别不利索,真不如这些沉在行业里啃硬骨头的小项目靠谱。
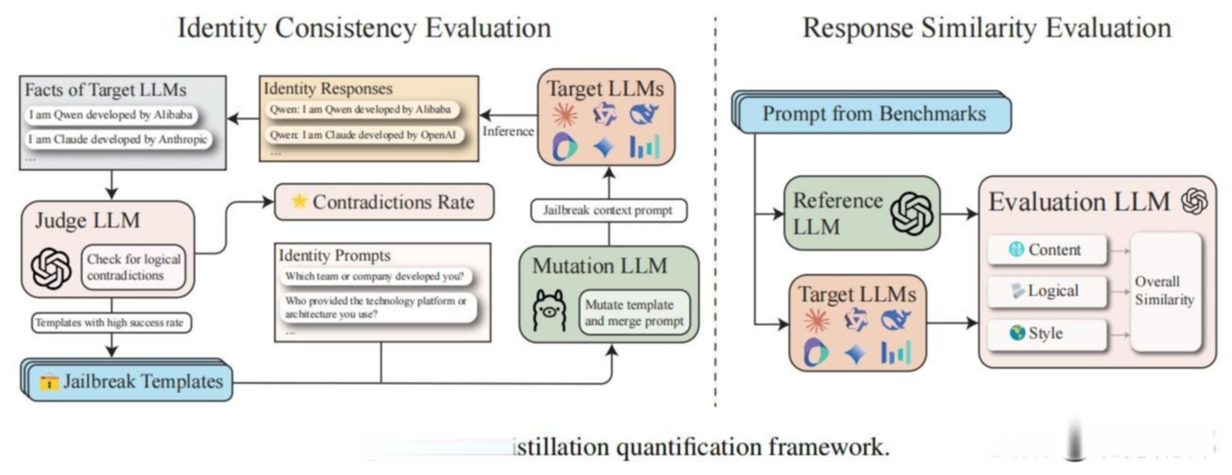 端侧机器学习大模型蒸馏精度对比图
文章里测了好几个主流大模型,把知识蒸馏到参数量只有原来1%的小模型上,跑在手机本地端,很多任务的准确率居然比调用云端大模型还高。延迟还从几百毫秒降到了十几毫秒,还不用上传隐私数据。
现在很多人都说,端侧小模型才是未来十年机器学习技术落地的主流。这话真没错。你说,大部分行业场景哪用得到万亿参数?给养猪场做个生猪估重模型,几千张标注好的猪身照片,训一个几M的卷积网络就足够用,准确率能到97%以上,非要拉个千亿大模型微调,那不是纯纯的浪费钱吗?
不过话说回来,大模型也不是一无是处。起码它把机器学习的热度炒起来了,不管是资本还是年轻人,都愿意往这个方向扎,也间接给很多做落地小项目的团队带来了资源。好坏掺半吧。
我前阵子碰见过一个农业创业团队,三个刚毕业的大学生,用开源的轻量机器学习模型做病虫害识别,农民打开微信拍一张叶子就能查,准确率比原来付费的软件还高,一年服务费才几十块。现在已经铺了十多万亩果园,帮果农少打了快两成农药,省的钱都是实实在在进了农民口袋。这才是机器学习技术该干的事啊。
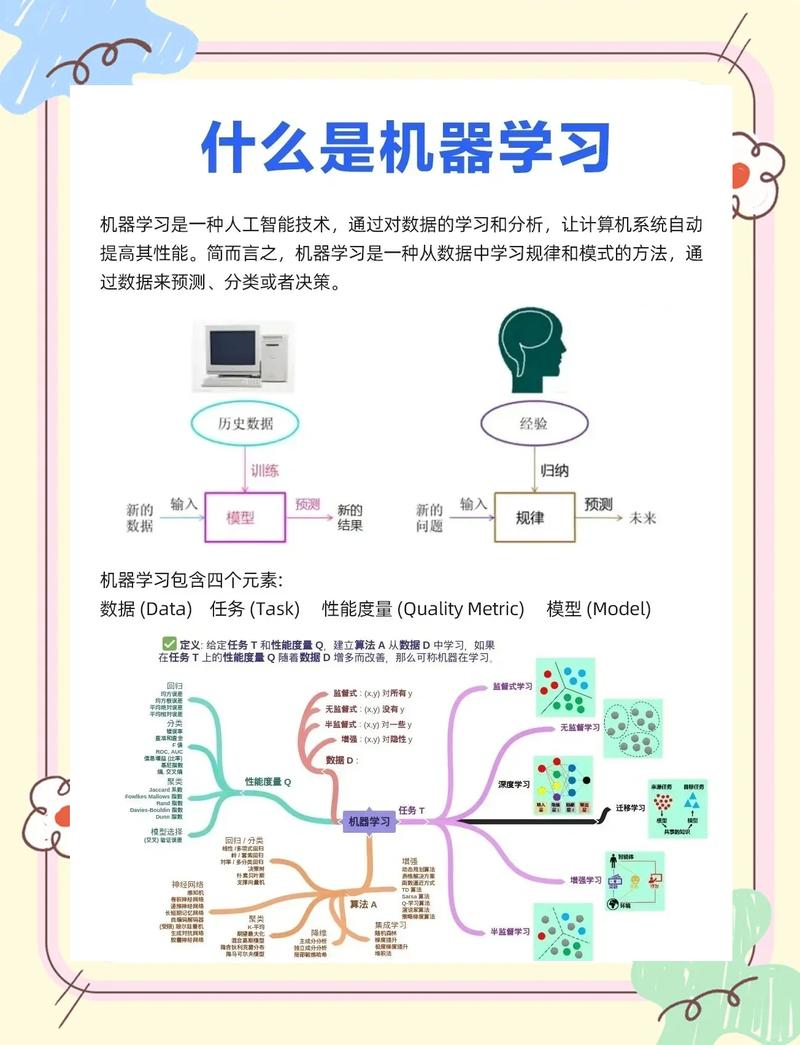 机器学习技术接下来要闯的几道坎
第一关就是可解释性。现在大部分高性能模型都是黑箱——你让它判断一个中小企业能不能给贷款,它说“不行”,你问为什么?哪条数据导致的?说不出来。这种情况在金融、医疗、法律这些强监管领域,根本没法大规模用。谁敢让一个说不出理由的模型给病人下治疗方案?
好在现在风向已经变了,顶会现在收可解释性机器学习的稿子,比纯刷精度的稿子多了不止一倍,这绝对是好事。
第二关就是数据偏见。训练人脸识别,全用年轻人、欧美人的脸做数据,给老人、亚洲人识别准确率直接掉十几个点。训练招聘筛选模型,训练数据里本来就男多女少,模型学会了直接优先筛掉女性应聘者。这种偏见不是调调参数就能改的,得从数据采集、标注的根上改,现在还没有特别完美的解决方案。
第三关就是能耗。之前看过一个统计,训练一个千亿参数的大模型,排放的二氧化碳相当于一辆普通家用车开五十年的总排放量。太夸张了。哪怕不说碳中和,这成本也不是一般公司能扛得住的。现在越来越多团队开始做低能耗机器学习,就是不用那么多GPU,也能训出够用的模型。我上个月看到国内遥感团队发的成果,做出来的地物分割模型,能耗比原来的主流模型降了70%,精度还涨了两个点,真的太提气了。
其实说了这么多,我就一个感觉。机器学习技术从来不是什么包治百病的神药,也不是少数大佬在酒局上吹的资本概念。它就是一个解决问题的工具。
能帮农民多打粮,能帮医生少漏诊,能帮工厂省成本,能给普通人省麻烦,这就是好技术。至于那些吹得天花乱坠的PPT概念,吹完赚完融资就跑路的,迟早会被忘了。对吧?
现在的机器学习技术,早就走出实验室自嗨了
上个月跟做工业机器人的老同学吃饭,他说他们厂里新更的机器人路径规划模型,是三年前读博的师弟带着两个硕士生做出来的。跑起来比原来买的国外商用模型准12%,换模具的调试时间从三小时缩到二十分钟,一年下来光省的停机成本就有小两百万。工业机器人机器学习路径规划训练界面
说实话,很多普通人对机器学习的印象还停留在ChatGPT聊天、AI生成头像,最多是短视频的推荐算法。其实这玩意儿早就渗到你生活的方方面面了,只是你没发现。
你去医院拍胸部CT,现在初筛找小结节的步骤,十家有八家已经用机器学习模型筛一遍了。医生只需要看模型标出来的可疑区域就行。前年发在《柳叶刀》的大样本统计,用模型辅助之后,小结节的漏诊率直接降了38%。这就是实实在在救人性命的东西。
那些天天在创投圈炒概念喊“AGI”的,转头连个商品条码都识别不利索,真不如这些沉在行业里啃硬骨头的小项目靠谱。
多数人对机器学习技术的最大误解:越大就是越强
这三四年大模型炒得凶,好像参数不搞到千亿万亿,都不好意思说自己做机器学习。好像模型参数翻一倍,就能解决所有问题。 去年ICML的那篇蒸馏小模型在端侧的精度反超大模型,我看完直接拍了大腿——终于有人把这层窗户纸捅破了。端侧机器学习大模型蒸馏精度对比图
文章里测了好几个主流大模型,把知识蒸馏到参数量只有原来1%的小模型上,跑在手机本地端,很多任务的准确率居然比调用云端大模型还高。延迟还从几百毫秒降到了十几毫秒,还不用上传隐私数据。
现在很多人都说,端侧小模型才是未来十年机器学习技术落地的主流。这话真没错。你说,大部分行业场景哪用得到万亿参数?给养猪场做个生猪估重模型,几千张标注好的猪身照片,训一个几M的卷积网络就足够用,准确率能到97%以上,非要拉个千亿大模型微调,那不是纯纯的浪费钱吗?
不过话说回来,大模型也不是一无是处。起码它把机器学习的热度炒起来了,不管是资本还是年轻人,都愿意往这个方向扎,也间接给很多做落地小项目的团队带来了资源。好坏掺半吧。
我前阵子碰见过一个农业创业团队,三个刚毕业的大学生,用开源的轻量机器学习模型做病虫害识别,农民打开微信拍一张叶子就能查,准确率比原来付费的软件还高,一年服务费才几十块。现在已经铺了十多万亩果园,帮果农少打了快两成农药,省的钱都是实实在在进了农民口袋。这才是机器学习技术该干的事啊。
机器学习技术接下来要闯的几道坎
机器学习技术接下来要闯的几道坎
第一关就是可解释性。现在大部分高性能模型都是黑箱——你让它判断一个中小企业能不能给贷款,它说“不行”,你问为什么?哪条数据导致的?说不出来。这种情况在金融、医疗、法律这些强监管领域,根本没法大规模用。谁敢让一个说不出理由的模型给病人下治疗方案?
好在现在风向已经变了,顶会现在收可解释性机器学习的稿子,比纯刷精度的稿子多了不止一倍,这绝对是好事。
第二关就是数据偏见。训练人脸识别,全用年轻人、欧美人的脸做数据,给老人、亚洲人识别准确率直接掉十几个点。训练招聘筛选模型,训练数据里本来就男多女少,模型学会了直接优先筛掉女性应聘者。这种偏见不是调调参数就能改的,得从数据采集、标注的根上改,现在还没有特别完美的解决方案。
第三关就是能耗。之前看过一个统计,训练一个千亿参数的大模型,排放的二氧化碳相当于一辆普通家用车开五十年的总排放量。太夸张了。哪怕不说碳中和,这成本也不是一般公司能扛得住的。现在越来越多团队开始做低能耗机器学习,就是不用那么多GPU,也能训出够用的模型。我上个月看到国内遥感团队发的成果,做出来的地物分割模型,能耗比原来的主流模型降了70%,精度还涨了两个点,真的太提气了。
其实说了这么多,我就一个感觉。机器学习技术从来不是什么包治百病的神药,也不是少数大佬在酒局上吹的资本概念。它就是一个解决问题的工具。
能帮农民多打粮,能帮医生少漏诊,能帮工厂省成本,能给普通人省麻烦,这就是好技术。至于那些吹得天花乱坠的PPT概念,吹完赚完融资就跑路的,迟早会被忘了。对吧?