聊聊我踩过坑的系统可靠性设计:不是堆冗余这么简单
我前阵子帮一个做ToB创业的朋友擦屁股,他们上线不到半年的核心业务系统,一个凌晨突然全线崩了,技术团队熬了三个小时才恢复,丢了三个付费大客户,老板在会议室拍桌子骂了整整一下午。
查下来的原因说出来你都不信,他们为了做高可靠,做了双活备份,结果备份集群的配置错了,主集群出问题切换过去的时候,备份集群连数据库地址都不对。
说白了,就是对系统可靠性设计的理解,从根上就错了。
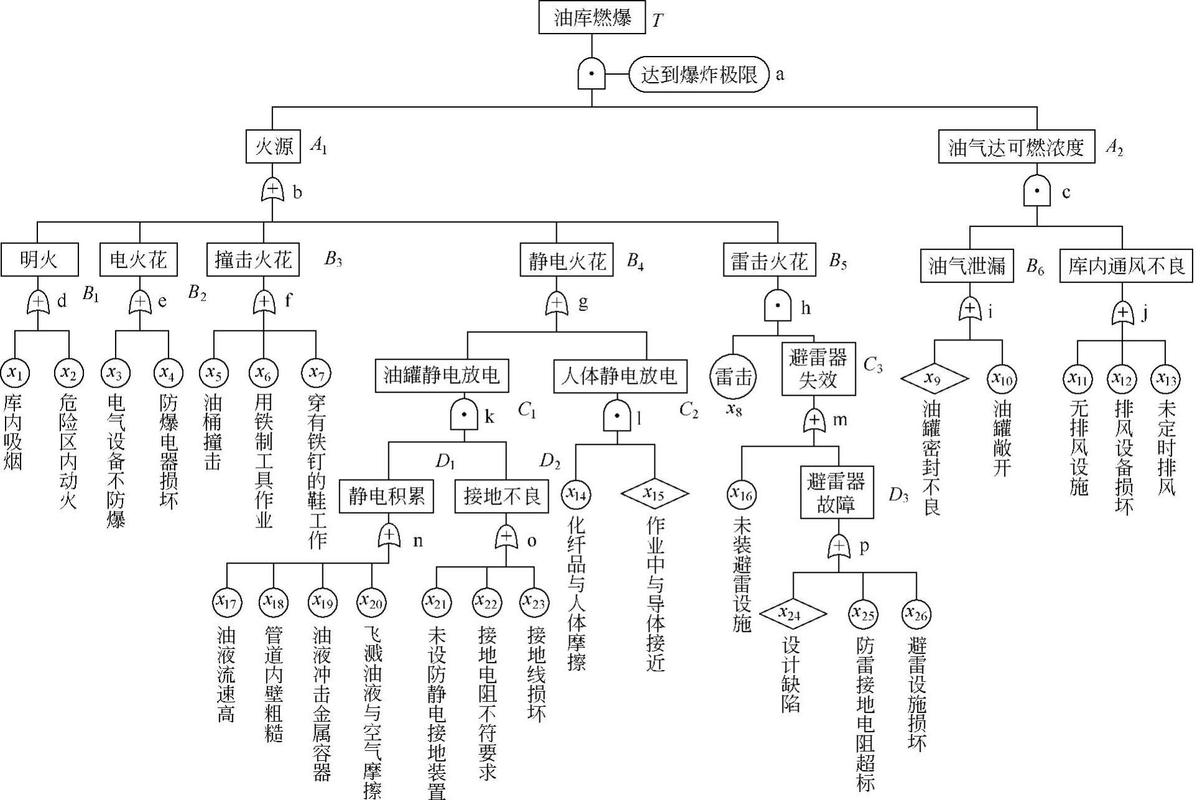 分布式系统雪崩效应故障链路图
说实话,大部分人对可靠性的理解都错了。可靠性从来不是零故障,也不是堆越多冗余越好。
冗余本身也会带来新的风险。同步延迟、脑裂、配置不一致,哪一样不是致命的?
很多小公司,用户量没多少,可用性要求也就99.9%够了,一年允许 downtime 8小时多,你非要花几百万去做99.999%,纯纯的资源浪费。
正确的第一步,永远是先梳理你的核心链路,算清楚每个环节的失效概率,你能接受多大的损失,再对应加冗余,而不是上来就堆料。
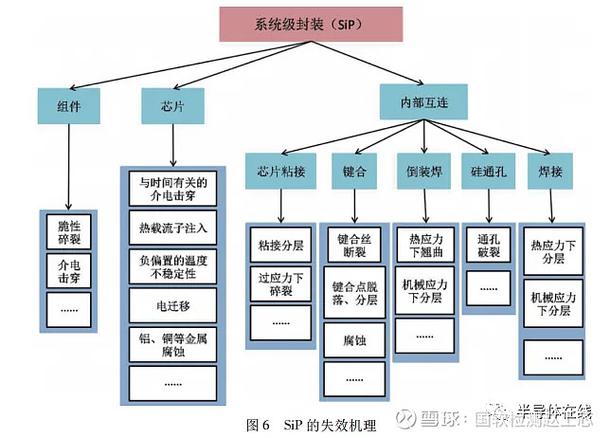 分布式系统可靠性失效域划分示意图
很多人说,熔断限流我也加了啊,怎么还出问题?
你摸摸良心说,你的熔断是只加在整个系统的入口,还是给每个失效域都加了独立的限流熔断?
我见过最离谱的,一个做SaaS的创业团队,把所有租户的数据库都放在同一个RDS实例上,一个大客户搞活动跑了个全表扫描的慢查询,整个平台所有客户全卡了,客服电话被打爆,这就是典型的没划失效域,说出去都笑死人。
正确的做法是什么?核心模块和非核心模块拆开放不同的失效域,不同租户的数据分开,甚至一个大的请求链路,都要拆成不同的域,每个域有自己的资源配额,有自己的熔断,一个炸了,最多影响这个域里的功能,别的地方照样跑,用户甚至都不一定能感知到出问题了。
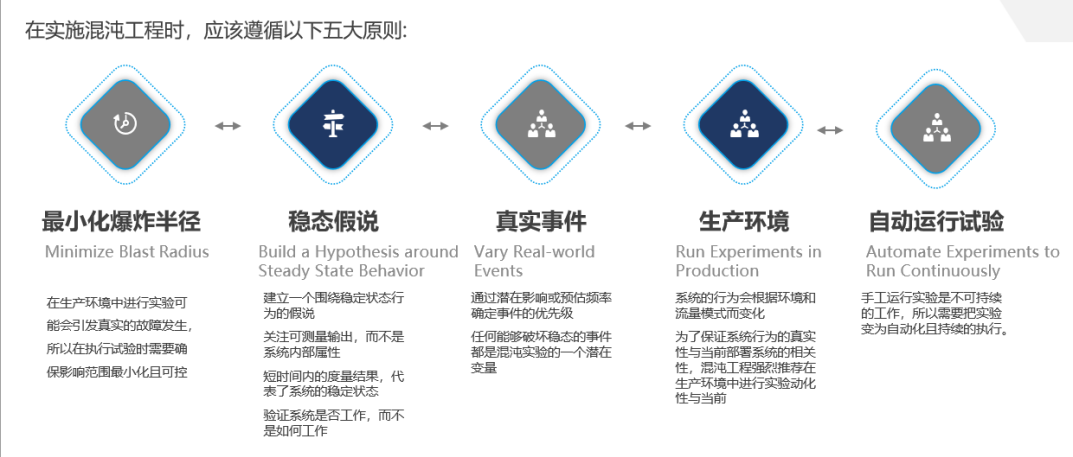 混沌工程才是检验可靠性的唯一标准
现在云原生这么火,混沌工程早就不是大厂专属了,对吧?
很多团队做了一堆可靠性设计,文档写得漂漂亮亮,什么切换流程,灾备方案,写了几十页,结果真出问题,发现备份根本没同步,切换脚本一年没更,早就跑不起来了。
我之前去阿里云的技术开放日,听他们的架构师说,他们内部有个不成文的规矩,每个团队每周都要主动搞一次可控故障,今天拔一根服务器的网线,明天关掉一个可用区,后天故意把一个数据库查慢,就是要在可控的范围内,把可能出的问题都先炸一遍,逼你把系统的容错能力做出来。
不过话说回来,很多小团队不敢搞这个,怕把生产环境搞炸了,怎么办?
你可以先在测试环境天天炸,没事炸着玩,把常见的故障都模拟一遍,总比双十二大促或者客户现场发布会的时候突然炸了强吧?
现在各大云厂商都有现成的混沌工程工具,免费版都够用,中小团队完全可以试起来,花不了多少时间,但是能帮你躲过不少杀身之祸。
我之前那个创业朋友,出事之后就是接入了混沌工程,每个月抽一个深夜模拟一次主备切换,现在半年多了,再没出过大问题。
系统可靠性设计这东西,真的不是堆概念堆出来的,是踩坑踩出来的。
你不用追求高大上的方案,适合自己的就是最好的。先划好边界,再算好风险,没事多炸炸自己,比啥都强。对吧?
别陷入冗余越多越可靠的误区
很多新手刚接触架构,第一反应就是,要可靠那不就是多买机器,多做备份吗? 钱砸下去,还能不可靠? 之前我接触过一个本地做政务系统的团队,预算挺足,上来就要做三地五中心,整个项目预算七成砸在了冗余资源上,结果上线第一年,真出了故障,主中心挂了切换到备中心,跨区域同步延迟了整整12秒,用户端的请求全超时,结果还是全崩。 你说冤不冤?分布式系统雪崩效应故障链路图
说实话,大部分人对可靠性的理解都错了。可靠性从来不是零故障,也不是堆越多冗余越好。
冗余本身也会带来新的风险。同步延迟、脑裂、配置不一致,哪一样不是致命的?
很多小公司,用户量没多少,可用性要求也就99.9%够了,一年允许 downtime 8小时多,你非要花几百万去做99.999%,纯纯的资源浪费。
正确的第一步,永远是先梳理你的核心链路,算清楚每个环节的失效概率,你能接受多大的损失,再对应加冗余,而不是上来就堆料。
失效域设计才是普通人容易漏掉的核心
我做了快十年架构,见过的大部分线上故障,根本不是没有冗余,而是一个小问题引发了雪崩,把整个系统拖死了。 之前我待的电商公司,某年618大促,一个支付网关的实例突然死锁了,本来就是单个实例的小问题,结果负载均衡没开快速下线,还源源不断把请求往这个死锁实例上扔,最后这个实例把整个机架的带宽占满了,连带着同机架的其他十几个服务全挂,最后影响了将近三分之一的支付请求,那一次的损失真的够买三年的云服务器了。 事后复盘,最大的问题就是没有做失效域划分。什么是失效域?说白了就是给错误划个边界,一个地方出问题了,就烂在这个框里,别往外跑。分布式系统可靠性失效域划分示意图
很多人说,熔断限流我也加了啊,怎么还出问题?
你摸摸良心说,你的熔断是只加在整个系统的入口,还是给每个失效域都加了独立的限流熔断?
我见过最离谱的,一个做SaaS的创业团队,把所有租户的数据库都放在同一个RDS实例上,一个大客户搞活动跑了个全表扫描的慢查询,整个平台所有客户全卡了,客服电话被打爆,这就是典型的没划失效域,说出去都笑死人。
正确的做法是什么?核心模块和非核心模块拆开放不同的失效域,不同租户的数据分开,甚至一个大的请求链路,都要拆成不同的域,每个域有自己的资源配额,有自己的熔断,一个炸了,最多影响这个域里的功能,别的地方照样跑,用户甚至都不一定能感知到出问题了。
混沌工程才是检验可靠性的唯一标准
混沌工程才是检验可靠性的唯一标准
现在云原生这么火,混沌工程早就不是大厂专属了,对吧?
很多团队做了一堆可靠性设计,文档写得漂漂亮亮,什么切换流程,灾备方案,写了几十页,结果真出问题,发现备份根本没同步,切换脚本一年没更,早就跑不起来了。
我之前去阿里云的技术开放日,听他们的架构师说,他们内部有个不成文的规矩,每个团队每周都要主动搞一次可控故障,今天拔一根服务器的网线,明天关掉一个可用区,后天故意把一个数据库查慢,就是要在可控的范围内,把可能出的问题都先炸一遍,逼你把系统的容错能力做出来。
不过话说回来,很多小团队不敢搞这个,怕把生产环境搞炸了,怎么办?
你可以先在测试环境天天炸,没事炸着玩,把常见的故障都模拟一遍,总比双十二大促或者客户现场发布会的时候突然炸了强吧?
现在各大云厂商都有现成的混沌工程工具,免费版都够用,中小团队完全可以试起来,花不了多少时间,但是能帮你躲过不少杀身之祸。
我之前那个创业朋友,出事之后就是接入了混沌工程,每个月抽一个深夜模拟一次主备切换,现在半年多了,再没出过大问题。
系统可靠性设计这东西,真的不是堆概念堆出来的,是踩坑踩出来的。
你不用追求高大上的方案,适合自己的就是最好的。先划好边界,再算好风险,没事多炸炸自己,比啥都强。对吧?