容错计算技术:藏在系统稳定运行背后的隐形保镖
你有没有试过,大年三十抢春运票,刷了四十分钟12306都没崩?手机摔得屏幕开裂缝,存在机身的几千张照片一张没丢?甚至你现在刷的短视频,云端AI给你生成的海报,背后都有同一个东西在兜着底。
就是容错计算技术。很多人听着觉得陌生,其实它已经悄悄保护我们的数字生活快七十年了。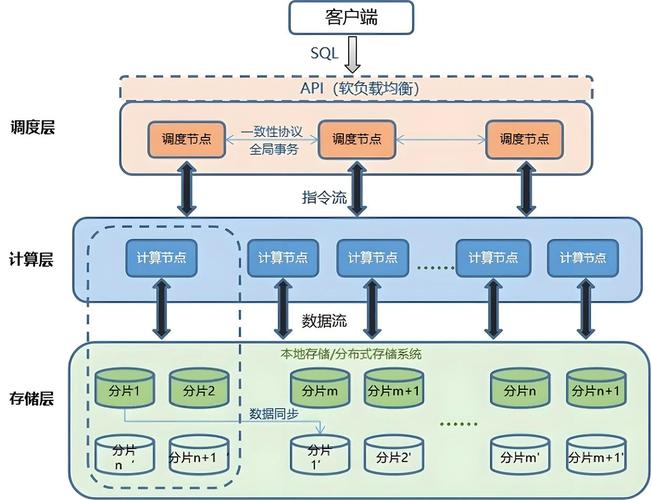 容错计算技术系统分层架构示意图
说实话,容错计算从诞生起就是给顶级高风险任务托底的。上个世纪五六十年代美苏航天竞赛,一个卫星上天,一个芯片出问题整个任务就全毁,烧进去几个亿的经费,好几年的研发,说没就没,谁敢赌?
很多人分不清楚容错和纠错的区别。纠错是找到错误把它改对,容错是我允许错误存在,但我绝对不让它拖累整个系统干活。这个思路差之毫厘,谬以千里。
举个最经典的例子,早年航天器的核心处理器,用的都是三模冗余容错。同一个指令,三个独立的CPU同时算,结果出来少数服从多数,哪怕其中一个芯片被宇宙射线打坏出了错,最终输出还是对的,整个飞行器该干嘛干嘛,根本不受影响。
现在你用的每一块固态硬盘,其实也内置了容错机制。每个存储块都留了冗余校验位,用久了出现坏块,系统直接把坏块绕过去,数据自动迁移到好块,你根本感觉不到,也不会丢文件。就这么简单?不对,这里头的算法迭代了几十年,才做到现在这么低的额外开销。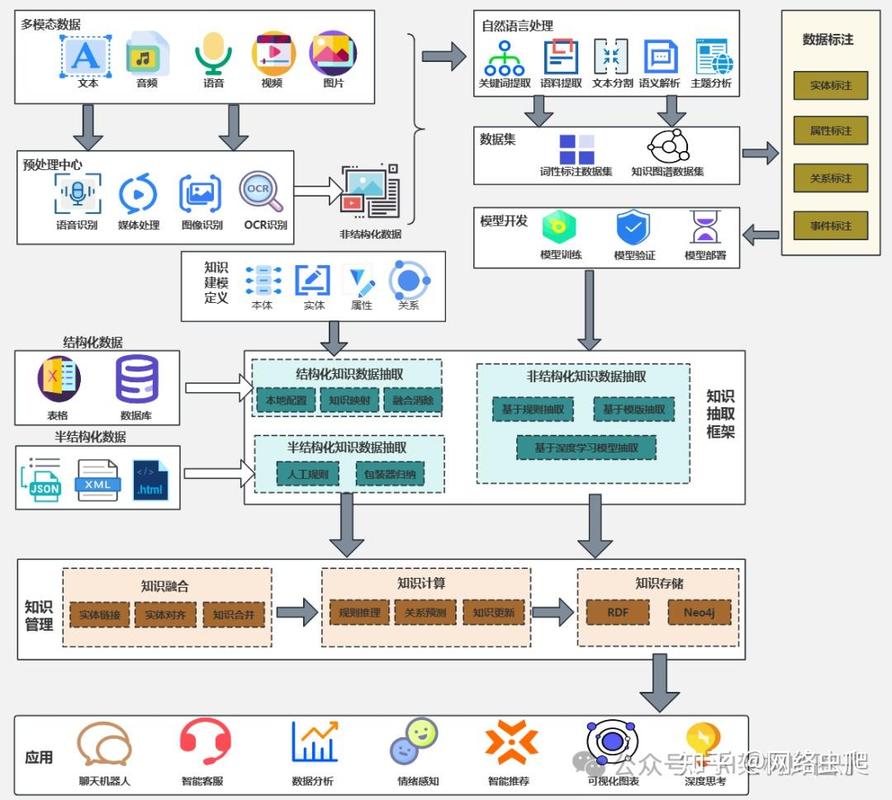 AI大模型集群容错计算调度示意图
你想想看,训练一个千亿参数的大模型,几千张A100连跑两三个月,光电费就几百万出去了。要是中间某一张卡硬件出故障,某一个节点网络断了,难道整个任务从头开始算?谁扛得住这个损失?
现在业内主流的方案是增量检查点容错,每隔固定一段时间,就把当前训练的全部状态存在可靠存储里,哪块出问题了,直接从上一个检查点恢复进度就行,不用从头来。不过话说回来,检查点存得太频繁,占存储拖速度,存得太少,出问题丢一大段进度,亏得更惨。现在国内清华、阿里达摩院都在研究动态调整检查点间隔的算法,根据集群的故障率实时改间隔,既能省存储,又能把出问题的损失压到最低,去年看了篇最新成果,能把额外开销降快30%,真的挺厉害。
还有现在的自动驾驶,车身上几十个传感器,毫米波雷达、摄像头、激光雷达,跑高速的时候哪一个突然坏了,总不能直接一脚刹车停在路中间吧?现在的车路协同系统里,容错计算会直接根据剩下完好的传感器数据,推算出缺失的那部分路况,足够支撑你开到路边停车,不会直接失控。
我见过太多创业公司踩坑。一开始赶上线拼速度,整个架构完全不做容错设计,觉得反正用户少,哪那么容易出错。等用户量上来,搞个活动突然流量爆了,直接整站崩了,还丢了一堆用户订单数据,最后赔多少钱不说,口碑掉了找不回来。这不就是一开始偷懒挖的坑么?
之前AWS北美区出故障,多少中小公司直接跟着挂了,就是因为只把服务部署在一个可用区,没做多区容错,人家基础设施出问题,你连个备份都没有,可不就只能干等着么。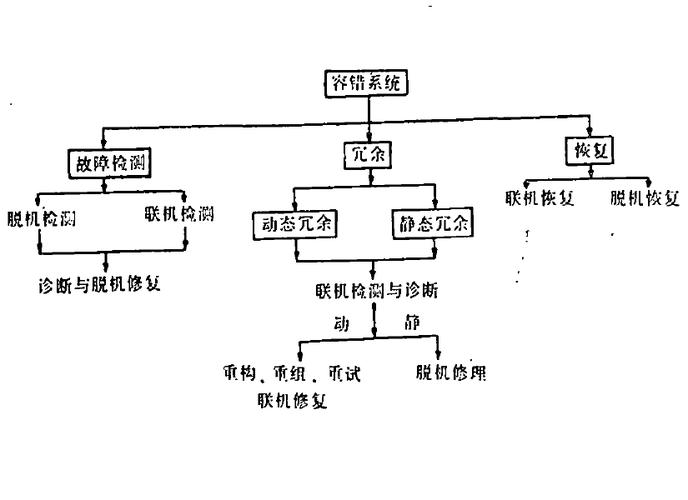 容错计算的下一个突破口在哪?
现在最火的方向,肯定是跟AI和量子计算绑定的容错。
先说AI,现在大模型都是分布式推理,一场直播带货,几十万用户同时连AI问答,你上百个推理节点,总不能一个节点卡了就给用户输出乱码吧?现在新的研究方向是面向生成式AI的端侧容错,哪怕部分计算单元出问题,也能自动修正生成结果的逻辑错误,不会出现前言不搭后语的情况,用户根本感觉不到出过问题。
更值得关注的是容错量子计算。现在所有的实用量子计算研究,都卡在量子比特的出错率上。量子比特本身太脆弱了,温度稍微变一点,有一点干扰,就会出错,现在的量子计算机,算不了几步错一半,根本没法用。现在全球所有搞量子计算的大厂,谷歌IBM中科大,都在砸钱做容错量子计算,就是要搞出能自动纠错容错的量子比特,要是真的搞出能用的容错量子计算机,整个密码学、药物研发领域都要翻天。
去年中科大已经在实验室做出了能纠正基本比特翻转错误的容错原型,虽然离实用还远,但已经跨出了最关键的一步。
说实话,容错计算技术从来都是一个「不出名才是做得好」的领域。它做得越好,你越感觉不到它的存在。你只会觉得这个APP很流畅,这个服务很稳定,不会想到是无数容错机制在背后给你兜着一个又一个可能出现的错误。
技术圈总喜欢追那些聚光灯下的新名词,大模型、Web3、元宇宙,很少有人会聊容错这种幕后技术。可就是这种不起眼的技术,撑起来整个数字世界的基本盘。
它就是那个永远在背后接锅的隐形保镖。你不用天天想起它,但它不能不在那儿。对吧?
就是容错计算技术。很多人听着觉得陌生,其实它已经悄悄保护我们的数字生活快七十年了。
什么是容错计算?不是简单的「出错了重来」
很多人一听「容错」,第一反应就是不就是程序报错了重试一遍么?太天真了。容错计算技术系统分层架构示意图
说实话,容错计算从诞生起就是给顶级高风险任务托底的。上个世纪五六十年代美苏航天竞赛,一个卫星上天,一个芯片出问题整个任务就全毁,烧进去几个亿的经费,好几年的研发,说没就没,谁敢赌?很多人分不清楚容错和纠错的区别。纠错是找到错误把它改对,容错是我允许错误存在,但我绝对不让它拖累整个系统干活。这个思路差之毫厘,谬以千里。
举个最经典的例子,早年航天器的核心处理器,用的都是三模冗余容错。同一个指令,三个独立的CPU同时算,结果出来少数服从多数,哪怕其中一个芯片被宇宙射线打坏出了错,最终输出还是对的,整个飞行器该干嘛干嘛,根本不受影响。
现在你用的每一块固态硬盘,其实也内置了容错机制。每个存储块都留了冗余校验位,用久了出现坏块,系统直接把坏块绕过去,数据自动迁移到好块,你根本感觉不到,也不会丢文件。就这么简单?不对,这里头的算法迭代了几十年,才做到现在这么低的额外开销。
现在的容错计算技术,都玩出哪些新花样了?
放在十年前,容错计算还是核心工业系统、航天军工这些领域的「小众需求」,现在完全不一样了。云计算普及,AI大模型爆发,容错直接变成了整个互联网行业的刚需。AI大模型集群容错计算调度示意图
你想想看,训练一个千亿参数的大模型,几千张A100连跑两三个月,光电费就几百万出去了。要是中间某一张卡硬件出故障,某一个节点网络断了,难道整个任务从头开始算?谁扛得住这个损失?现在业内主流的方案是增量检查点容错,每隔固定一段时间,就把当前训练的全部状态存在可靠存储里,哪块出问题了,直接从上一个检查点恢复进度就行,不用从头来。不过话说回来,检查点存得太频繁,占存储拖速度,存得太少,出问题丢一大段进度,亏得更惨。现在国内清华、阿里达摩院都在研究动态调整检查点间隔的算法,根据集群的故障率实时改间隔,既能省存储,又能把出问题的损失压到最低,去年看了篇最新成果,能把额外开销降快30%,真的挺厉害。
还有现在的自动驾驶,车身上几十个传感器,毫米波雷达、摄像头、激光雷达,跑高速的时候哪一个突然坏了,总不能直接一脚刹车停在路中间吧?现在的车路协同系统里,容错计算会直接根据剩下完好的传感器数据,推算出缺失的那部分路况,足够支撑你开到路边停车,不会直接失控。
我见过太多创业公司踩坑。一开始赶上线拼速度,整个架构完全不做容错设计,觉得反正用户少,哪那么容易出错。等用户量上来,搞个活动突然流量爆了,直接整站崩了,还丢了一堆用户订单数据,最后赔多少钱不说,口碑掉了找不回来。这不就是一开始偷懒挖的坑么?
之前AWS北美区出故障,多少中小公司直接跟着挂了,就是因为只把服务部署在一个可用区,没做多区容错,人家基础设施出问题,你连个备份都没有,可不就只能干等着么。
容错计算的下一个突破口在哪?
容错计算的下一个突破口在哪?
现在最火的方向,肯定是跟AI和量子计算绑定的容错。先说AI,现在大模型都是分布式推理,一场直播带货,几十万用户同时连AI问答,你上百个推理节点,总不能一个节点卡了就给用户输出乱码吧?现在新的研究方向是面向生成式AI的端侧容错,哪怕部分计算单元出问题,也能自动修正生成结果的逻辑错误,不会出现前言不搭后语的情况,用户根本感觉不到出过问题。
更值得关注的是容错量子计算。现在所有的实用量子计算研究,都卡在量子比特的出错率上。量子比特本身太脆弱了,温度稍微变一点,有一点干扰,就会出错,现在的量子计算机,算不了几步错一半,根本没法用。现在全球所有搞量子计算的大厂,谷歌IBM中科大,都在砸钱做容错量子计算,就是要搞出能自动纠错容错的量子比特,要是真的搞出能用的容错量子计算机,整个密码学、药物研发领域都要翻天。
去年中科大已经在实验室做出了能纠正基本比特翻转错误的容错原型,虽然离实用还远,但已经跨出了最关键的一步。
说实话,容错计算技术从来都是一个「不出名才是做得好」的领域。它做得越好,你越感觉不到它的存在。你只会觉得这个APP很流畅,这个服务很稳定,不会想到是无数容错机制在背后给你兜着一个又一个可能出现的错误。
技术圈总喜欢追那些聚光灯下的新名词,大模型、Web3、元宇宙,很少有人会聊容错这种幕后技术。可就是这种不起眼的技术,撑起来整个数字世界的基本盘。
它就是那个永远在背后接锅的隐形保镖。你不用天天想起它,但它不能不在那儿。对吧?