强化学习技术:从棋盘赛场到工业落地的隐形推手
很多人第一次听说强化学习,都是从AlphaGo打败李世石那事儿来的。当年多少人熬夜看直播,看完只记住了AI赢了人类,没记住赢的核心就是深度强化学习把蒙特卡洛树搜索和价值网络捏在了一起。
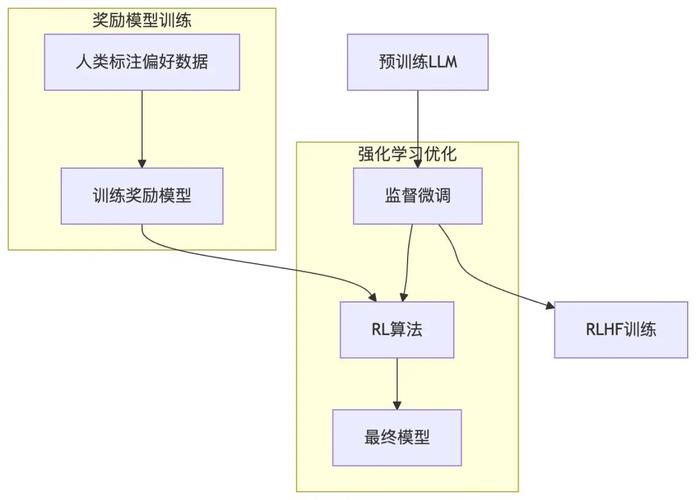 强化学习奖惩机制训练流程示意图
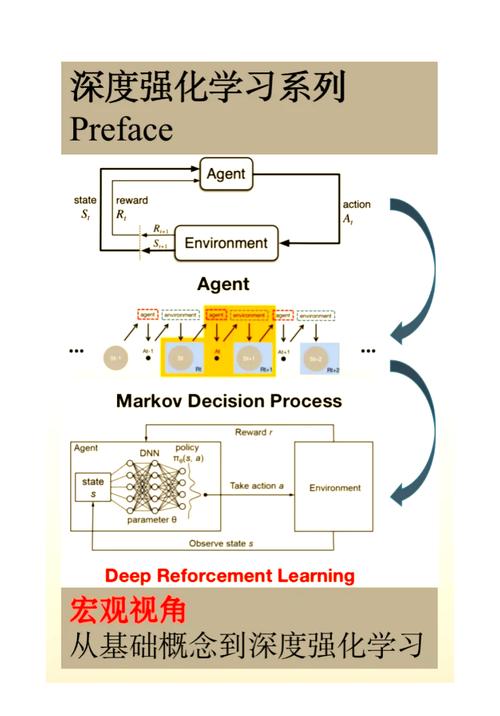
核心要素说穿了就三个:智能体、环境、奖惩信号。智能体就是做决策的那个AI,它在环境里做动作,环境给它反馈奖励或者惩罚,它慢慢调整策略,把总奖励拉到最高。
说实话,很多刚入行的新手会把强化学习和深度学习混为一谈,其实根本不是一回事。深度学习是用来拟合复杂数据的工具,强化学习是一套解决决策问题的逻辑框架,两者可以结合,也可以分开用。
你现在天天说的大模型RLHF,那个打头的RL,就是强化学习啊。没有它,大模型根本对齐不了人类的偏好,说出来的话要么牛头不对马嘴,要么充满攻击性,哪能像现在这么好用。
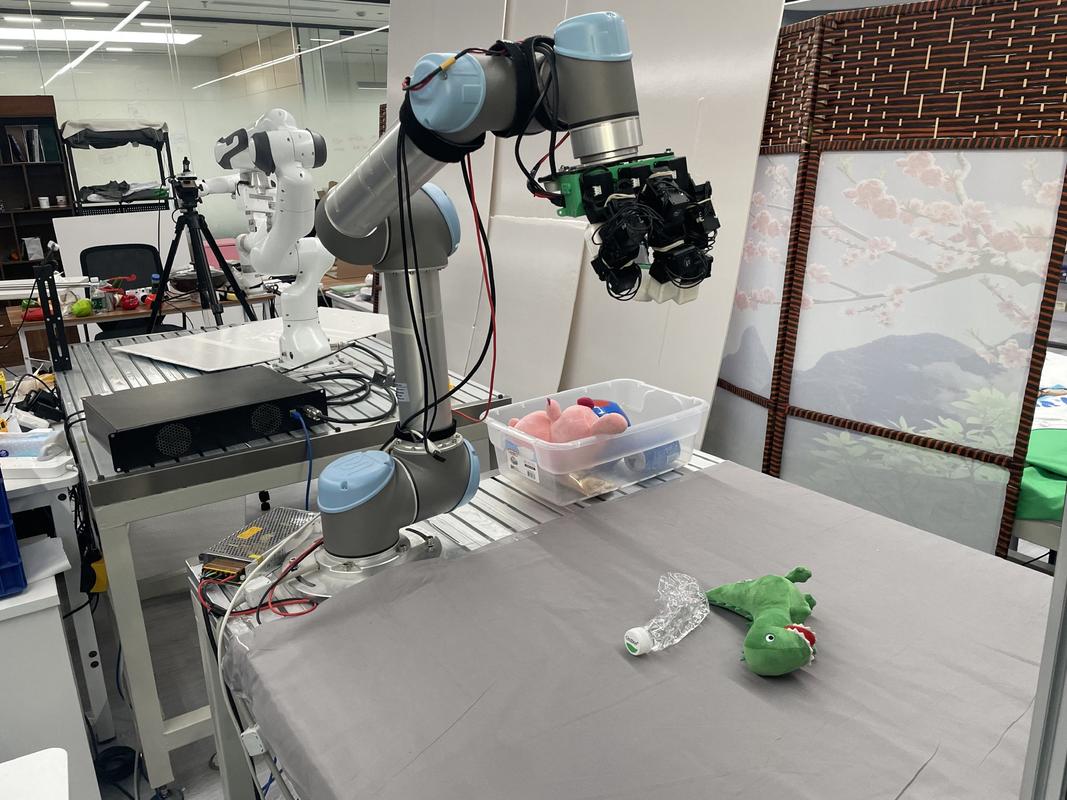 工业机械臂强化学习抓取训练场景图
再说推荐系统。你刷短视频刷得停不下来,越刷越对胃口,背后很多就是强化学习在实时调策略。你点进去停留超过半分钟,就是给模型正奖励。看两秒就划走,就是负奖励。模型几秒钟就更新一次策略,比老掉牙的协同过滤精准太多了。
还有无人驾驶的决策系统,碰到突然窜出来的外卖车、鬼探头的行人,靠提前写规则根本覆盖不完所有场景,强化学习在虚拟环境里练过几十万次类似场景,踩刹车打方向的反应比十年驾龄的老司机还稳。
不过话说回来,圈内人都知道,强化学习有个绕不开的坑。它要海量试错,放到真实世界试错成本太高了。你练自动驾驶总不能真撞几万次车吧?练机器人总不能摔碎几万个零件吧?
现在行业的主流解法,就是先在数字孪生的虚拟环境里练,练到差不多了再迁移到真实环境调,既能降成本,又能保证安全,很多项目都是这么跑通的。
我见过太多创业公司拿强化学习吹牛皮,说什么全能解决,转头连试错成本都控不住,最后项目黄了,钱也烧完了,可惜。
 强化学习技术接下来的爆点会在哪
现在最值得盯的方向,就是强化学习和大模型的深度结合。
之前RLHF只是用来调大模型的输出,对齐人类偏好,现在已经有人把强化学习用到大模型的推理过程里了。比如让大模型解数学题,走对一步给小奖励,解出正确答案给大奖励,走错一步直接罚,让它自己慢慢摸索推理路径,现在出来的结果,比纯大模型的准确率高了十几个点,真挺惊艳的。
还有生物制药,找新的蛋白质结构,本质就是搜索能量最低的构象,用强化学习做搜索,比传统的分子模拟方法快了几十倍,现在国内国外已经有好几家初创公司靠这个方向拿到了上亿美元的融资。
国内电网这边也在试点,用强化学习优化风电光伏的调度调峰,因为风电光伏出力不稳定,靠人工调度很难做到最优,强化学习能实时根据发电量和用电量调整,能降好几个百分点的损耗,别小看这几个点,全国电网一年省下来就是几十亿。
当然,现在还有很多硬骨头没啃下来。比如训练不稳定,你调参数调半个月,可能一个小变动直接不收敛,几天功夫白干。还有泛化性差,在虚拟环境练得好好的,到真实环境换个场景直接拉胯,这些都是现在科研圈盯着啃的问题。
前阵子看OpenAI最新放出来的预印本,他们在用强化学习训练大模型做工具调用,让大模型自己学会什么时候该搜搜索引擎,什么时候该用计算器,错了就罚,对了就奖,最终效果比专门做prompt工程还好,确实开了新路子。
很多人说AI现在到瓶颈了,我看未必。大模型是把人类已有知识都学会了,强化学习是让AI自己和世界互动,自己在试错里进化出新的知识,这不就是往通用人工智能走的路子吗?
你现在可能没感觉到它的存在,再过三五年,你回头看就会发现,小到快递机器人的路径规划,大到医院放疗的剂量优化,全是强化学习技术在默默跑。
它从来不是什么飘在天上的概念,是闷声干大事的隐形推手。
强化学习技术到底和别的AI有啥不一样
监督学习是喂给AI一堆标注好的数据,让它照着学规律,对吧?比如你给AI看一万张标了猫的照片,它就能学会认猫。 强化学习完全不是这么玩儿的。 它更像我们小时候学走路。摔了疼,就是负奖励。走两步拿到了柜子上的糖,就是正奖励。摔多了拿多了,自然就会走了。 没有现成的标准答案,全靠自己试错摸规律,这就是强化学习最核心的逻辑。强化学习奖惩机制训练流程示意图
核心要素说穿了就三个:智能体、环境、奖惩信号。智能体就是做决策的那个AI,它在环境里做动作,环境给它反馈奖励或者惩罚,它慢慢调整策略,把总奖励拉到最高。
说实话,很多刚入行的新手会把强化学习和深度学习混为一谈,其实根本不是一回事。深度学习是用来拟合复杂数据的工具,强化学习是一套解决决策问题的逻辑框架,两者可以结合,也可以分开用。
你现在天天说的大模型RLHF,那个打头的RL,就是强化学习啊。没有它,大模型根本对齐不了人类的偏好,说出来的话要么牛头不对马嘴,要么充满攻击性,哪能像现在这么好用。
现在强化学习技术最落地的领域都在哪
别以为只有AlphaGo那种聚光灯下的炫技产物才叫强化学习成果。现在它早就在很多你看不见的地方闷声赚钱了。 去年我去珠三角的一个机器人工厂参观,厂长说他们给3C企业做的分拣机械臂,之前用传统的视觉定位,碰到翘曲的柔性电路板就抓错,一天要停好几次生产线,损失不小。换了强化学习训练的模型之后,错率直接降了90%,省出来的人工成本,半年就收回了改造的钱。工业机械臂强化学习抓取训练场景图
再说推荐系统。你刷短视频刷得停不下来,越刷越对胃口,背后很多就是强化学习在实时调策略。你点进去停留超过半分钟,就是给模型正奖励。看两秒就划走,就是负奖励。模型几秒钟就更新一次策略,比老掉牙的协同过滤精准太多了。
还有无人驾驶的决策系统,碰到突然窜出来的外卖车、鬼探头的行人,靠提前写规则根本覆盖不完所有场景,强化学习在虚拟环境里练过几十万次类似场景,踩刹车打方向的反应比十年驾龄的老司机还稳。
不过话说回来,圈内人都知道,强化学习有个绕不开的坑。它要海量试错,放到真实世界试错成本太高了。你练自动驾驶总不能真撞几万次车吧?练机器人总不能摔碎几万个零件吧?
现在行业的主流解法,就是先在数字孪生的虚拟环境里练,练到差不多了再迁移到真实环境调,既能降成本,又能保证安全,很多项目都是这么跑通的。
我见过太多创业公司拿强化学习吹牛皮,说什么全能解决,转头连试错成本都控不住,最后项目黄了,钱也烧完了,可惜。
强化学习技术接下来的爆点会在哪
强化学习技术接下来的爆点会在哪
现在最值得盯的方向,就是强化学习和大模型的深度结合。
之前RLHF只是用来调大模型的输出,对齐人类偏好,现在已经有人把强化学习用到大模型的推理过程里了。比如让大模型解数学题,走对一步给小奖励,解出正确答案给大奖励,走错一步直接罚,让它自己慢慢摸索推理路径,现在出来的结果,比纯大模型的准确率高了十几个点,真挺惊艳的。
还有生物制药,找新的蛋白质结构,本质就是搜索能量最低的构象,用强化学习做搜索,比传统的分子模拟方法快了几十倍,现在国内国外已经有好几家初创公司靠这个方向拿到了上亿美元的融资。
国内电网这边也在试点,用强化学习优化风电光伏的调度调峰,因为风电光伏出力不稳定,靠人工调度很难做到最优,强化学习能实时根据发电量和用电量调整,能降好几个百分点的损耗,别小看这几个点,全国电网一年省下来就是几十亿。
当然,现在还有很多硬骨头没啃下来。比如训练不稳定,你调参数调半个月,可能一个小变动直接不收敛,几天功夫白干。还有泛化性差,在虚拟环境练得好好的,到真实环境换个场景直接拉胯,这些都是现在科研圈盯着啃的问题。
前阵子看OpenAI最新放出来的预印本,他们在用强化学习训练大模型做工具调用,让大模型自己学会什么时候该搜搜索引擎,什么时候该用计算器,错了就罚,对了就奖,最终效果比专门做prompt工程还好,确实开了新路子。
很多人说AI现在到瓶颈了,我看未必。大模型是把人类已有知识都学会了,强化学习是让AI自己和世界互动,自己在试错里进化出新的知识,这不就是往通用人工智能走的路子吗?
你现在可能没感觉到它的存在,再过三五年,你回头看就会发现,小到快递机器人的路径规划,大到医院放疗的剂量优化,全是强化学习技术在默默跑。
它从来不是什么飘在天上的概念,是闷声干大事的隐形推手。