自然语言处理:你以为它只会聊天?背后这些坑你根本想不到
别被大模型框住,NLP的根还在底层细分任务里
现在资本的热度全砸在通用大模型上,好像不提大模型,你做的就不是自然语言处理。可你知道吗?国内文博系统找了好几年团队,解决清代民国地方戏曲抄本的自动断词任务,到现在准确率都没突破85%。
这种活脏,累,赚不到快钱,大模型做出来的结果错漏百出,根本没法用。
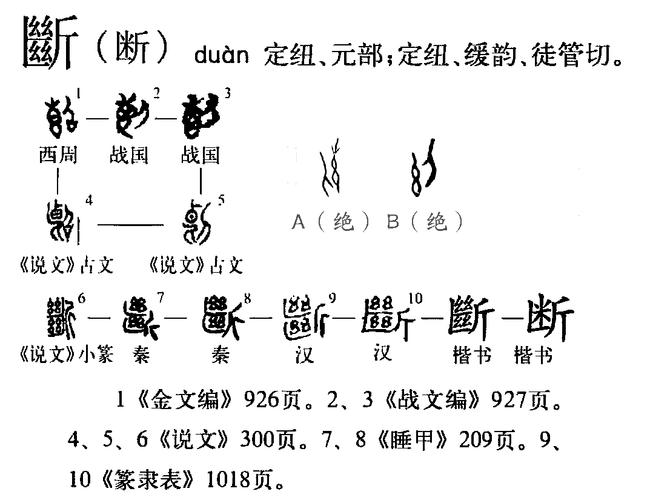 自然语言处理古文字抄本断词标注样例图
说实话,很多人不知道,自然语言处理从诞生开始,就从来不是只有“做通用聊天”这一个目标。司法裁判文书的核心要素自动提取,医院病历的结构化整理,少数民族濒危语言的数字化归档,这些全都是NLP的核心任务,哪一个不需要沉下心啃硬骨头?
去年南方某省高院公开招标裁判文书自动归档项目,三个拿了大融资的创业公司上去投标,用通用大模型做出来的结果,准确率还不到70%。最后中标的那个小团队,用传统NLP模型结合小样本微调,准确率做到了94%,价格还不到报价的三分之一。
你说讽刺不?
资本吹出来的泡沫,一碰到真问题,一戳就破。
现在科研圈最火的NLP方向,根本不是做聊天机器人
如果你去翻2023到2024年几大顶会的热门论文,会发现现在最受关注的方向,是因果自然语言处理。
原来的NLP,不管是传统统计还是现在的大模型,本质都是在学文字的统计相关性。你问它西红柿炒鸡蛋怎么做,它能给你拼出一份像模像样的菜谱,可它根本不理解“放糖是为了提鲜中和酸味”这个因果逻辑,遇到没见过的写法,直接就乱套。
因果NLP要做的,就是让模型跳出概率拼接,真的读懂语言背后的逻辑关系。
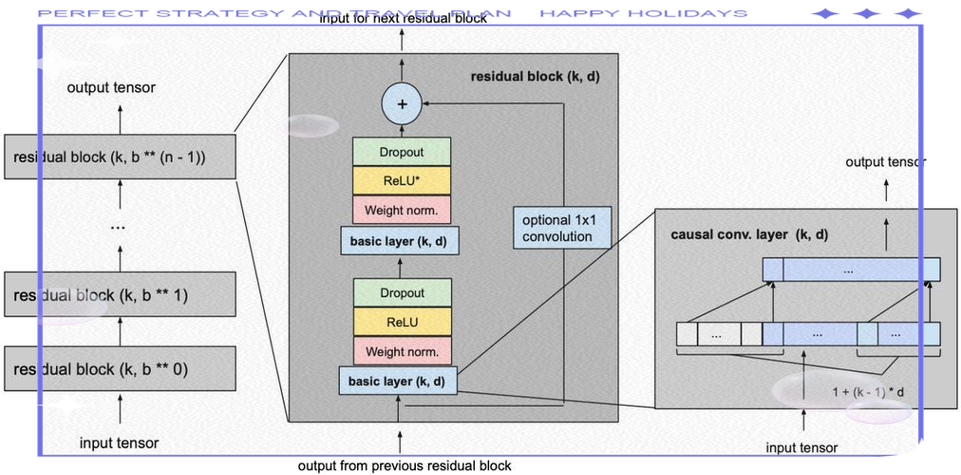 自然语言处理因果推理任务模型架构图
别觉得这是没用的概念玩花样。就说医疗NLP,现在很多医疗问答模型敢胡说八道开错药,根源就是它只知道“这个症状经常和这个药一起出现在文本里”,不知道“这个症状是因为这个病因,所以要用这个药”的因果链条。错一个,就是人命关天的事。
去年ICLR有一篇高分论文,用因果推断解决了医疗问答里的混淆变量问题,把准确率直接提了18个点,圈内当时都炸了。这种研究,才是真的能推动行业往前走的东西,比那些套壳大模型骗融资的不知道强多少。
NLP落地的坑,90%追风口的人都踩过
 NLP落地的坑,90%追风口的人都踩过
我接触过不下二十个做NLP创业的朋友,十个里有八个上来就说“我们做通用大模型,能解决所有问题”,最后十个里有八个死在了落地环节。
为什么?甲方要的不是一个能陪你聊天的机器人,是能解决他具体问题的工具。做煤炭行业的安全报告审核,一堆行业黑话、缩写,通用大模型见都没见过,怎么可能做对?你要微调,没有几十万标注数据,根本出不来效果,标注数据的成本,几百万砸进去连水花都没有。
我那个博后朋友,上个月接了一个地方戏曲博物馆的活,把建国以来上千小时的晋剧录音转写成文字。试了四个主流通用大模型,转写准确率最高才67%,一堆方言俚语全错。最后他用了二十年前的声学模型加NLP语法纠错,再用十几个小时的标注数据微调,准确率直接拉到92%,顺利交差,费用才不到二十万。
对吧?技术从来没有新旧之分,能解决问题的就是好技术。
不过话说回来,这两年也能看到好的变化。越来越多甲方不迷信大模型的名头了,开口先问你能把准确率做到多少,能适配我的现有系统吗,价格多少,不再一上来就问你是不是大模型。
那些沉下心啃细分领域硬骨头的团队,日子反而越来越舒服。我认识一个老大哥,在西安做了十年NLP,专门做文物文献的数字化整理,不追风口,不融资,每年接几个项目,团队十几个人,赚的钱不比那些烧了几亿融资的创业公司少,活得还自在。
自然语言处理发展到现在快七十年了,起起落落多少轮,从规则到统计,从深度学习到大模型,技术换了一轮又一轮,核心从来没变过。它不是用来圈融资讲给资本听的概念,它是用来帮人解决问题的工具。
少点泡沫,多点实干,这个行业才能真的走得更远。