深度学习技术:从实验室调参到改变生活的这十年
第一次听说深度学习的时候,我还在学校实验室帮师兄调参。调了三个礼拜,模型准确率死活涨不上去。最后发现,是数据集标错了十分之一的数据。真坑。
那时候深度学习还没像现在这么火,大家提起就是说哦,就是神经网络换了个名字对吧?没想到十几年过去,连楼下卖水果的阿姨都能说两句AI画图聊天,变化快得让人反应不过来。
别被吹得晕头转向,现在深度学习技术的核心还是拟合
拟合能力才是深度学习迄今为止最核心的优势,没有之一。很多人张口就是通用人工智能,说再过十年机器就能超越人类,其实说白了,现在所有的深度学习模型,本质上还是在已有数据里找规律,然后输出最符合规律的结果。
说白了,你给它一亿张猫的图片,它就能学会从一堆像素里认出哪只是猫,你给它几T的人类对话文本,它就能学会像人一样跟你聊天。没有那么多玄乎的“自我意识”,就是算力够了,数据够了,拟合得好了而已。
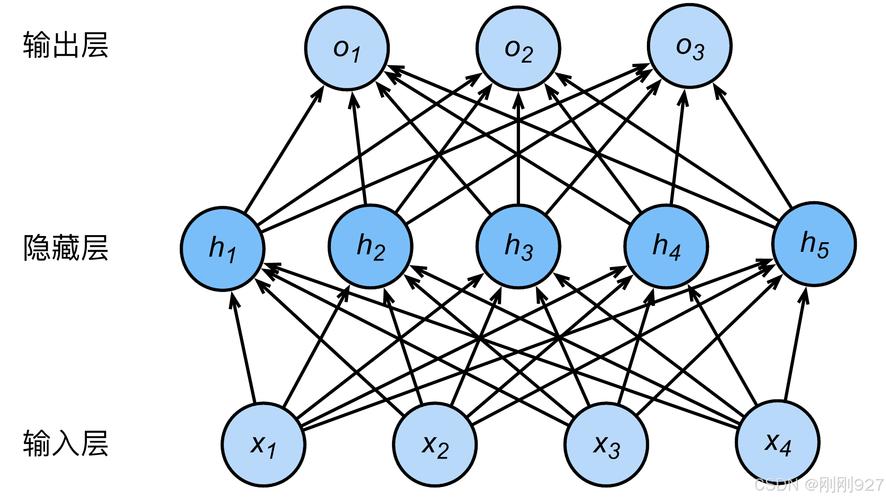 深度学习神经网络拟合非线性函数示意图
去年OpenAI泄露的内部报告里写得很清楚,大模型之所以效果好,核心就是堆参数堆数据,砸钱砸出来的效果,到现在也没人说清楚为什么越大效果越好,反正就是好用。说出来你可能不信,好多模型的调参现在还靠试,试出来哪个好用就用哪个。
说实话,现在好多行业里的坑,就是把深度学习吹得太神了。多少创业公司拿着深度学习的幌子圈钱,张口就是颠覆行业,拿到融资转头就把模型套个开源大模型的壳,连测试集都没做干净,最后落地的时候一塌糊涂,坑了甲方也坑了投资人。
最有价值的深度学习技术落地,根本不是聊天机器人
深度学习技术从来都不是只有聊天机器人和AI画图这一种玩法。现在真正给整个社会带来质变的深度学习应用,大多都在你看不见的地方。
就说AlphaFold吧,之前结构生物学界解一个蛋白质的三维结构,少则半年多则好几年,好多时候花了好几年还解不出来。现在用AlphaFold的深度学习模型,几个小时就能出一个精度很高的预测结果,全球已经有超过两亿个蛋白质的结构被预测出来了,直接把新药研发的速度提了好几个档。
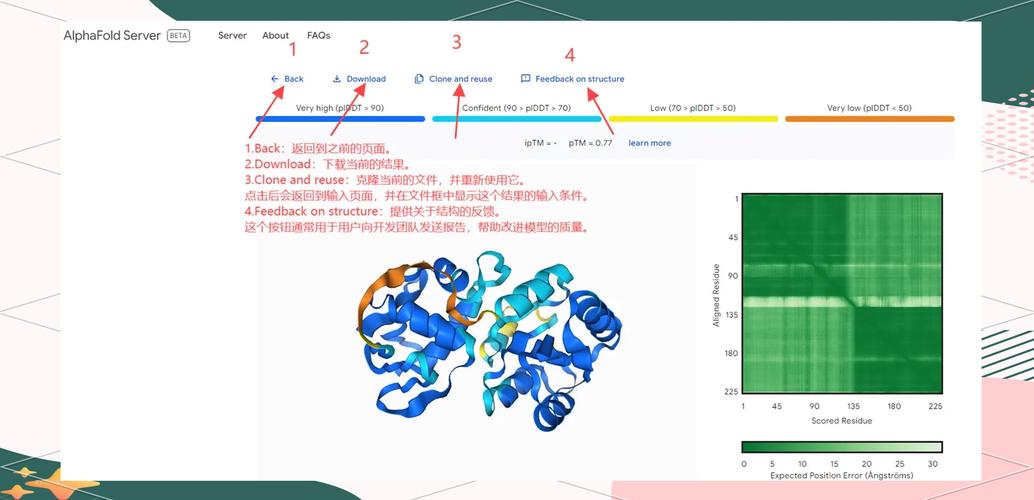 AlphaFold深度学习预测蛋白质3D结构图
再举个接地气的例子,国内好多港口现在用深度学习来调度集装箱桥吊,原来一个码头要几百号人轮班倒,现在一个模型就能调度百分之八十以上的作业,不仅出错少了,港口的吞吐量还涨了近百分之二十,这都是真金白银的提升。
不过话说回来,现在资本都盯着To C的AI应用,觉得赚钱快,好多真正能帮传统产业升级的深度学习方向,反而没多少人关注。其实传统产业降本增效的空间大得很,随便一个小场景用深度学习优化一下,一年就能省几百万上千万,比做一百个聊天机器人的价值都大。
普通人面对深度学习技术,不用慌也不用飘
 普通人面对深度学习技术,不用慌也不用飘
好多人说深度学习要抢所有人的工作,我反而觉得不是这么回事。它抢的都是那些本来就反人类的工作——比如一天站八个小时盯着瓷砖看裂纹,比如在养猪场挨个给猪称重,比如天天对着表格录数据,这些活本来就没人愿意干,机器接过去不好吗?工人转去做更轻松更有价值的活,这不是进步是什么?
我去年去佛山的陶瓷厂调研,厂长跟我说,原来每条生产线要三个老工人盯着看裂纹,一天八个小时眼睛都不能眨,干个十年八年大多都近视加散光,现在用深度学习模型加两个高清摄像头,准确率能到99.6%,比人准多了,原来的检测工人都转去做包装和维护了,工资还涨了,这不比天天盯着裂纹强?
当然,问题也不少。现在大模型训一次要花几百万度电,碳排放高得吓人,还有数据偏见的问题,训练数据里带的偏见,模型全学会了,有时候会出很离谱的错。这些问题都不是不能解决,就是需要大家沉下心来慢慢磨,不要天天想着赚快钱堆参数。
最近这两年我看到不少实验室在做面向特定场景的小模型,把大模型的知识蒸馏到小模型里,精度差不了几个点,能耗只有原来的几十分之一,部署到普通的服务器就能用,中小企业也用得起。这才是深度学习技术该走的路嘛,不是堆参数比谁大,是真的解决问题。
技术从来都不是洪水猛兽,也不是点石成金的魔法。它就是一个工具,一个能帮我们把好多原来做不到的事变成现实的工具。接下来这十年,深度学习技术能走到哪一步,我挺好奇,也挺期待的。