机器学习技术:走出实验室的真实落地与破圈方向
去年帮老家一个卖柑橘的叔叔解决收购分级的问题,才发现我之前对机器学习技术的认知,全错了。
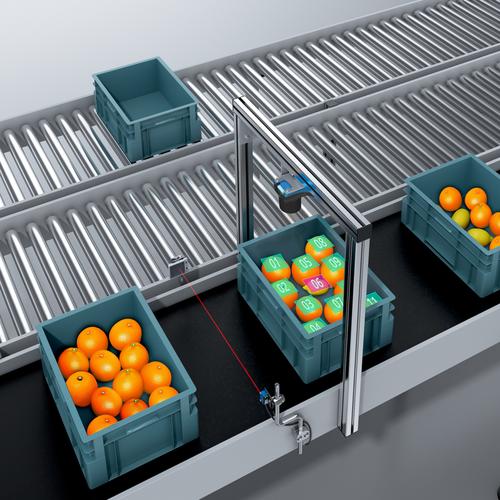 农业生产线柑橘分级机器学习检测示意图
说实话,这种情况真不是个例。我见过好几个清北的博士,发了NIPS、ICV的论文,落地的时候连个小型加工厂的需求都满足不了。不是模型太大,边缘设备跑不动,就是泛化性差得离谱——换个光照,换个角度,结果直接错得离谱。
问题出在哪?还能出在哪,公开数据集的样本,都是挑了又挑,洗了又洗的,每一张都摆得整整齐齐,背景干净得发光。现实呢?现实里的果子是堆在传送带上滚的,有泥,有叶子,有阴影,什么样的歪瓜裂枣都有。
现在太多科研成果,都是为了刷榜而刷榜,把所有的参数都调到适配测试集,看起来数据好看,发得出论文,评得上职称,离真实的产业需求,差了十万八千里。
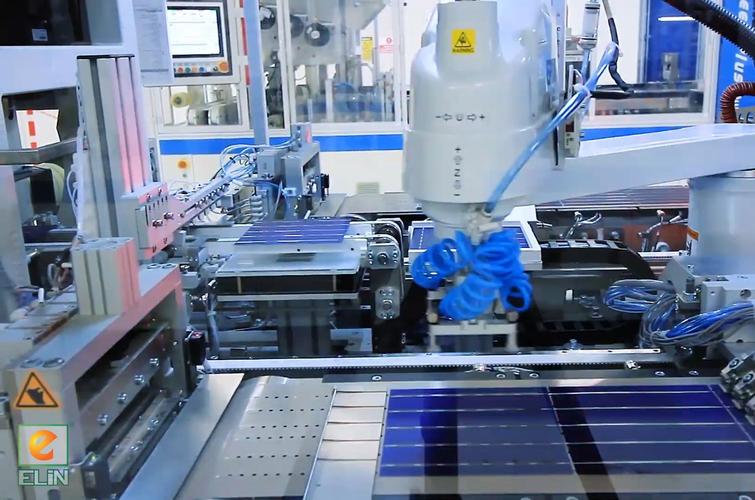 光伏板缺陷机器学习检测生产线实拍图
不过话说回来,也不是说大模型没用。现在很多成熟的落地方案,都是老技术扛主力,大模型打辅助。比如我见过的客服系统,90%的标准化意图识别,还是用的十年前的fastText,只有遇到那些语义模糊、没见过的用户提问,才调用大模型做处理,整体成本比全大模型方案低了90%,响应速度还快了好几倍,用户体验反而更好。
很多人一提到机器学习技术就想到GPT,想到ChatGPT,想到各种动辄千亿参数的大家伙,其实市场上90%的需求,根本不需要那么大的模型。把成熟的老技术玩明白,适配具体场景,比什么都强。
我前阵子碰到一个做物流分拣的创业者,他说他用的还是十几年前的K-means聚类做地址匹配,准确率比大模型还高,成本一年只要几千块钱,要是换成大模型,一年几十万都打不住。
这才是真实的行业现状。
 未来两年,机器学习技术的破圈点藏在哪
我跑了小半年行业会,见了几十个做落地的团队,最大的感受就是,接下来能真的让机器学习技术走进千万小商家、走进普通人生活的,是两个方向。
第一个就是端侧轻量化机器学习。
为啥?现在大家对数据隐私的要求越来越高,医院的病历不能随便传到云端,工厂的生产数据是核心机密不能外流,银行的用户信息更不能出去,这些场景,云端AI根本玩不转,必须把模型放在本地跑。
还有就是低成本的物联网设备,之前一块带AI能力的芯片要好几百,现在随着模型压缩技术的进步,几十块甚至几块钱的单片机就能跑得起能用的机器学习模型。上个月我看MIT CSAIL刚发的成果,把原本1G的语义分割模型,压缩到了不到8M,精度掉了不到1%,直接能跑在最便宜的农业环境监测传感器上。
这意味着什么?意味着以后就连山里种果树的农民,买个几十块钱的传感器,就能本地监测病虫害,不用联网,不用交年费,买了就能用。之前很多云AI方案,按调用次数收费,小商家根本用不起,端侧轻量化起来了,才真的谈得上普惠。
第二个方向就是适配真实场景的小样本学习。
你想啊,真实产业里哪来那么多标注好的数据?你要给一个新培育的橙子品种做分级,总不可能花几万块请人标几万张图吧?很多小商家的需求,都是小众的,个性化的,根本拿不出大量标注数据。
现在最新的小样本学习成果,只要标几十张甚至十几张图,就能训出一个准确率90%以上的可用模型,这才是真的贴合需求啊。我上个月在展会上看到一个创业团队演示的小样本茶叶分级,只标了30张不同等级的茶叶图,模型准确率就到了91%,比之前标一万张的老模型差不了2个点,当时我就觉得,这才是踩对了点。
说白了,机器学习技术搞了这么多年,早就过了堆参数刷榜的时代了。能沉下心解决一个个具体的小问题,能让果农多赚点钱,能让工厂少出点废品,能让小商家用得起AI,这才是真正有价值的方向啊。
实验室里的99分,到田间为啥连60分都拿不到
顶会论文里的模型,一个个准确率刷得比谁都高,随便拿出来都是98%、99%的正确率。放到真实场景里,一跑就垮。 我当时帮那个叔叔找解决方案,最先试了网上开源的预训练水果分类模型。那模型在公开数据集Kaggle上的准确率快97%,看着挺香对吧?实际一跑,把带两片叶子的好柑橘全分成了“异形次品”,把长了小霉斑的坏果分成了好果,错检率快40%。农业生产线柑橘分级机器学习检测示意图
说实话,这种情况真不是个例。我见过好几个清北的博士,发了NIPS、ICV的论文,落地的时候连个小型加工厂的需求都满足不了。不是模型太大,边缘设备跑不动,就是泛化性差得离谱——换个光照,换个角度,结果直接错得离谱。
问题出在哪?还能出在哪,公开数据集的样本,都是挑了又挑,洗了又洗的,每一张都摆得整整齐齐,背景干净得发光。现实呢?现实里的果子是堆在传送带上滚的,有泥,有叶子,有阴影,什么样的歪瓜裂枣都有。
现在太多科研成果,都是为了刷榜而刷榜,把所有的参数都调到适配测试集,看起来数据好看,发得出论文,评得上职称,离真实的产业需求,差了十万八千里。
现在最赚钱的机器学习技术,居然都不是那些花里胡哨的大模型
现在打开科技新闻,全是千亿参数大模型,全是通用人工智能,搞得好像不用大模型就不配叫机器学习一样。 可你去线下跑一圈工厂,跑一圈实体企业,90%的落地场景,用的都还是十年前甚至二十年前的老技术,而且效果比大模型还好,成本还低到尘埃里。 去年我接触一个做光伏板缺陷检测的团队,他们一开始跟风搞ViT大模型,一张3090显卡跑一张图要两秒,可生产线一秒就要出三张检测结果,根本赶不上节奏。后来他们换成了随机森林结合HOG传统图像特征,一秒能跑十张图,准确率还比之前的ViT高了4个点,硬件成本直接降了80%,现在一个月能接十个工厂的订单,赚得盆满钵满。光伏板缺陷机器学习检测生产线实拍图
不过话说回来,也不是说大模型没用。现在很多成熟的落地方案,都是老技术扛主力,大模型打辅助。比如我见过的客服系统,90%的标准化意图识别,还是用的十年前的fastText,只有遇到那些语义模糊、没见过的用户提问,才调用大模型做处理,整体成本比全大模型方案低了90%,响应速度还快了好几倍,用户体验反而更好。
很多人一提到机器学习技术就想到GPT,想到ChatGPT,想到各种动辄千亿参数的大家伙,其实市场上90%的需求,根本不需要那么大的模型。把成熟的老技术玩明白,适配具体场景,比什么都强。
我前阵子碰到一个做物流分拣的创业者,他说他用的还是十几年前的K-means聚类做地址匹配,准确率比大模型还高,成本一年只要几千块钱,要是换成大模型,一年几十万都打不住。
这才是真实的行业现状。
未来两年,机器学习技术的破圈点藏在哪
未来两年,机器学习技术的破圈点藏在哪
我跑了小半年行业会,见了几十个做落地的团队,最大的感受就是,接下来能真的让机器学习技术走进千万小商家、走进普通人生活的,是两个方向。
第一个就是端侧轻量化机器学习。
为啥?现在大家对数据隐私的要求越来越高,医院的病历不能随便传到云端,工厂的生产数据是核心机密不能外流,银行的用户信息更不能出去,这些场景,云端AI根本玩不转,必须把模型放在本地跑。
还有就是低成本的物联网设备,之前一块带AI能力的芯片要好几百,现在随着模型压缩技术的进步,几十块甚至几块钱的单片机就能跑得起能用的机器学习模型。上个月我看MIT CSAIL刚发的成果,把原本1G的语义分割模型,压缩到了不到8M,精度掉了不到1%,直接能跑在最便宜的农业环境监测传感器上。
这意味着什么?意味着以后就连山里种果树的农民,买个几十块钱的传感器,就能本地监测病虫害,不用联网,不用交年费,买了就能用。之前很多云AI方案,按调用次数收费,小商家根本用不起,端侧轻量化起来了,才真的谈得上普惠。
第二个方向就是适配真实场景的小样本学习。
你想啊,真实产业里哪来那么多标注好的数据?你要给一个新培育的橙子品种做分级,总不可能花几万块请人标几万张图吧?很多小商家的需求,都是小众的,个性化的,根本拿不出大量标注数据。
现在最新的小样本学习成果,只要标几十张甚至十几张图,就能训出一个准确率90%以上的可用模型,这才是真的贴合需求啊。我上个月在展会上看到一个创业团队演示的小样本茶叶分级,只标了30张不同等级的茶叶图,模型准确率就到了91%,比之前标一万张的老模型差不了2个点,当时我就觉得,这才是踩对了点。
说白了,机器学习技术搞了这么多年,早就过了堆参数刷榜的时代了。能沉下心解决一个个具体的小问题,能让果农多赚点钱,能让工厂少出点废品,能让小商家用得起AI,这才是真正有价值的方向啊。