复杂系统建模:跳出线性思维解决真实世界的真问题
前阵子跟做城市规划的朋友吃饭,他拍着桌子吐槽,说以前做新城路网规划,按老的线性模型算出来的拥堵指数,放到实际运行后全错。
差多少?
最少差了一倍。
后来换了复杂系统建模重新跑,才对上数。
 城市通勤流量复杂系统建模热力图
以前做研究搞计算,总习惯把问题拆成一块块独立的变量,控制变量算完再拼出结果。这套方法在简单系统里好用,放到真实世界的复杂问题里,一跑就崩。
1+1远大于2,还可能等于0,复杂系统里,各个要素之间的动态关联,比要素本身的属性重要一万倍。
新冠大流行那两年,不少机构一开始预测感染人数错得离谱,核心问题就是把传播当成了线性过程,没把人员流动的随机关联、不同场所的传播概率差这些非线性特性放进模型里。
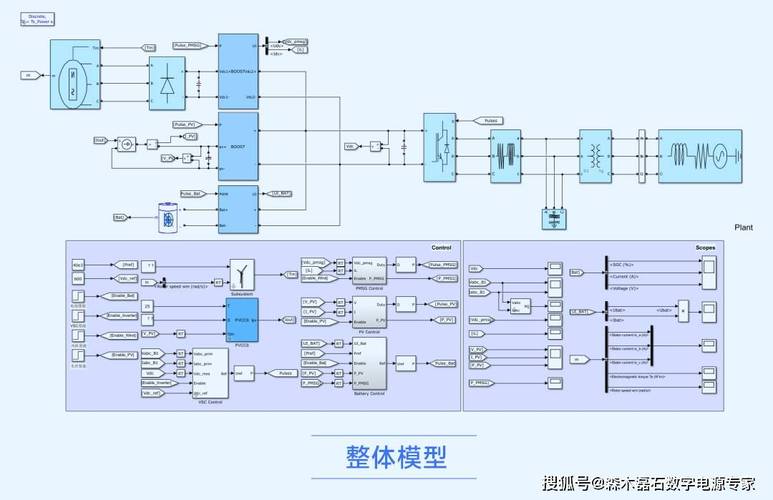 新能源电网复杂系统建模仿真界面
生态保护里算濒危物种恢复、外来物种入侵,以前都是专家凭经验估,现在把整个食物链的动态互动都放进模型,能算出十年后某个物种的种群变化,准度比以前高太多。
说实话,金融市场本来就是最典型的复杂系统,无数交易者互相影响,政策消息随时扰动,以前那些线性的股价预测模型,亏得底裤都没了,现在不少头部对冲基金,都在用复杂系统建模捕捉非线性的隐藏关联,胜率确实提升了不少。
不过话说回来,它也不是点石成金的魔法。
 入门复杂系统建模最容易踩的几个坑
我接触过不少刚上手的研究者,还有转行做业务分析的人,十有八九会踩同一个坑。
一上来就拼命堆变量堆算法,觉得变量加得越多,模型越复杂,结果就越准。
完全错了。
复杂系统建模的核心是抓住关键关联,不是堆变量。
我认识一个博士生,做产业园区碳排放建模,前前后后加了快一百个变量,跑出来的结果方差大得离谱,连他自己都不敢用。后来听了建议,把高度关联的无关变量砍掉,最后只留了二十多个核心变量,结果拟合度一下子上去了,结论也清晰多了。
还有第二个坑,就是迷信模型能预测一切。
混沌特性本身就决定了长期精准预测不可能,复杂系统随便一个微小的初始扰动,放久了都会变成巨大的结果偏差。你非要让模型算出三年后某一天的股价,或者十年后某条路的拥堵分钟数,那不是为难人吗?
复杂系统建模最大的用处,很多时候不是给你一个百分百准确的数字,是帮你低成本试错。
你要建新城,要开发新片区,你不用等十年住满了人才知道堵不堵,用模型跑一遍不同的开发强度,不同的路网布局,就能提前排除掉那些肯定会出问题的方案,这就够了。
太坑了。很多人搞反了目的,为了追求一个漂亮的预测数字,把模型改得面目全非,最后出来的结果只能用来写论文,根本解决不了实际问题。
现在还有不少人,拿大模型直接套复杂系统问题,觉得大数据就能解决一切,其实根本没摸到门道。复杂系统有自身的演化逻辑,不是你爬一堆数据就能拟合出来的,忽略了底层的关联规律,再大的模型也出不来靠谱的结果。
这两年越来越多的行业开始接受复杂系统建模的思路,本质上不是多了一个新算法,是大家终于承认,我们面对的问题本来就不是按课本上的线性逻辑长出来的。
接受世界的复杂,才能找到解决问题的正确姿势。
别拿线性逻辑套复杂世界
你想算一个城市早高峰的通勤流量,按每条路的设计承载量简单加总去推算最终拥堵指数,算出来的结果放到实际里一对照,十有八九差出十万八千里。 因为有人临时改道绕路,有人赶时间拼车改变出行路线,突然下一场雨,整个路网的流量分布就全变了。 对吧? 这些细碎、随机、互相影响的变量,就是复杂世界的本来面目。城市通勤流量复杂系统建模热力图
以前做研究搞计算,总习惯把问题拆成一块块独立的变量,控制变量算完再拼出结果。这套方法在简单系统里好用,放到真实世界的复杂问题里,一跑就崩。
1+1远大于2,还可能等于0,复杂系统里,各个要素之间的动态关联,比要素本身的属性重要一万倍。
新冠大流行那两年,不少机构一开始预测感染人数错得离谱,核心问题就是把传播当成了线性过程,没把人员流动的随机关联、不同场所的传播概率差这些非线性特性放进模型里。
当下复杂系统建模正在解决哪些真问题
别觉得复杂系统建模都是实验室里的玄学,现在各行各业都在用它解决以前解决不了的问题。 就说现在的新能源电网,风电光伏靠天吃饭,出力波动特别大,要保证电网不宕机,调峰调频怎么弄? 以前的模型按固定出力算,根本应付不了现在超过30%新能源接入的电网,一到阴天没太阳刮大风,电网压力直接拉满。用复杂系统建模,把风力变化、光伏发电强度、用户用电习惯、储能电站的充放电节奏,甚至周边省份的电网交换功率全放进模型,模拟上百种可能的场景,就能找出最安全也最经济的调峰方案。新能源电网复杂系统建模仿真界面
生态保护里算濒危物种恢复、外来物种入侵,以前都是专家凭经验估,现在把整个食物链的动态互动都放进模型,能算出十年后某个物种的种群变化,准度比以前高太多。
说实话,金融市场本来就是最典型的复杂系统,无数交易者互相影响,政策消息随时扰动,以前那些线性的股价预测模型,亏得底裤都没了,现在不少头部对冲基金,都在用复杂系统建模捕捉非线性的隐藏关联,胜率确实提升了不少。
不过话说回来,它也不是点石成金的魔法。
入门复杂系统建模最容易踩的几个坑
入门复杂系统建模最容易踩的几个坑
我接触过不少刚上手的研究者,还有转行做业务分析的人,十有八九会踩同一个坑。
一上来就拼命堆变量堆算法,觉得变量加得越多,模型越复杂,结果就越准。
完全错了。
复杂系统建模的核心是抓住关键关联,不是堆变量。
我认识一个博士生,做产业园区碳排放建模,前前后后加了快一百个变量,跑出来的结果方差大得离谱,连他自己都不敢用。后来听了建议,把高度关联的无关变量砍掉,最后只留了二十多个核心变量,结果拟合度一下子上去了,结论也清晰多了。
还有第二个坑,就是迷信模型能预测一切。
混沌特性本身就决定了长期精准预测不可能,复杂系统随便一个微小的初始扰动,放久了都会变成巨大的结果偏差。你非要让模型算出三年后某一天的股价,或者十年后某条路的拥堵分钟数,那不是为难人吗?
复杂系统建模最大的用处,很多时候不是给你一个百分百准确的数字,是帮你低成本试错。
你要建新城,要开发新片区,你不用等十年住满了人才知道堵不堵,用模型跑一遍不同的开发强度,不同的路网布局,就能提前排除掉那些肯定会出问题的方案,这就够了。
太坑了。很多人搞反了目的,为了追求一个漂亮的预测数字,把模型改得面目全非,最后出来的结果只能用来写论文,根本解决不了实际问题。
现在还有不少人,拿大模型直接套复杂系统问题,觉得大数据就能解决一切,其实根本没摸到门道。复杂系统有自身的演化逻辑,不是你爬一堆数据就能拟合出来的,忽略了底层的关联规律,再大的模型也出不来靠谱的结果。
这两年越来越多的行业开始接受复杂系统建模的思路,本质上不是多了一个新算法,是大家终于承认,我们面对的问题本来就不是按课本上的线性逻辑长出来的。
接受世界的复杂,才能找到解决问题的正确姿势。