知识图谱构建:从乱麻到结构,我的实战笔记
先说说为什么写这篇文章。上周和几个老同事吃饭,聊到知识图谱构建,大家一致认为——这玩意看着高大上,真做起来,坑多到你怀疑人生。我也算踩过不少坑,写下这些,算是个纪念。
一、知识图谱不是“画出来的”,是“填出来的”
 一、知识图谱不是“画出来的”,是“填出来的”
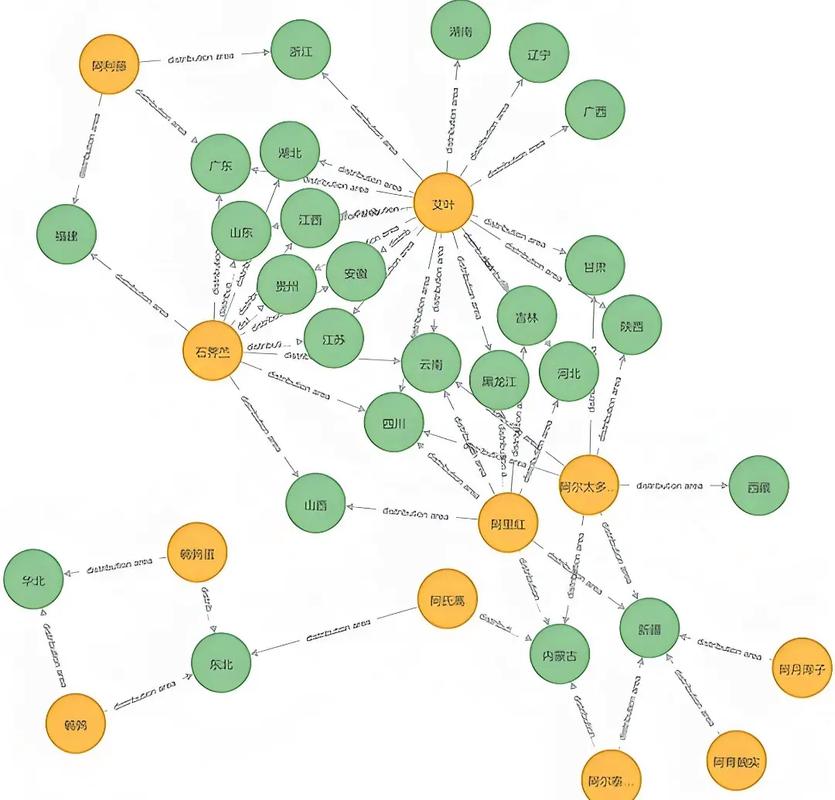
很多新人会对着知识图谱的漂亮架构图流口水,觉得那就是一堆点线连接。可实际上,构建过程远没那么优美。我们得从乱七八糟的数据里,把实体、关系、属性一个个抠出来。我参与的那个企业信息图谱项目,光数据清洗就占了一半时间。说个极端例子,爬虫抓回来的电话字段,有带区号的,有带分机的,还有写着“转”字的。这怎么敢直接入库?
而且你没法指望数据源讲道理。有的表格头是拼音,有的是英文缩写,还有的干脆是乱码。那时候我就明白了,知识图谱构建,基础工作全是体力活。
二、本体设计:定好“游戏规则”,否则后面全乱
本体设计是骨架,但这个骨架不能拍脑袋。你得把类、属性、关系想清楚。比如“人”和“组织”之间,是“雇佣”还是“属于”?同一个实体,在不同的上下文里有不同身份。我们当初就犯过二,直接从业务数据库的三张表建图谱,结果“张三”这种名字出现了十几个节点,因为没区分部门、职位和时间。
后来我们学乖了,先和业务人员一起画了一份实体关系草图,像画地图一样,把核心概念和边界标清楚,然后才动工。这份本体设计图,后来成了全项目的定海神针。
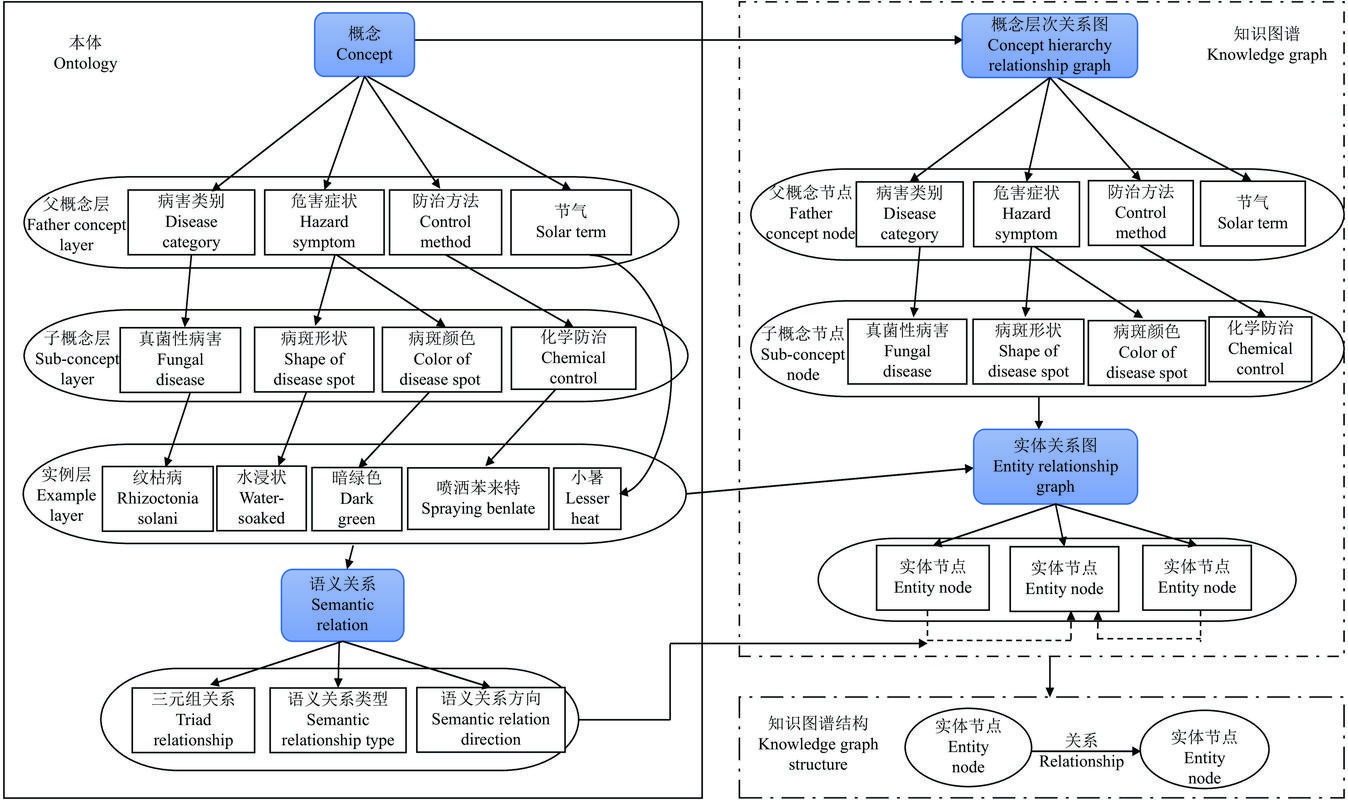 知识图谱本体设计流程示意图
三、实体链接与关系抽取:真正的硬仗
本体设计好了,数据也洗了,接下来就是让机器从文本里找实体和关系。这块我真是又爱又恨。实体链接,简单说就是判断“马云”和“Jack Ma”是不是同一个人。关系抽取,就是识别“张三在某公司任CEO”里面的“任职”关系。我们做的是学术领域图谱,作者、机构、关键词,看似明确,但操作起来一地鸡毛。
规则写了三十多条,比如“教授”后跟人名,“实验室”后接机构,但现实里总有“李教授课题组的张博士”这种嵌套,规则直接懵圈。后来我们上了BERT,效果好了一点,但模型会把“张博士”认成姓氏,而忽略他在课题组的意义。最后没辙,只能规则+模型+人工审核三层一起上。你说它科学吗?也算科学,可就是笨办法。
不过话说回来,这类工作在工业界很普遍。没有哪个完美解决方案能适配所有场景。我们只能在精度和召回率之间来回摇摆,就像调琴弦,松了不行,紧了会断。现在大模型火得不行,我们也试过用LLM来抽关系,结果它能把“张三”和“他”都指向同名同姓的另一个人,幻觉起来没边。所以,传统方法还是得留一手。
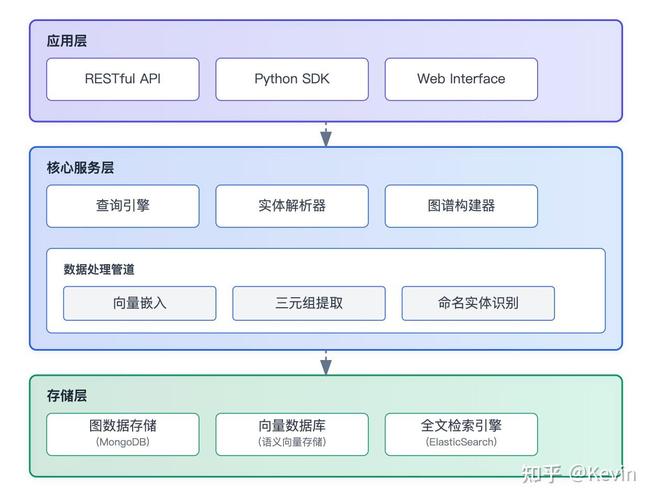 知识图谱实体消歧技术架构图
四、图存储与查询:图谱建好只是开始
 四、图存储与查询:图谱建好只是开始
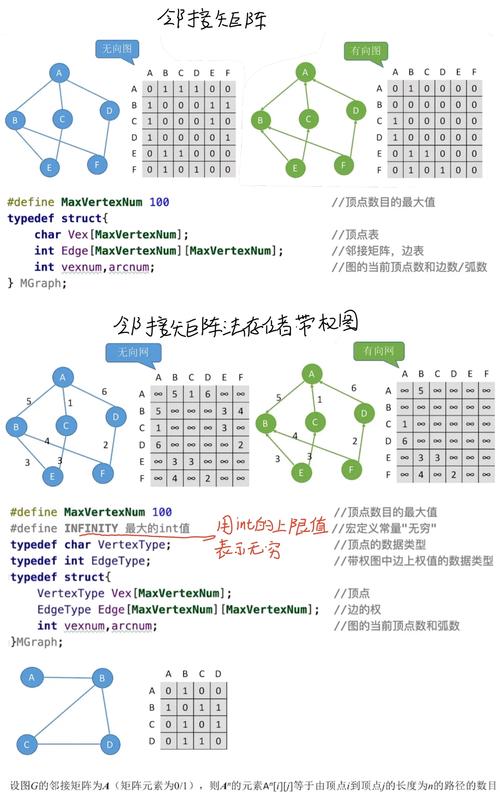
以为图谱建好就万事大吉?错了,存储和查询才是后续的噩梦。我们最初用的Neo4j,上手确实快,Cypher查询也简单。但数据量一上去,几千万节点,图谱查询就慢得像蜗牛爬。换了JanusGraph,性能上去了,运维难度也提上来了,还得自己搞定HBase或Cassandra。那段时间,我脑子里全是分布式图数据库的节点分布。
查询语言也是坑。Cypher很直观,但Gremlin那套遍历语言,一开始真能让你怀疑自己智商。我们团队花了一个多月才敢说“会用”。所以说,选型要谨慎,别光图一时爽。现在好多云厂商都推出了托管图数据库,听起来挺美,不过价格嘛……你懂的,反正我们是自己屯机器搞。
最后说一句,知识图谱构建不是简单的技术问题,更像是一个系统工程。数据、算法、存储、业务,每个环节都牵一发动全身。如果你也正在搞这个东西,希望我这些歪路能让你少踩几个坑。