推荐系统技术里的那些坑和惊喜:从双塔到LLM
说实话,每次刷抖音刷到停不下来的时候,我总在心里骂一句:这破算法怎么这么懂我?但骂完之后又接着刷。今天想跟你聊聊推荐系统技术,不是那种教科书式科普,而是从科研到工业界那些真实折腾出来的玩意儿。
先聊聊推荐系统这个“懂王”是咋炼成的
你可能不知道,推荐系统本质上就是一个“猜你喜欢”的机器。但猜这个字,背后是几代研究者的头发。从最早的UserCF、ItemCF,到矩阵分解,再到深度学习,现在大模型也掺和进来了。这一路走来,好玩的事情很多,坑也不少。
其实推荐系统最核心的步骤就两步:召回和排序。召回就是从百万甚至亿级的物品池子里,先捞出几百个候选来。排序呢,就是给这几个候选挨个打分,把最像样的排前面。听着简单吧?但每一步都有无数种骚操作。
召回阶段,以前大家喜欢用双塔模型。一个塔编码用户,一个塔编码物品,然后把它们嵌入到同一个向量空间里,点积算相似度。这玩意儿速度快,离线算好就能线上检索。但有个硬伤——用户塔和物品塔在底层一点交互都没有,就像一对相亲的男女,见面之前各自被P图师磨皮磨得亲妈都不认识,最后看对眼了也未必是真合适。
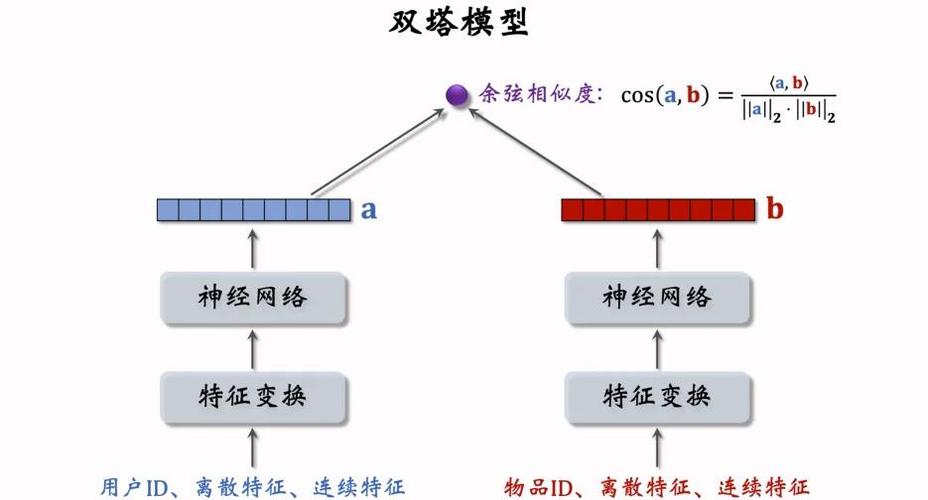 推荐系统双塔模型结构示意图
排序阶段呢,深度学习就更加花哨了。DIN用Attention去捕捉用户历史行为里的兴趣点,DIEN呢,直接建模兴趣的演化过程。我当年看这些论文的时候,心里直冒问号:这也能行?后来试了试,还真挺神的。
双塔模型:从科研到工业界的扛把子
 双塔模型:从科研到工业界的扛把子
哎,刚说完双塔的缺点,但它依然是工业界的扛把子。为啥?因为它快啊。线上推荐延迟一百毫秒以内,你哪敢上多复杂的模型?双塔模型把用户和物品都变成向量,用向量检索库比如Faiss,毫秒级就能跑完。所以哪怕有缺点,大家还是得用它做第一轮粗排。
但科研人员就不爽了,非要给双塔加交互。于是有了基于交互的双塔变种,比如用cosine similarity加上一些小技巧,或者干脆把双塔当成一个baseline,去发明新的模型。这就像手机处理器,虽然都说堆核数没用,但没人敢真的砍掉几个核。
后来又有MIND(多兴趣网络)出来说,用户的兴趣不是单一的,你用一个向量表示一个人,太粗暴了。于是它用胶囊网络,把用户的行为序列拆成多个兴趣向量。每个兴趣向量都能单独去召回物品。这个想法我很喜欢,因为现实里我就是这样,今天想看电影,明天想打游戏,后天可能就想学习(但是从来不会)。
多兴趣与图神经网络:那些更花哨的玩法
MIND之后,图神经网络又火了。推荐系统里天然有图结构:用户和物品是节点,行为是边。LightGCN直接把上层的非线性变换全砍了,就留一个邻域聚合,反而更有效。我一开始觉得这不就是玄学吗?后来看到理论分析说光图卷积本身就是低通滤波,才明白人家是有理有据的。
不过说实话,图神经网络在工业界的应用并没有想象中那么广,因为构建用户-物品二分图,训练实体链接,这些都是工程上的大活。很多公司吹牛说我们用GNN,其实也就是在特征里加了个邻居特征。
感觉话题扯远了,还是说回多目标。推荐系统不只是预测点击率,还得兼顾收藏、转发、时长,甚至广告收入。于是多目标学习成了标配。ESMM算是经典,它把点击率和转化率联合建模,避免了样本选择偏差。但真实场景里,目标之间经常打架,比如点击率和内容质量,有时候就是矛盾的。这时候就得靠一些“调参玄学”来治。
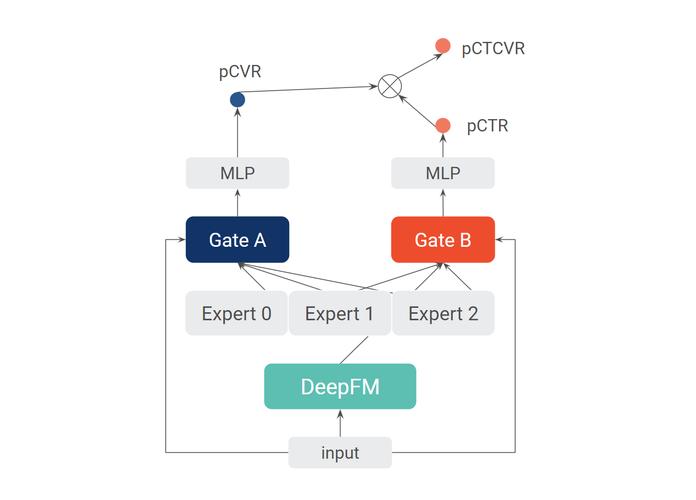 多目标推荐排名模型ESMM架构图
现在的大模型来了,推荐系统又要变天?
 现在的大模型来了,推荐系统又要变天?
今年最热的是什么?大语言模型,LLM。大家都在想能不能把ChatGPT塞进推荐系统里。目前至少有两个方向:一是用LLM生成用户画像,把用户历史行为喂给它,让它总结出一些标签,然后把这些标签当特征用。二是用LLM做生成式推荐,直接生成一个物品列表,而不是一个个打分。听起来很酷,但实际落地还早得很,推理延迟太高了,工业界还是先用小模型凑合。
不过另一个趋势倒是立马能用的:多模态推荐。以前我们只懂文本特征,现在图片、视频、音频都可以用预训练模型抽向量。我最近看到一篇工作,直接用CLIP的特征来做序列推荐,效果还挺惊喜。
但说句实话,推荐系统的核心痛点从来不是模型天花板,而是冷启动和数据偏差。冷启动是真正的难题,新用户新物品没有历史行为,模型只能瞎猜。有些公司用随机探索来缓解,但代价是短期体验下降。数据偏差呢,反馈偏差,popularity bias,那些都是老生常谈了,可惜说归说,没几个人真正解决得了。
反正吧,推荐系统技术这条路,没有终点。科研和工业界互相拉扯,今天你出个新模型,明天我加点工程优化。我们这些吃瓜群众,就只能一边享受“懂王”的便利,一边骂着“为什么我明明点了不感兴趣,它还是给我推”,这就是命吧。