机器学习技术这十年:从实验室玄学到工厂流水线
最近跟老同学聚餐,聊起近况,有人问我:“你天天搞机器学习,是不是就是弄个模型,扔一堆数据,然后它就什么都懂了?” 我差点把嘴里的啤酒喷出来。懂个屁啊!我倒是想这样,可惜现实没那么爽。
说实话,机器学习技术这几年确实是火得发烫。从人脸识别到语音助手,从推荐算法到自动驾驶,好像哪个行业不沾点机器学习就显得落后。但你要真去问那些高谈阔论的人,他们多半也说不清这技术到底神奇在哪,又有什么坑。今天我也不准备给你上课,就是随便聊聊这十年我自己做研究的感受,顺便扒一扒那些被吹上天的突破背后,都是些什么玩意儿。
机器学习技术到底在学什么?
先别笑,这个问题看着简单,但真没几个人能一句话说清楚。官方的定义是:从数据中自动学习规律,并用来预测或决策。对吧,像人话吗?好,我换种说法。小时候你学认猫,听大人说“这是猫”,指了几次之后,你脑子里就形成了一种说不清道不明的“猫的感觉”。以后哪怕看到一只从没见过的橘猫,你也能认出来。机器学习技术干的差不多就是这么回事,只不过它特别蠢,需要喂几千几万张照片,才能勉强磨出那种感觉。
这里面有个关键的科学成果,就是反向传播算法。这玩意儿1986年就被提出来了,你们敢信?现在的深度学习能这么火,靠的还是这个老底子。原理也简单,就是算错了,把误差一层层往回转,调整每一个神经元的权重,让下次更准一点。听起来枯燥,但如果你仔细琢磨,会发现这招相当粗暴又有效。就像你投篮不准,试了几次之后,手感上默默调整了出手的角度和力度——只不过模型把这套动作重复了几百万次。
对了,还有一件很重要的事,机器学习技术里那个“学”字,其实是个巨大的坑。因为很多模型根本不是在“学”,而是在“背”。模型会把训练数据里的模式记得死死的,换个新场景立马抓瞎。这就是为什么很多研究论文里测试效果贼好,一上线就翻车。行话叫过拟合。你要是没见过那种场景,我建议你去看看某些智能客服,简直是人工智障的巅峰。
这两年的大爆发:自监督学习和Transformer
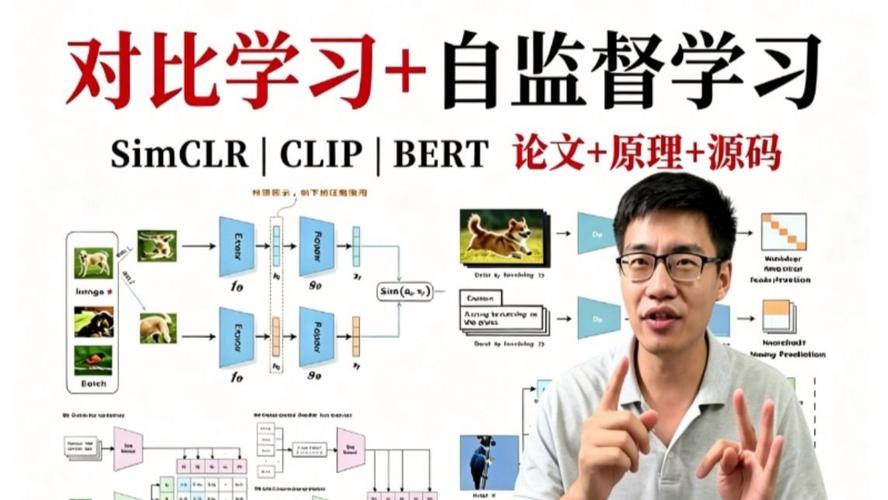 这两年的大爆发:自监督学习和Transformer
不过话又说回来,近五年机器学习技术确实迎来了一波真正的革命,不是那种微调,而是整个范式都变了。2017年,Google提了个东西叫Transformer,这本来是给机器翻译用的,结果大家发现这玩意儿的规模效应太吓人了。原来的RNN能处理100个词就喘得不行,Transformer一上来就是几千上万,而且还能并行计算。这就好比以前是骑着自行车送快递,现在直接换成了高铁,虽然代价是费能源。
更颠覆的是自监督学习这个概念。以前训练一个模型,需要人工标注数据,比如给每张图片写上“这个是猫,那个是狗”。这活儿又累又花钱。自监督学习呢?干脆不让你标了,直接让模型自己给自己出题。举个例子,把一张图片盖住一半,让它猜另一半是啥。就这么一个看似简单的思路,直接带飞了整个行业。OpenAI搞的GPT系列就是靠这招,把互联网上几乎所有公开文本都喂给模型,让它做填词游戏。结果呢?填着填着,它居然就懂了些常识,还能写诗、帮你写代码,甚至能一本正经地胡说八道。
这让我想起2020年那会儿,我第一次用GPT-3的API,输入一句“给我写个段子”,它回复了个冷笑话,我当时还真愣了一下。虽然现在看也不算多好笑,但对于那会儿的我来说,那种感觉只能用“背后发凉”来形容。机器学习技术本质上是在做模式匹配,但模式匹配到了极致,居然能涌现出某种类似智能的东西——这事儿到现在科学家也没完全解释清楚。
现实很骨感:你以为的AI不是你以为的AI
但是!注意这里有个大大的“但是”。你要是以为机器学习技术已经成熟到可以随便用在所有场景了,那真是too young too simple。且不说那些伦理问题,单是工程化这一关就够喝一壶的。
去年我帮一家工厂做质检系统的原型,他们想用机器学习识别零件上的划痕。数据呢?好家伙,几万张照片,但划痕的种类、角度、光线条件简直是千奇百怪。我们团队花了两周调模型,实验记录翻了好几页,最后准确率还是卡在93%左右。93%听起来很高对吧?但对工厂来说,漏检一个坏零件可能就意味着客户投诉甚至订单流失。不得已,最后还是得靠人工复检一遍。
这就是机器学习技术最坑爹的地方:它不是万能的。它需要高质量的数据,需要足够强的算力,还需要领域知识去喂它。三个缺一不可。你光有个模型,没有好数据,那就是垃圾进垃圾出。更别说那些所谓的大模型,训练一次的成本够在二线城市付个首付了。普通人想玩?实验室里的硅谷巨头早就把门槛抬到天上去了。
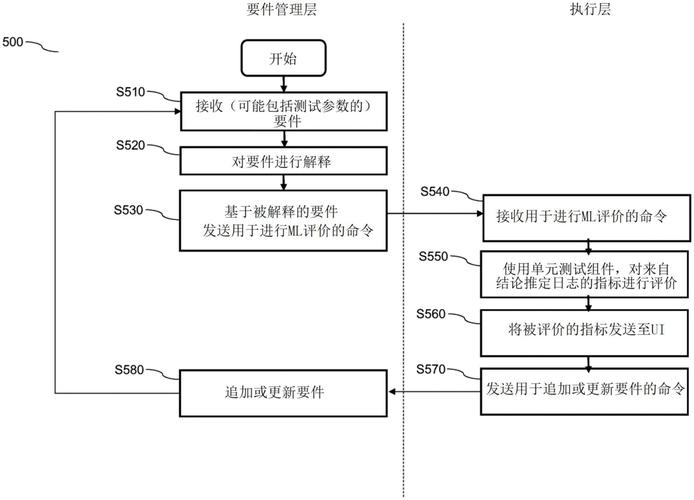 机器学习技术工厂质检模型训练数据标注流程图
还有那个老生常谈的可解释性问题。你问模型为什么判断这个零件有划痕?它给你一个概率值,0.97,然后呢?没了。它不会像人一样说“因为这里有一条深度超过0.2毫米的裂纹,而且光照反射异常”。这是很多传统行业没法接受机器学习技术的原因。医疗、金融、司法,哪个敢用一个说不出理由的模型来做决策?前几年欧洲那边搞了个GDPR,里面就有个“解释权”条款,说白了就是逼着你把模型的逻辑说清楚。可现在的研究方向,要么是画一堆热力图,要么是搞简化版模型,真正能让人完全理解的,几乎没有。这让我想起一个笑话:一个机器学习工程师被问到怎么解释模型,他说“我可以给你一个公式,但你肯定看不懂”。
 深度学习模型可解释性热力示意图
技术终究要落地:别总仰望星空
我最近在思考一个问题,机器学习技术经过这么些年的野蛮生长,现在是不是该进入“工匠时代”了?以前大家都在拼模型结构,比谁的精度高几个点,发论文灌水。可现在呢,大模型的基础架构已经趋于稳定,互相卷来卷去也就那样。反而是怎么把技术真正用起来,解决实际问题,成了最难的部分。
举个例子,去年Nature上发了篇文章,讲的是用深度学习预测蛋白质结构,就是AlphaFold那帮人。人家真的做出了一个能用的工具,把困扰生物学五十年的问题解决了大半。这才是机器学习技术的正确玩法——不是坐在冷气房里刷排行榜,而是跟其他领域的专家粘在一起,把数据、业务和模型揉成一团,最后搞出一个能改变世界的玩意儿。
不过话说回来,这种“高光时刻”还是太少了。大部分机器学习技术的应用,都还是在跟脏活累活打交道。清理数据、处理缺失值、调整参数、部署模型……说实话,我每天干的基本上都是这些。有时候在电脑前坐了一整天,就为了把那几个百分点的准确率抠出来,感觉跟修水管似的。但换个角度想,正是这些不起眼的脏活,才支撑起了那些光鲜亮丽的演示视频。机器学习技术没你想得那么神,但也绝没那么弱。就看你怎么用了。
所以,下次再听到有人吹嘘他的模型“效果惊人”的时候,我建议你先问他几个问题:训练数据哪来的?在什么场景下测试的?遇到没见过的数据能撑住吗?多半他会支支吾吾说不出个所以然。机器学习技术终究是人做出来的工具,而工具嘛,好用不好用,还得看你的手艺和耐心。
好了,今天啰嗦了这么多,也不是想给你什么结论。就是跟你聊聊我的真实感受。要是哪天你也想试着玩一玩,我建议你从简单的数据集开始,比如那个什么鸢尾花分类,先跑通一个简单的模型,再慢慢折腾。这个过程,保证让你又爱又恨。
——完