优化算法应用:别被论文骗了,实际用起来全是坑
说实话,每次看到新鲜出炉的优化算法论文,我第一反应不是赞叹,而是发愁。又来了一个看起来很美的东西,但真正落地的时候,鬼知道要踩多少坑。今天不聊那些花里胡哨的数学推导,就说说优化算法应用里那些真刀真枪的破事——有惊喜,也有让人想摔键盘的时刻。
一、梯度下降:你以为是下山,其实是蹦极
 一、梯度下降:你以为是下山,其实是蹦极
梯度下降是个老演员了,从线性回归到深度学习,到处都有它的影子。原理嘛,简单得像个傻子——沿着梯度反方向走,总能到最低点。但实践呢?呵呵。学习率调大了,直接震荡到天边;调小了,半天挪不动一步。你以为你在优雅地下坡,实际上是在悬崖边上蹦极,一不小心就粉身碎骨。
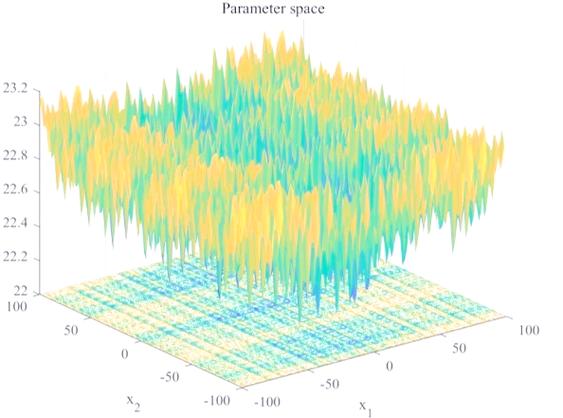
最离谱的是,很多文章里画的那个损失函数曲面,光滑得像个游泳池。现实中的损失函数什么样?全是刺猬。局部极小值、鞍点、平坦区域,一个比一个阴险。我记得有次训练一个推荐模型,损失卡在0.23死活下不去,换了三个初始化,终于有一次跳出来了——然后掉了0.01,就再也动不了。那种感觉,就像你辛辛苦苦爬了十层楼,发现上面还有一百层。
不过话说回来,梯度下降有个变种叫Adam,自带自适应学习率,省心不少。但Adam也不是万能药,有时候会收敛到尖锐极小值,泛化能力差。所以现在我一般先用Adam热身,再换SGD精调——这招还是从红迪网友那学的,别说,真管用。
二、遗传算法:万物皆可进化,但别让参数背锅
遗传算法是个万金油,只要你能把解编码成染色体,它就敢给你进化。但实际用起来,你会发现最难的其实不是算法本身,而是怎么设置那些参数——种群大小、交叉率、变异率、选择压力……每个都是玄学。
之前做过一个调度优化项目,用了遗传算法。初始种群设了50,迭代200代,结果解的质量一直上不去。我怀疑是变异率太低,从0.01调到0.1,好了点,但也没质变。后来一怒之下把种群加大到200,跑了一晚上,第二天早上看结果——好家伙,解的质量直接起飞,但运行时间多了十倍。项目经理问我为什么这么慢,我只能说,这是为了探索更广阔的搜索空间,其实心里想的是,咱们还不如用模拟退火呢。
最搞笑的是,有一次我发现自己写了个bug,适应度函数里有个括号括错了,导致所有个体都被同等评价。结果算法跑得飞快,但解完全是随机的。我还傻傻地调了三天参数,最后才定位到那个括号。所以说,优化算法应用里,bug的概率永远比算法失效的概率高十倍。
另外,别迷信什么“自适应参数”。听起来高大上,实际很多就是设了个初始值然后随便变变。真正有用的是你在跑实验前先做个小规模扫描,看看参数敏感性。不然,你调参调了个寂寞。
三、实战案例:物流调度里的粒子群优化
 三、实战案例:物流调度里的粒子群优化
去年帮一家第三方物流公司做配送路径优化。他们有几十辆车,每天要从仓库往一百多个网点送货。原来靠老师傅凭经验排路线,后来遇到油价暴涨,老板觉得得搞个智能算法压压成本。于是我们上了粒子群优化(PSO)。
PSO这家伙,模拟鸟群找食,思路很直白。但真正落地的时候,问题就来了。首先,路径规划不是连续优化,是离散的。你得把每个网点的访问顺序编码成粒子位置,然后硬生生地用速度公式更新——那感觉就像让一只鸟在棋盘上飞,还得撞边界。
我们用了很多技巧,比如交换序、2-opt局部搜索,才勉强让算法收敛。最崩溃的是,现实问题里还有其他约束:车辆容量、时间窗、司机休息时间……你可以把惩罚函数堆上去,但惩罚系数大了,算法就只顾着避罚,忘了优化路径;系数小了,出来一堆超载、超时的“垃圾”解。
后来我们学乖了,先跑一遍启发式规则生成初始解,再用PSO去优化。效果还不错——最终每辆车每天少跑了12%的里程。老板很开心,但我们很清楚,这里面有一半功劳要算在初始解上,PSO只是锦上添花而已。
对了,那个物流公司的老师傅看过我们输出的路线后,说了一句特别扎心的话:“这不就是按区域分一下吗?我也能排。”——你说气不气?但事实是,我们确实把“区域分一下”这个隐含规则通过编码逻辑给显式化了。
四、优化算法应用的终极心得:先搞懂问题,再谈算法
写到这里,我真心觉得,优化算法应用最核心的能力不在算法的数学细节,而在——问题建模和特征提取。你用什么变量表示解?约束怎么处理?目标函数怎么设计才平滑?这些才是决定成败的关键。算法本身,真的只是工具箱里的一个扳手。
现在工业界流行把优化和机器学习结合起来。比如用神经网络预测交通流量,然后把预测结果作为优化模型的输入,做实时调度。听起来很酷,但管线一长,误差就累积。训练模型的时候准确率95%,一接入优化器,全变成噪声。我见过不止一个团队在这种地方翻车,最后只能用个简单的规则策略兜底。
还有就是,别拿学术基准测试来评估你的应用场景。TSPLIB里的算例跑得飞起,不代表你的实际路网也这样。真实的代价矩阵里充满了不对称、障碍物、施工绕行,甚至司机个人的偏好。所以,一定要自己写一套仿真器,先把数据喂饱,再让算法上场比赛。
最后聊聊调参的玄学。不管什么算法,我现在的套路都是:先跑默认真实,再随机搜索几个关键参数,最后用网格搜索精修。那些说什么“贝叶斯优化自动调参”的,你先想想贝叶斯优化本身也有参数要调,是不是套娃?
总之,优化算法应用这条路,没有捷径。多试、多错、多复盘,比读一百篇论文都管用。看到这里,你是不是也想起了自己被某个参数支配的夜晚?欢迎在评论区和我一起吐槽。
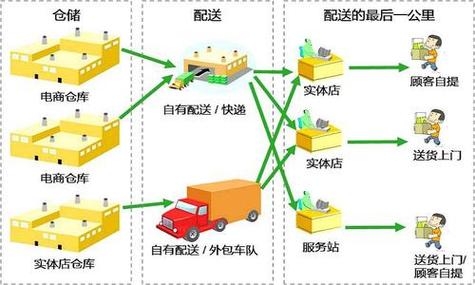 物流配送路径优化粒子群算法示意图
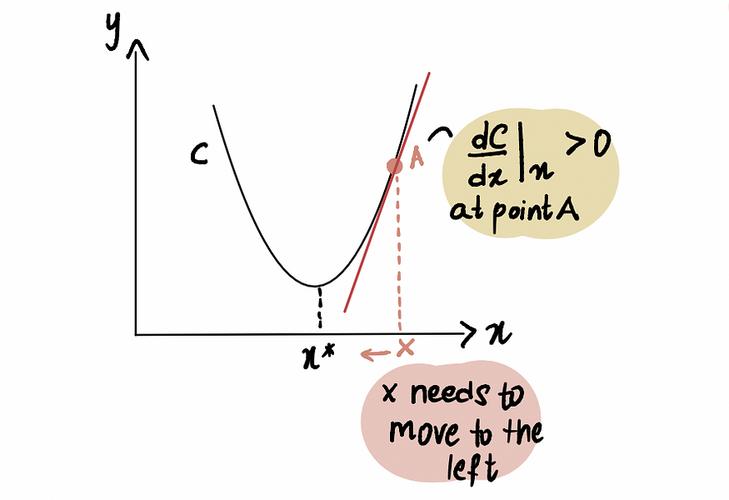 梯度下降损失函数局部极小值示意图