在线教育技术:那些论文没告诉你的坑与惊喜
说实话,这几年在线教育技术被吹上了天。资本、流量、AI、元宇宙,什么热就往上蹭。我在这个行业摸爬滚打挺久了,也看过不少顶会论文,但真正落地的时候,感觉完全不是那么回事儿。今天不聊大道理,就聊点实在的——那些藏在实验数据背后的东西,以及我踩过的坑。
也许你还记得2020年,全中国学生被迫上网课。那时候平台卡成狗,老师变身主播,家长化身网管。但就是从那时候起,在线教育技术算是真正进入普通人的生活了。不过,热潮退去,我反而觉得,一些真正有意思的科研成果,才刚刚浮出水面。
自适应学习系统:真的能因材施教?
自适应学习,听起来很美好对吧?系统通过算法分析你的表现,自动推送合适的内容。我见过不少创业公司,拿这个当卖点,PPT做得天花乱坠。但说实话,大多数系统的“自适应”只是虚晃一枪。它们用的是基于知识点掌握度矩阵的推荐,说白了,就是统计模型——你错得多就多给你做题。这跟真正的“因材施教”差远了。
有一篇2020年的元分析研究(我忘了具体作者),综述了几十个自适应学习系统的实验结果,结论是:平均效应量只有0.15到0.3之间。这是什么概念?相当于一个学生从班级倒数,努力一把,能勉强摸到中游。而且,这些实验基本都是短期、小样本。放到真实的大规模课堂,学生背景千差万别,一个小小的网络延迟就可能让系统判断失灵。
不过话说回来,也别一棒子打死。我见过一个针对数学科目的系统,它用贝叶斯网络做学生模型,而且允许学生“跳过”题目,结果准确率还挺高。关键是,它把“放弃”也当成一种学习行为来建模——这比那些只会记录对错的系统聪明多了。我就想问:为什么那么多系统,偏偏把“学生说不会”这种事当成错误呢?
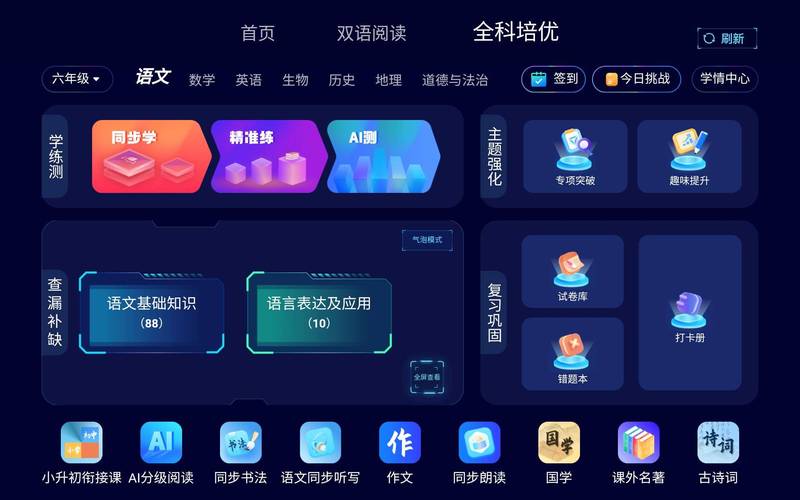 自适应学习系统学生知识掌握度可视化界面图
看视频课=真学习?多模态技术拆穿你
在线教育最大的痛点是什么?不是内容不好,是没人盯着你学。有研究表明,学生在观看教学视频时,注意力平均只能维持6到8分钟。而且,很多人开着视频,人早跑了。于是“学习情感识别”成了热门方向。
你可能听说过“多模态学习分析”——把摄像头、麦克风、眼动仪、甚至脑电波全用上,来判断你到底有没有在听。我读过一篇2022年的论文,在edX平台上做了实验,用面部表情和姿态估计来预测学生什么时候会退出视频。结果发现,“无聊”的表情出现的越早,退出的概率越高。这简直是用脚趾头都能想出来的结论,对吧?
但真正让我吃惊的是另一项研究。他们用可穿戴手环测皮肤电导率,发现学生在做练习时,如果系统给出即时反馈,虽然短期内成就感上升,但记忆保持率反而下降了。为什么?因为即时反馈破坏了那种“绞尽脑汁”的编码过程。这让我想起自己以前用某些背单词软件,刷到爽,但是全忘了——现在终于有科学解释了。
不过说实话,多模态技术设备昂贵,隐私问题一抓一大把。我在课上用麦克风阵列尝试采集语音,结果被学生投诉“侵犯隐私”。所以,很多技术可以挂在论文上,但真正落地,还得靠轻量级方案。比如现在有通过键盘输入节奏和鼠标轨迹来判断“迷茫”状态的研究,成本低,学生们也没那么反感。
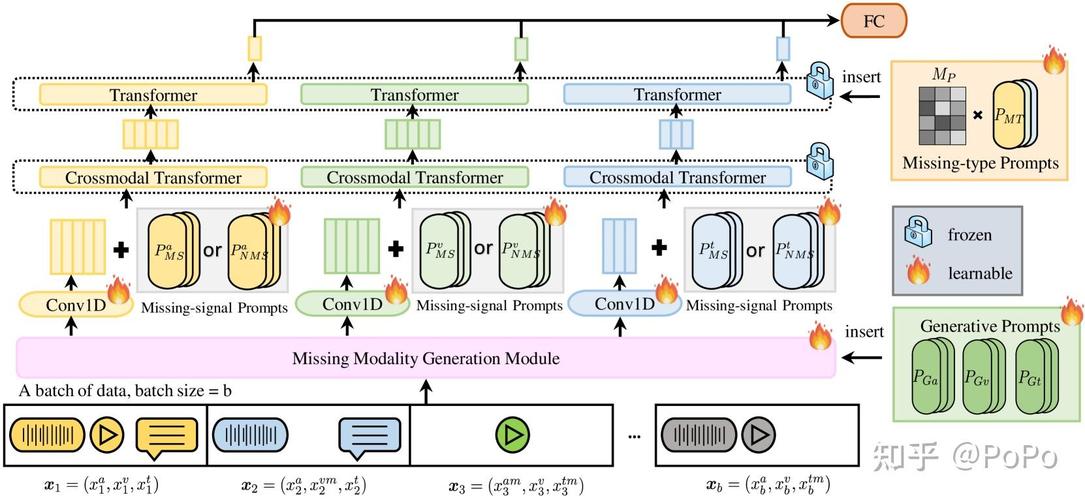 多模态在线学习行为数据采集场景示意图
生成式AI助教:又爱又恨
今年大模型火得一塌糊涂,教育圈儿怎么可能坐着不动?斯坦福和清华大学都发布了系列的AI助教系统研究。说实话,我试过用ChatGPT当助教,结果它确实能解答大部分问题,但也会一本正经地胡说八道。
有一篇2023年的预印本,探讨了在在线讨论区用GPT-4来回答学生问题。研究发现,它能让学生的等待时间从30分钟缩短到3分钟,但正确率却只有73%。如果是在编程课,学生可能被误导。更离谱的是,模型会“过度自信”地提供错误解决方案,而且说话的语气特别肯定,导致学生怀疑自己多于怀疑AI。
还有一项研究,让AI扮演苏格拉底式提问者,引导学生自己思考。这个方法倒是挺靠谱,因为它的本质是“少说多问”,避免了满嘴跑火车。不过我自己的经验是,AI只能学生问一次,一旦追问“为什么”,它就容易绕回到标准答案了。所以,生成式AI能当助教,但只能当“初级助教”,必须有人工在旁把关。
其实,我觉得最值得关注的技术不在这个层面,而是自然语言处理在教育中的另一面——自动批改作文。不用管什么基于transformer的评分模型,实际上不少研究都表明,机器评分和人工评分的相关性已经达到0.8以上。但问题是,机器只认字数、辞藻,它完全不懂什么叫“真情实感”。我见过一篇论文,居然把一篇情感浓郁的文章判成了抄袭,因为它使用的词语组合太“经典”。你说气不气?
那么,科研成果到底怎么用?
 那么,科研成果到底怎么用?
聊了这么多,我要说点掏心窝子的话。
首先,别迷信顶会论文。很多很好的idea,在实验室里很美,但一遇到现实网络、设备、学生素质就垮了。作为从业者,我们最需要做的是“容错”设计——比如视频播放器可以变速,但不要太快,因为研究表明2倍速度听新知识,理解和记忆都会打折。
其次,数据隐私是悬在在线教育头上的剑。我认识一个做学习分析的专家,他说他们的研究之所以不敢公开数据,就是怕学生有一天要求“删除数据”而无法操作。这个矛盾,短期内无解。
再者,观察学生的“退课信号”比预测“成绩”更重要。我们已经有了大量关于“流失”的研究,但真正去干预的少。比如,有研究提出“情感提醒”系统,当学生表现出焦虑时,自动推送鼓励或调整难度。效果还不错,但让机器人来鼓励人,总觉得有点像电子宠物。
说到底,在线教育技术不是要取代老师,而是要让老师少干点重复劳动,多点时间陪伴学生。可现实呢?我们花了大价钱装了各种系统,老师变得更累了——因为要填更多的表,看更多的数据。这就背离了初心,你说对吧?
我始终相信,技术是好的,但人不是数据点。下回再有人跟你吹“AI教育”,你多问一句:“你的模型在真实课堂上验证过吗?能应对学生突然关摄像头吗?”大概就能挤掉不少水分。
好了,就先聊到这。这也算是我这些年做研究、做产品留下的真实感悟吧。希望你看完对“在线教育技术”有自己的判断。