机器人控制技术:从MPC到强化学习,调参侠的癫狂指南
我现在还记得第一次调试机械臂时的崩溃——明明仿真里跑得完美,一到实物就抽风。后来才知道,这玩意儿叫“现实鸿沟”,机器人控制领域的老大难。哎,说起机器人控制技术,外行看着酷炫,内行心里全是泪。但这几年,变化快得让人跟不上。说实话,有时候我真的怀疑,我们是不是在跟物理定律死磕?
模型预测控制,可不是“预测未来”那么简单
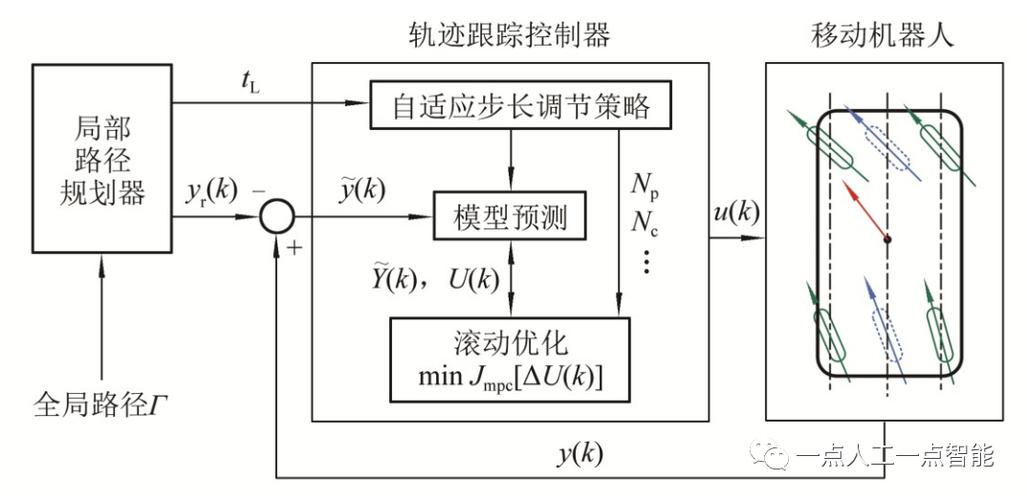 模型预测控制移动机器人轨迹跟踪示意图
MPC这玩意儿的原理,说白了就是:在每一个时刻,都去计算未来一段时间的动作序列,使得某个代价函数最小,然后只执行第一步,下一秒又重新计算。这叫什么?滚动优化。听起来很高级,对吧?但实际上,它就是个贪心的有限时域优化。用过的都知道,MPC稳是真的稳,但吃算力也是真的猛,实时性要求一高,你的控制器就得跟CPU干瞪眼。参数多到让人头秃——预测步长、控制步长、权重矩阵……调参调得我直骂娘。有个同事,调一组参数调了三个月,最后发现不如随机搜索……不过话说回来,MPC在自动驾驶和无人机上已经成标配了,因为能处理约束,这是很多方法做不到的。现在还有一个趋势,叫基于学习的MPC,用神经网络去学那个预测模型,速度更快,就是偶尔会飘。学术界论文一刷一大把,但工程落地还是坑。
强化学习:让机器人自己“悟”出步态
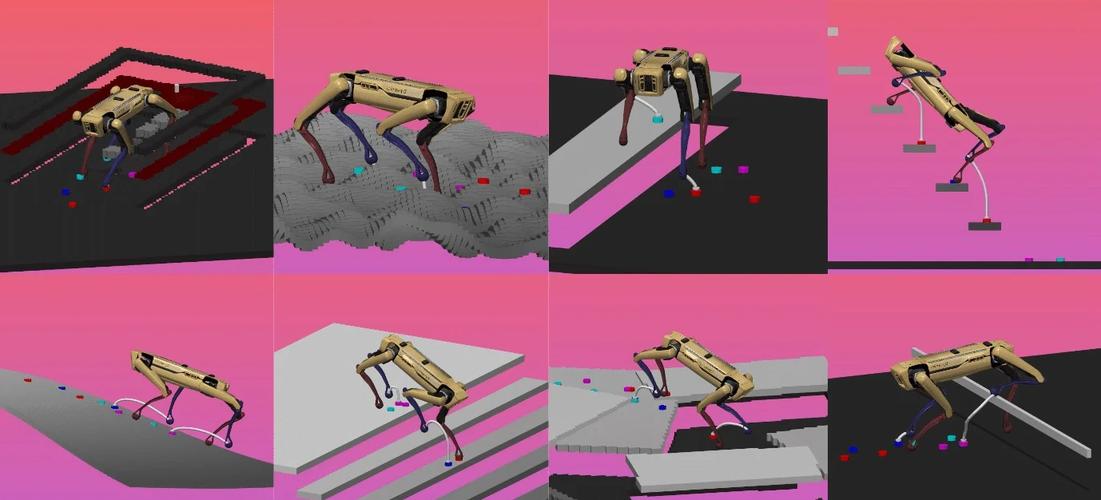 四足机器人强化学习步态训练过程
这几年,强化学习在机器人控制上太火了,简直有点魔幻。看波士顿动力那个Atlas的后空翻,你以为是RL?他们其实魔改了很多传统控制。但学术圈,ETH的ANYmal用RL硬是训出了能在碎石上疯跑的步态,论文一出,全世界都炸了。训练过程有多搞笑?一开始的机器人就像喝了假酒,摔得五花八门,电机还发出怪叫,大半夜地吓坏保安。但只要你奖励函数设得巧,它就会慢慢“开窍”。奖励函数,才是RL的灵魂——太稀疏,学不到东西;太密集,机器人就学会在安全区里抖腿骗奖励。有个实验室训出个四足机器人,只会倒着走,因为倒着走耗能更低……气得学生差点没把电脑砸了。对了,人形机器人大潮一来,RL控制直接成了香饽饽,特斯拉的Optimus视频里面,多少是RL的影子?不过,从仿真到真实世界,又是一道坎,域随机化、域自适应之类的魔法都用上了,才勉强不掉链子。
落地应用,比发paper难一万倍
 落地应用,比发paper难一万倍
不是我夸张,实验室和工业现场之间,隔着好几个太平洋。实验室里光照稳定、地板平坦、通信没有延迟,一到实际场景,传感器噪声、摩擦力突变、甚至是射频干扰,分分钟让你的控制器原地爆炸。我们团队把一个看似简单的抓取任务,从仿真弄到真机,整整折腾了半年。最头疼的是,关节执行器非线性太强,你用线性模型去控制,它一发力就过冲,然后就开始抖,跟帕金森晚期似的。现在很多公司开始搞数字孪生和域随机化,就是在仿真里故意加噪声、变摩擦力,让策略学会鲁棒。还有就是安全性,机器人失控可不是闹着玩的,尤其是协作机器人和人形机器人,你总不想它突然给你一拳吧?所以工业界现在流行复合控制架构:底层用久经考验的PID或ADRC,保证绝对稳定;上层用学习算法搞智能决策,这样既安全又灵活。特斯拉放出来的那些奇怪场景,虽然有点糗,但人家敢放,这就是进步。我觉得,未来的机器人控制技术,一定是混搭风,哪有什么银弹。
哎,这行当天天有新花样,但坑也深不可测。下次见到机器人跳舞、跑酷,别忘了背后是无数工程师的脱发史和黑眼圈。得,不说了,我的机械臂又卡了,得去敲两下……