技术共享机制:为什么好心总是办不成好事?
一台闲置的电镜,把天聊死了
上个月和一位在中科院某所干活的师兄吃饭。喝到一半,他突然冒出一句:我们那台电镜,排队排到怀疑人生;可隔壁楼那台参数差不多的,一年开机不到三百小时。
我问,那为什么不打通共用?
他愣了一下,说:谁牵头?坏了谁赔?机时算谁的绩效?
三个问题,饭桌安静了两秒。
你看,技术共享机制这四个字,听着像技术活,其实从头到尾都是账本活。阻碍共享的从来不是网线,是考核表和责任书。
2018年科技部上线了国家重大科研基础设施和大型科研仪器国家网络管理平台,把海量设备信息挂了上去。出发点很好。可你去翻各地高校的实际机时利用率,会看到一个挺魔幻的现象——一边排队,一边吃灰,同一个校园里同时存在。
为什么?因为仪器所在院系要创收,共享出去等于把自己的预算让给别人。因为操作员共享一小时,考核表上不会多写一个字。因为真出了故障,追责链条上第一个挨骂的是设备管理员。
制度设计里少了一个环节:让共享这件事,对具体执行的人有好处。这话说出来很俗。可它就是全部。
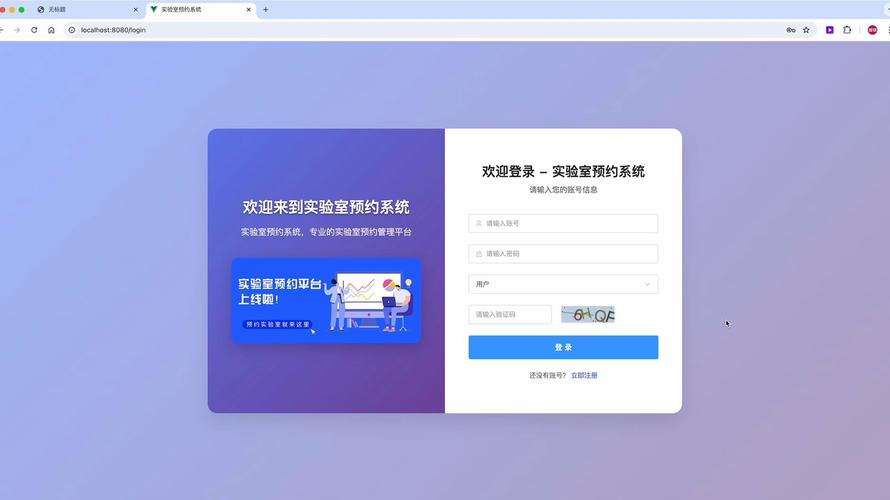 高校大型科研仪器共享平台机时预约系统界面截图
专利池:看着像分赃,本质是定价
换个场景。视频编码、通信、汽车。这些领域早就把共享玩成了生意。
MPEG LA、Via LA、Avanci,这些名字你可能不熟,但你手机里每一颗芯片、每一辆车里的通信模组,大概率都给它交过钱。它们干的事叫专利池——把几十上百家公司的标准必要专利打包,定一个统一的许可费,谁来用,一次谈完。
聪明在哪儿?把几百场一对一的扯皮,压缩成一次谈判。
没有专利池的年代,一家做机顶盒的小厂要面对几十个专利权人,法务成本比芯片成本还高。专利池给了一口价,市场反而转起来了。当然争议也不少,FRAND原则(公平、合理、无歧视)在实践中经常被吐槽执行得稀烂,费率怎么算、按整机算还是按芯片算,官司打了好多年。
国内这边的动作值得一说。2021年6月新修订的《专利法》正式引入专利开放许可制度——专利权人可以向国家知识产权局声明,愿意以特定条件许可他人实施,有意愿的人直接来谈。这其实是一个官方版的小型专利池。到2024年底,声明的开放许可数量已经上万件了。
但老实讲,热闹归热闹。真正成交的比例,嗯……不算高。原因还是那三个字:没动力。许可方觉得价格开低了,被许可方觉得反正也不急。
 标准必要专利池FRAND许可费分配结构示意图
开源这套玩法,反直觉得厉害
如果说专利池是精打细算的生意,那开源就是一场精心设计过的、看起来无私的工程。
很多人到今天还有个误解,觉得开源等于免费等于做慈善。不是的。
Linux基金会、Apache基金会、RISC-V基金会,这些组织本质上是共享基础设施的运营方。把大家都要用的那一层——内核、编译器、指令集、安全工具链——做成公共品,让所有人在上面各自卷各自的差异化产品。英特尔的芯片、谷歌的手机系统、阿里的云服务,全在这层公共品上跑。
2023年之后大模型把这场戏推向高潮。Llama放权重、DeepSeek放权重、Mistral放权重,一下子把整个行业的技术扩散速度拉快了好几年。但你去细看许可协议,门道很多——Apache 2.0算是最宽松的,Llama社区许可就带了一堆限制条款,比如月活超过七亿要单独授权。
这不是谁小气。这是一套被反复调试出来的平衡:共享到什么程度,才既能让生态长起来,又不至于把自己饿死。
OpenSSF这几年在推的那些事,比如SBOM软件物料清单、关键开源项目维护者资助计划,其实就是在补这套机制的漏洞。因为2023年xz后门事件狠狠教育了所有人一次——你依赖了二十年的那个压缩库,维护者只有一个没拿钱的志愿者。
数据共享,卡在最俗的地方
技术层面能共享的东西里,最难的是数据。
代码可以开源,设备可以预约,专利可以打包。数据不行。
医疗影像、基因序列、工业质检图、金融交易流水——每一条都带着隐私、合规、商业机密三重枷锁。《人类遗传资源管理条例》摆在那儿,医院的伦理委员会摆在那儿,数据出境的安全评估也摆在那儿。
所以这几年真正落地的方案,基本都绕开了数据搬家这条路。联邦学习让模型去数据所在的地方训练,隐私计算里的多方安全计算、可信执行环境,算的都是同一件事:让数据可用不可见。
效果不错,代价也不小。通信开销大、工程复杂度高、性能打折。真正跑通的案例,多半是大厂和头部医院、银行之间的点对点合作,还没形成那种谁都能接进来的公共网络。
这一步,我估摸着至少还得磨五年。
能活下来的机制,往往长这样
 能活下来的机制,往往长这样
把上面几个场景摞在一起看,规律挺明显。一套技术共享机制能不能跑起来,跟技术先不先进关系不大,跟下面几件事关系很大。
一是权属得清楚。谁的设备、谁的专利、谁的数据,边界模糊就一定会吵。职务科技成果赋权改革这几年在推,就是想把高校院所手里那些名义上归单位、实际上没人管的成果,明确划给个人或团队一部分。
二是贡献得能被计量。机时、代码提交、专利被引、数据调用次数——总得有个东西记下来,最后能换成绩效、换成分成、换成帽子。没有计量,共享就是纯损耗,没人干。
三是得有退出通道。开放许可可以撤回,开源项目可以改协议(虽然会被骂),数据合作可以到期终止。能被随时收回的权利,才有人愿意放出去。
四是得有人维护。这条最容易被忽略。共享平台不是建完就完事的,得有人天天处理纠纷、升级系统、回答那些琐碎到令人崩溃的问题。而这些人往往没有编制,没有经费,纯靠情怀撑着。
情怀能撑三年,撑不了十年。
我见过做得最好的一个案例,是某省把大型仪器共享的机时直接折算成职称评审的业绩分。就这么一条土办法,那个省的设备利用率一年涨了二十多个百分点。没有什么高深设计,就是让干活的人不吃亏。
所以回到开头那顿饭。我师兄那个问题,答案可能很朴素——别先想着建平台,先想清楚:设备管理员多干的这一百个小时,年底谁来给他签字。
这个问题不解决,再漂亮的共享机制,最后都会变成一份PPT。