科学计算应用正在悄悄改写科研:从超算机时到AI for Science
前几天跟一个做电池材料的朋友吃饭。他掏出手机给我看一张图,密密麻麻的原子排布,旁边一堆曲线。我问他这是啥。他说,他们团队刚用科学计算应用筛完一批固态电解质候选材料,原本打算在实验室里试两年的配方,现在先扔进超算里跑一遍。
我当时愣了一下。不是因为听不懂。是因为这东西早就不只是“算个题”了。
 超级计算机机房科学计算应用场景图
说实话,很多人对科学计算应用的印象还停留在大学机房里的 Fortran 作业。写个差分方程,跑一下,画个图,交差。完事。可现在的玩法完全变了。它更像一套“实验的平行宇宙”。现实里做一次实验要几周、几个月、几百万,计算里可能几个小时就给你一个方向。当然,方向对不对另说。但它至少能帮你排掉大量明显错误的路线。
先别管什么“算力焦虑”,科学计算应用的底层逻辑其实很朴素
剥开那些花哨名词,核心就三件事:把物理、化学、生物问题变成数值问题,把数值问题变成并行计算任务,再把结果变成人能看懂的判断。听起来简单对吧?做起来全是坑。
比如天气预报。大气方程本身是连续的,计算机只认识离散的数。于是网格要切开。全球切成几公里甚至一公里的格子。每个格子算温度、气压、风速。算完这一步,下一步又依赖上一步。时间步长还不能太大,不然数值不稳定。你稍微调大一点,模型可能直接炸给你看。所以为什么天气预报这么吃算力?不是算法不行,是物理太复杂,而我们要的精度又太贪。
我一度以为,超算就是堆 CPU。谁的核多谁牛。后来发现这个想法挺外行。现在一台顶尖机器里,CPU、GPU、专用加速器、高速网络,缺一个都别扭。GPU 适合干那种大量重复的浮点运算,CPU 适合干逻辑控制和复杂调度。MPI 管进程间通信,OpenMP 管线程,CUDA 或 HIP 管 GPU 核。写代码的人得同时伺候好几套脾气。烦。但没办法。
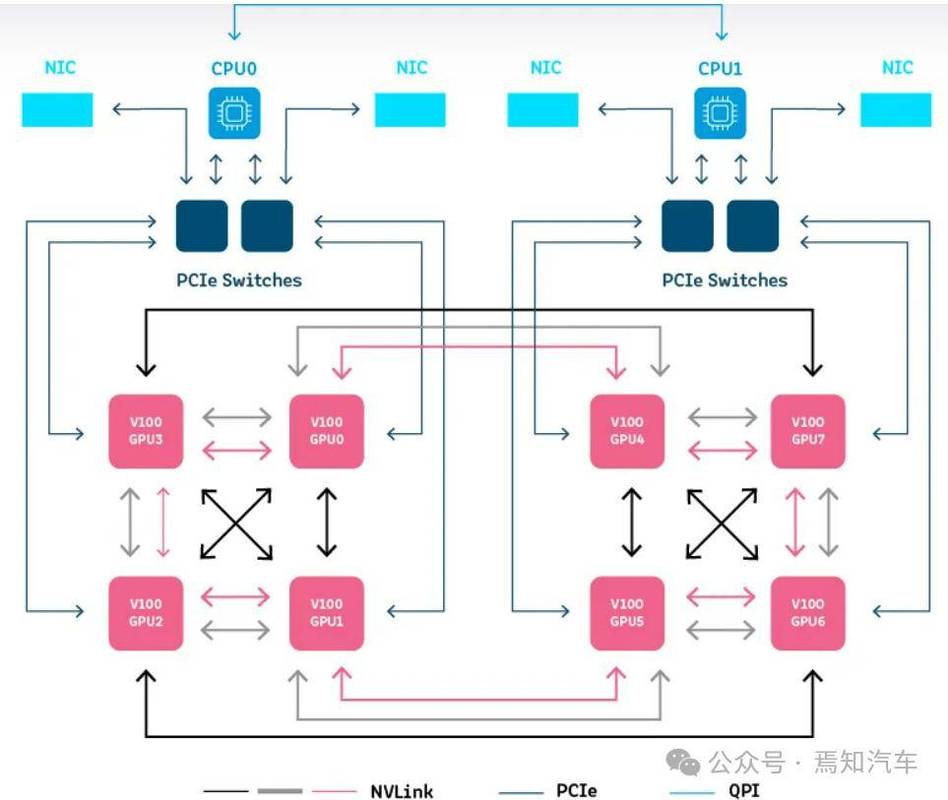 GPU加速科学计算并行架构示意图
再说一个反直觉的点。科学计算应用并不总是追求“快”。有时候追求的是“稳”。数值方法的稳定性、误差累积、收敛性,这些东西在工程里能要命。一个看起来跑得飞快的显式格式,时间步长稍大就发散。一个隐式格式稳是稳,但每一步都要解大型线性方程组。最后你发现,性能瓶颈往往不在算力,而在算法和内存带宽。数据搬来搬去的时间,比算的时间还长。这事挺气人的。
超算、GPU、AI 搅在一起,科研范式真的变了
最近几年最大的变化,是 AI 开始往科学计算里钻。不是那种“用 AI 写论文摘要”的钻。是真正跟物理模型结合。比如 PINN,物理信息神经网络,把方程残差塞进损失函数里。再比如神经算子,学的是函数到函数的映射,而不是单纯拟合几个点。还有 AI 代理模型,先拿高精度模拟生成一批数据,训练一个快速模型,然后再拿这个快速模型去做优化、控制、反演。
这就有意思了。传统科学计算像手工打磨。AI 像先画草图,再局部精修。两边各有各的毛病。纯 AI 可能不符合守恒律,算着算着能量凭空多出来,那就搞笑了。纯数值模拟又太贵,参数一多,维度一高,直接爆炸。于是现在很多团队在搞混合路线。物理约束 + 数据驱动 + 高性能计算,三件事绑在一起,才是当前科学计算应用最热的方向之一。
行业动态也很明显。Frontier、Aurora、El Capitan 这些百亿亿次级别的机器陆续上线。国内的超算中心也在往异构融合、AI for Science 平台走。软件层面,Julia 在科学计算里越来越能打,Python 生态依然霸榜,C++ 和 Fortran 继续守着性能底线。你要是去问做计算流体力学的人,他可能一边骂 Python 慢,一边用 Python 调 C++ 内核。很分裂。但这就是现实。
那些落地场景:从电池到天气预报,再到聚变堆
科学计算应用最值钱的地方,不是发论文,是解决真问题。电池材料是一个典型。锂离子迁移、界面反应、热失控,这些过程很难直接观测。用密度泛函理论算电子结构,用分子动力学算离子输运,再用机器学习势函数把精度和速度折中。整个链条跑下来,能帮实验团队把候选材料从几千种缩到几十种。别小看这个筛选。省下的时间和经费,可能是千万级别。
生物医药也一样。AlphaFold 把蛋白质结构预测往前推了一大步。但结构预测只是第一步。药物分子和靶点怎么结合?结合自由能是多少?毒性怎么估?这些还得靠分子动力学、自由能微扰、量子力学与分子力学混合方法。算力不够的时候,只能简化。简化过头,结果就不可靠。所以做这类工作的人,常年游走在“算得动”和“算得准”之间。
 分子动力学模拟蛋白质配体结合科学计算可视化图
气候和天气更不用说了。数值天气预报基本就是科学计算应用的老牌战场。现在再加上 AI 气象大模型,比如用历史再分析数据训练,推理速度比传统数值模式快几个数量级。但问题也来了。极端天气、长期气候响应,AI 模型能不能抓住?物理一致性够不够?这些还没有定论。不过话说回来,传统模式也不是完美无缺。两条路大概率会长期并存,互相掐,也互相补。
还有个特别硬核的方向:聚变。托卡马克里的等离子体湍流,磁流体力学,射频波加热,这些模拟动不动就是上亿网格、数十万时间步。国际热核聚变实验堆相关的计算项目,经常要占用顶级超算的大块机时。你说这值吗?从短期看,烧钱。从长期看,如果聚变真能落地,这点计算投入连零头都算不上。
想入门?别一上来就啃 MPI,先搞清楚你要算什么
如果你是对科学计算应用感兴趣的学生,或者刚转行过来的工程师。我的建议可能有点泼冷水。别急着学一堆工具。先问自己:我要解决什么问题?是解偏微分方程?是优化?是统计分析?还是机器学习?问题不一样,技术栈完全不一样。
偏微分方程,老老实实学数值分析、有限差分、有限元、谱方法。并行计算,先理解进程、线程、通信、同步。GPU 编程,先搞明白内存层次和并行粒度。机器学习,那就去补线性代数和概率。工具只是工具。Python 的 NumPy、SciPy、JAX,C++ 的 PETSc、Trilinos,Fortran 的老库,都有存在的理由。关键不是你会不会某个库,而是你能不能判断这个模型该不该这么算。
另外,别被“调包”骗了。调包能跑通 demo,不代表你能做科研。边界条件怎么设?网格收敛性验证了吗?时间步长选得合理吗?结果跟实验对得上吗?这些才是分水岭。我见过太多项目,代码写得漂亮,结果一塌糊涂。也见过代码丑得不行,但物理洞察极强,最后发了好文章。科学计算应用,说到底还是科学在前,计算在后。
最后扯一句。这个领域很苦。debug 数值不稳定,可能查一周。跑一个 job,排队两天,跑五分钟报错。但你真看到模拟结果和实验吻合的那一刻,还是挺爽的。那种爽,跟打游戏通关不一样。它更像是你偷偷看见了自然规律的一角。虽然只是一角。
科学计算应用不会取代实验。也不会取代理论。它只是把人类的想象力,放到一个更快的试错机器里。至于能跑多远?看算法,看算力,也看我们敢不敢问出更好的问题。