漏洞不是清单:网络安全技术研发的工程约束与验证边界
网络安全技术研发最常见的失败,不是算法不够新,而是把漏洞当成一张可穷举的清单。清单思维很诱人:扫出问题、加规则、上线、收工。现实没这么听话。系统在变,依赖在变,攻击面也在变。你昨天封住的入口,今天可能因为一次配置漂移重新打开。
这不是说检测规则没有价值。规则是必要的,尤其在边界清晰、行为稳定的场景里。问题在于,规则一旦脱离威胁建模和可观测性,就会退化成噪声生产器。网络安全技术研发的核心矛盾,不是有没有检测,而是检测在什么条件下可信。
先承认攻击面无法被穷举
威胁建模常被写成一张漂亮的图,然后被归档。真正有用的部分,是图里那些被忽略的信任边界。数据从哪来,经过谁,谁能改,改了之后谁看得见。这里不需要宏大叙事。一个内部服务把用户输入拼进日志,再被另一个服务消费,攻击面就跨了两个团队。谁负责?往往没人负责。
所以攻击面管理不能只做资产盘点。资产是静态的,调用链是动态的。更靠谱的做法,是把数据流图、权限边界和运行时调用放在同一张视图里比对。差异之处,就是研发需要解释的地方。解释不了,就先假设它可被利用。这很麻烦。但绕不开。
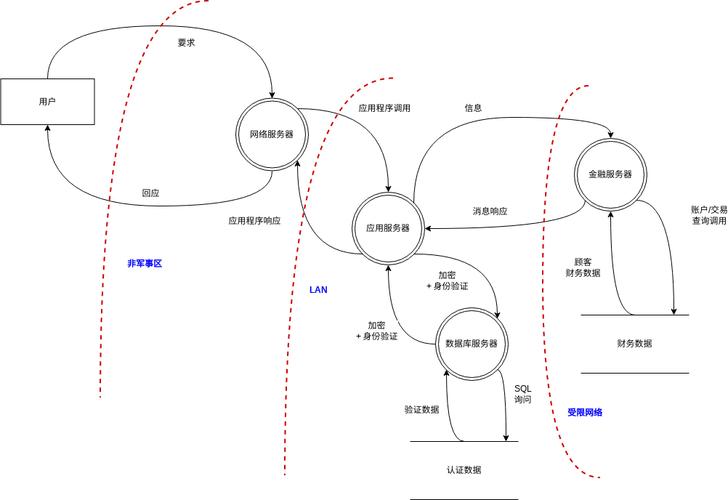 网络安全技术研发威胁建模数据流图
另一个限制是:攻击面不是越收越安全。收得太狠,业务会绕路。绕路产生影子资产。影子资产不会出现在你的清单里,却会出现在攻击者的路径里。这里没有一劳永逸的答案,只有持续的对账机制。
检测规则背后的代价函数
 检测规则背后的代价函数
写检测规则的人常盯着召回率,运营的人盯着误报。两边都没错,但只看单边就会失焦。规则的本质是一个代价函数:漏报的损失、误报的成本、维护的复杂度、对性能的侵蚀。四个变量里,任何一个被忽略,规则都会在真实环境里变形。
举个具体场景。某类注入检测如果只匹配关键字,误报会高到运营直接关掉;如果改成语法树比对,准确率上去了,但解析开销和兼容性问题又来了。怎么办?不是二选一。可运营的检测通常采用分层策略:低成本规则做粗筛,高成本分析做复核,中间用采样和上下文补足。
这里有个容易自欺的地方:demo 跑通不等于可运营。实验室里十条规则打十个样本,看起来漂亮。上线后日志量放大一千倍,告警疲劳会教人做人。规则需要版本化,需要回归集,需要和资产重要性挂钩。没有这些,规则数量只是心理安慰。
验证环节最容易自欺
验证不是跑一遍扫描器。扫描器只能证明它认识的问题,不能证明它不认识的问题。对网络安全技术研发而言,验证至少要回答三件事:攻击路径是否真实可达,检测是否在噪声中仍然有效,修复是否引入新的边界问题。
第一件事靠复现。复现环境不必豪华,但要保留关键依赖和权限配置。少了权限,漏洞可能消失;多了权限,漏洞可能放大。第二件事靠带噪测试。把正常业务流量混进去,看误报率和延迟。第三件事靠补丁回归。补丁不是终点,它可能改变调用顺序、缓存行为和错误处理。
 软件漏洞补丁回归测试环境拓扑图
我见过一种很典型的失败:补丁修了主路径,旁路接口没动。攻击者不需要正面突破,换个入口就行。验证如果只覆盖报告里的那个URL,等于没验证。更稳妥的做法,是把修复影响面写成可执行的回归用例,而不是一段文字说明。
边界:什么时候不该继续加模型
 边界:什么时候不该继续加模型
模型不是越多越好。异常检测在缺乏标签、行为漂移快的场景里,很容易变成解释不了但看起来很高级的告警源。它适合做辅助排序,不适合单独承担阻断决策。尤其当系统对延迟敏感时,复杂模型可能先把业务拖垮。
可解释性也不是装饰。运营人员需要知道为什么告警,才能决定是否隔离、回滚或忽略。黑箱模型给出的分数,如果没有特征归因和上下文,最终会被人为绕过。这里的边界很清楚:当验证成本高于风险损失,或者运营闭环无法建立时,继续堆模型只是在转移问题。
趋势不在模型更大,而在接口更硬
 趋势不在模型更大,而在接口更硬
接下来的变化,可能不在算法侧。更值得关注的是接口:安全能力如何嵌入研发流程,告警如何带着资产上下文到达正确的人,修复如何被自动化验证。接口硬了,工具才有机会被真正使用。接口软了,再好的检测也只是报告里的数字。
零信任、供应链安全、运行时防护,这些方向都在往同一个地方走:把不确定性显式化。谁能把信任假设写出来,谁能把验证条件写出来,谁就更可能少踩坑。网络安全技术研发不会因为某个新模型突然变得简单。它更像一项长期的工程对账。慢,但有效。