大数据技术研发:别急着堆机器,先把元数据和执行引擎啃下来
凌晨两点,机房温度又上来了
做大数据技术研发的人都懂。白天看板一片绿,晚上长尾任务开始磨人。CPU没打满,磁盘也没打满,任务就是卡在99%。你盯着Spark UI,stage重试三次,shuffle spill像不要钱一样往下掉。说实话,这种时候我特别烦一种说法:加机器。加机器当然爽。预算呢?
更麻烦的是,很多科研成果在论文里跑得漂亮,落到生产就变味。TPC-DS的某个变体,我们去年复现过。同一条SQL,换一种文件布局,P99能差出三倍。不是SQL写错了。也不是引擎突然罢工。问题常常藏在元数据清单、小文件数量和统计信息里。这玩意儿不性感,但它决定你的研发有没有下限。
 大数据技术研发机房服务器集群散热风道实拍
所以我现在看大数据技术研发项目,先不看它口号多响。先问三件事:数据怎么落、元数据谁管、执行引擎能不能被观测。答不上来,后面全是玄学。
湖仓一体不是魔法,是元数据服务的地狱难度
厂商PPT里的湖仓一体,像把数据湖和数据仓库一锅炖。听着很香。真做起来,第一关就是元数据一致性。Iceberg、Hudi、Delta这些开放表格式,各有各的清单结构。快照、manifest、commit log,名词一堆。研发同学得把ACID提交、快照隔离、权限和血缘串起来。否则今天能查,明天查不到。对吧,这谁受得了。
我见过一个典型坑:小文件太多。离线任务每小时写一批,文件数涨得比指标快。查询引擎打开文件句柄,像在菜市场数摊位。优化器统计信息又过期。CBO一拍脑袋,选了个烂Join顺序。结果呢?向量化执行再快,也扛不住错误的执行计划。这话不好听,但真的。
 湖仓一体元数据服务架构示意图
我们后来做的动作很土。先上元数据巡检,按表粒度盯文件数、快照年龄、分区倾斜。再做异步compaction,把合并任务和写入任务解耦。最后把统计信息采集从全量改成增量。效果不是一夜翻倍。P95降了差不多四成。够用了。研发嘛,别总想憋大招。
实时链路和离线链路的边界,正在被工程细节吃掉
流批一体喊了好几年。真到研发层,难点不是API长得像不像。是状态。Flink任务的状态后端、checkpoint间隔、反压传播,任何一个参数抽风,整条链路就开始抖。你看着监控大屏,背压红一片。业务方还在群里问:刚才那批数据怎么没到?
我的经验是,实时链路要先保正确性,再谈低延迟。Exactly-once不是口号,是两阶段提交、幂等写入和下游事务能力一起兜底。少一个环节,就可能重复消费。有些团队为了压延迟,把checkpoint拉得很长。平时没事。一到大促,故障恢复像老牛拉车。真让人头大。
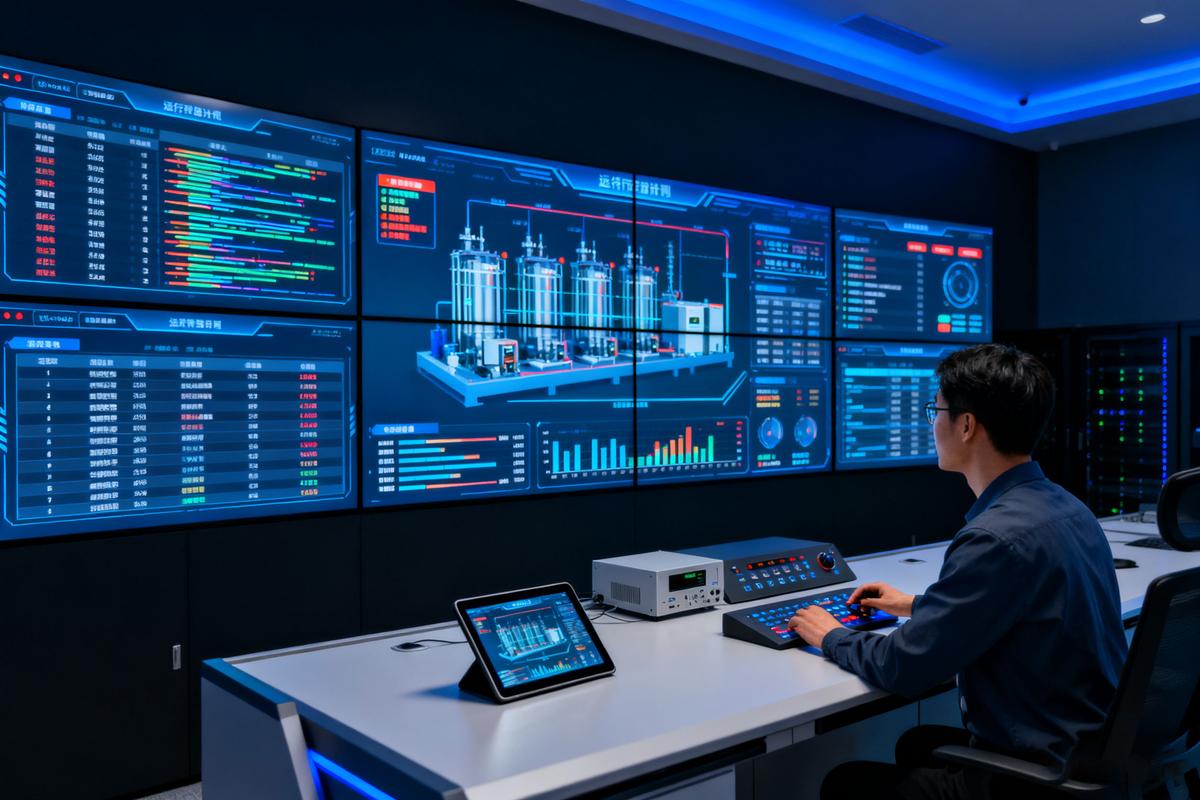 实时流计算任务监控大屏研发值班场景
科研上有个有意思的方向:用学习型方法做资源调度和异常检测。论文指标很好看。生产里最怕什么?怕它把长尾任务当异常杀掉。所以我们现在更看重可解释的告警和保守的自动动作。先提示,再灰度,最后才自动。别一上来就全自动。机器也会犯错。人也会。扯平了。
AI开始反过来改造数据系统,但别急着吹
 AI开始反过来改造数据系统,但别急着吹
AI4DB这波很热。学习型优化器、自动索引推荐、自然语言转SQL、向量检索加速。方向都对。可落到大数据技术研发,第一道坎是数据分布漂移。今天训练的计划选择器,明天数据倾斜就把它打回原形。第二道坎是成本。GPU推理不是免费的。第三道坎是责任边界。优化器给错了计划,谁背锅?
我比较看好两条线。一条是用AI做运维侧的脏活累活,比如慢SQL归因、参数推荐、容量预测。另一条是把向量化执行和异构硬件吃透,让CPU、GPU、DPU各干各的。听着不玄。但工程价值扎实。科研成果要转化,往往就卡在这种不性感的细节上。
还有数据要素流通。隐私计算、联邦学习、TEE,这些词很热。研发同学得盯住性能损耗和合规边界。别为了一个漂亮的安全指标,把查询延迟拉到没法用。那就本末倒置了。
先写到这。机房那边的告警又响了。我得去看看是哪个stage又在重试。大数据技术研发这事,说到底就是跟细节死磕。论文给方向。生产给耳光。两边都得接着。