把建议放回决策链:智能决策支持的证据、边界与可撤销性
会议室里安静了两秒。南京江宁一家制造企业的排产会上,系统弹出建议:把A线周六的批量调小,换到B线夜班。屏幕上的甘特图很漂亮,库存曲线也漂亮。车间主任只问了一句:换线损失谁担?没人接话。
这不是段子。它几乎概括了智能决策支持很常见的尴尬:建议生成得很快,决策链却没有被真正接上。模型算的是目标函数,组织算的是责任、惯性和可执行性。两套账本对不上,系统就退化成一个高级报表。
建议很漂亮,决策却未必更好
决策支持系统(DSS)的老传统,是把数据、模型、界面和人的判断放在一个回路里。后来机器学习进来,回路被压缩成预测加推荐。问题也来了:预测精度高,不等于决策质量高。一个需求预测模型可以把误差压得很低,但排产决策还要看换线成本、交期罚金、班组技能和供应商到货波动。目标函数一错配,模型越努力,组织越拧巴。
我见过一个反例。某工厂上线排产优化,局部设备利用率上去了,成品库存却转移到下游仓库。系统没有撒谎,它只是把成本挪出了自己的视野。决策支持的第一道门槛,不是算法多复杂,而是决策边界画没画清:哪些变量进模型,哪些约束交给规则,哪些偏好留给人。画不清,建议就会成为部门之间踢皮球的素材。
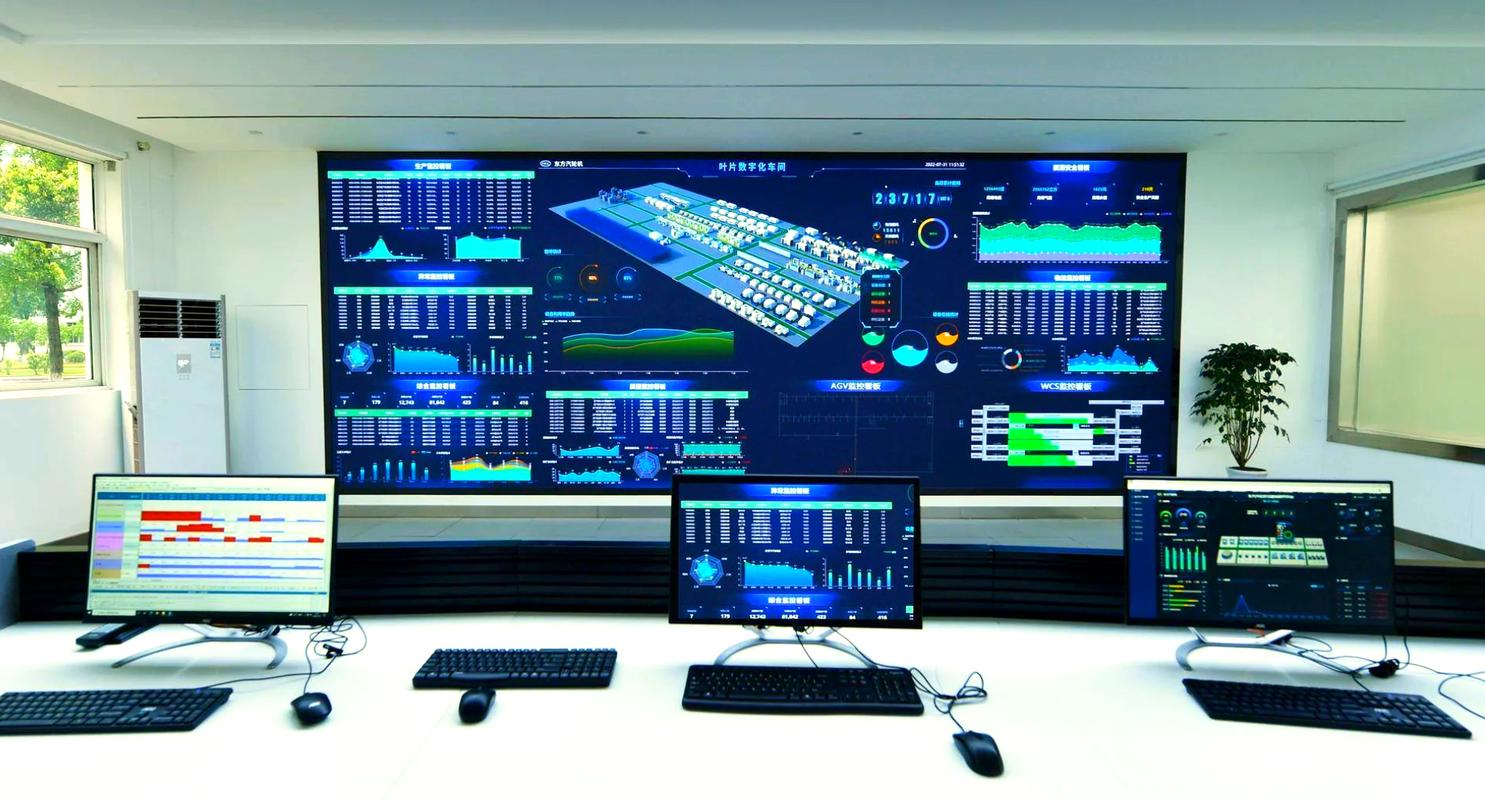 南京江宁制造企业排产智能决策支持系统决策大屏现场图
还有个更隐蔽的问题:反馈污染。系统给出建议,人改了,结果好,系统把人的修改学回去;结果坏,人又把责任推给系统。几轮下来,模型学到的是组织政治,不是因果。说实话,我对这类“越用越聪明”的宣传一直有戒心。没有决策日志和反事实记录,所谓学习很容易变成自我循环。
把因果图塞进决策回路,而不是只塞模型
智能决策支持要站得住,至少得回答三个问题:建议从哪来,约束在哪,出了事怎么追溯。我的偏好是把它拆成几层。底层是数据和因果假设图,不是一堆特征。中间层是约束优化或规则引擎,负责可行解。上层是人机接口,负责暴露不确定性、代价和替代方案。顶层是决策日志,记录谁在什么条件下采纳或否决。
因果图不是装饰。它逼着团队说清楚:降价是因为库存压力,还是因为竞品动作?这两条路径对应不同干预。贝叶斯网络、结构方程、DoWhy这类工具都能用,但工具不是重点。重点是把可干预变量和不可干预变量分开。很多系统失败,不是算错,而是把不可干预的变量当成杠杆。比如把天气预测塞进促销建议,却没法改变天气,只能改变备货。
约束也得说人话。排产里的换线时间不是常数,夜班效率会掉,临时插单会挤压维护窗口。这些约束如果只写在Excel里,模型就会给出“数学上可行、现场不可行”的建议。鲁棒优化和机会约束能处理部分不确定性,但它们需要分布假设。假设错了,稳健也会变成另一种激进。
 南京软件企业智能决策支持系统人在回路评审会现场图
人在回路不是让人点确认。那太偷懒。有效的人在回路,要让人能改目标、改约束、看到反事实。比如系统给出三个方案:交期优先、库存优先、换线最少。每个方案旁边标出代价和风险,而不是只给一个“推荐”。可撤销建议比“精准建议”更重要。决策者需要知道,采纳后如果周一原料没到,怎么回滚。
验证的难点在反事实,不在准确率
 验证的难点在反事实,不在准确率
离线准确率很好看,但它回答不了“如果没采纳建议,结果会怎样”。这就是反事实问题。严格说,只有随机化或准实验能靠近因果效应。很多企业不愿意做随机对照,那就退一步:灰度上线、分厂对照、断点回归、决策日志加倾向得分。方法不完美,但比拍脑袋强。
评估指标也得换。除了预测误差,还要看决策周期、方案采纳率、回滚率、跨部门争议次数、库存周转、交期履约。某医院做临床预警,模型AUC不低,护士却抱怨告警太多。后来发现,告警疲劳让响应率下降。你很难说模型错了,但决策支持失败了。因为它没有把人的注意力和工作流当成约束。
这里有个边界:高后果、低可解释、强责任的场景,不宜把建议做成自动执行。信贷拒贷、重症治疗、重大安全联锁,机器可以给证据、给风险分层,但责任得有人接。反过来,低后果、高频、可回滚的场景,比如仓库补货参数微调,可以放更多自动化。边界不是道德口号,是成本收益和责任结构的合算。
边界感:哪些场景该让机器闭嘴
我越来越觉得,智能决策支持的能力不仅体现在“给建议”,还体现在“知道什么时候不给”。数据分布漂移时,模型置信度会虚高;组织目标冲突时,建议会变成派系工具;反馈回路被污染时,学习会放大偏差。这些条件下,系统该做的是暴露不确定性,甚至暂停建议,而不是硬着头皮输出。
大语言模型进来后,这个问题更尖锐。它能生成很像样的决策备忘录,也能编出不存在的政策依据。把它放在决策支持里,适合做信息整理、假设生成、会议纪要、方案对比,不适合做没有证据链的裁决。需要检索增强、引用校验、权限隔离和人工复核。否则,幻觉会穿上西装。
趋势上,我看到三个方向在合流:因果推断负责“为什么”,鲁棒优化负责“万一呢”,人在回路负责“谁来担”。这三件事合起来,才像决策支持,而不是推荐系统换皮。南京这边不少制造企业和软件团队在试,场景很土,排产、能耗、质检、供应链。土场景反而好,因为约束清楚,回滚成本可算。
还有一句不太客气的:智能决策支持不是把决策外包给模型,而是把决策过程变得可审计、可争论、可回滚。如果一套系统只能展示聪明,不能承接责任,那它离真正的决策还有距离。会议室里那两秒的安静,值得每个做系统的人反复听。