隐性知识显化为何总在最后一公里失真:从专家手感到大模型语料的断层
去年在南京一场产学研对接会上,企业方抱来厚厚一本SOP,说隐性知识都在里面。翻到中间我就泄气:关键判断全写着“视情况而定”。这不是文档问题,是显化对象搞错了。
隐性知识显化常被简化成访谈、录屏、写案例。真做下去,项目启动没几天就会撞上一个尴尬:专家说得越完整,文本越像正确的废话。原因不神秘。专家做判断时调用的不是一条条命题,而是被情境压缩过的取舍结构:他看到什么信号、忽略什么噪声、在哪个约束下退而求其次。语言一出口,压缩包被解压成线性叙述,损失恰好发生在最关键的分叉处。
专家说出来的,往往不是他真正用来做判断的东西
认知任务分析里有个老问题:熟练者对自己技能的描述并不可靠。不是撒谎,是自动化。越熟练,越难把中间步骤召回意识。你问老师傅怎么听出轴承异响,他可能说“声音不对”。再追问,他补一句“发闷”。这两个字对新手几乎没有操作价值,却可能是他二十年现场经验压缩后的标签。
更麻烦的是,专家访谈会天然偏向事后合理化。人会给自己的判断编一个体面理由,真实决策链却可能由视觉线索、触觉反馈、时间压力共同触发。只采访谈语料,得到的更像专家对自身的公开解释,而非可执行规则。反例很多:外科医生描述缝合手感,常落在“力度合适”;影子跟踪后才发现,他会根据组织回弹速度调整进针角度,这个变量在访谈里根本没出现。
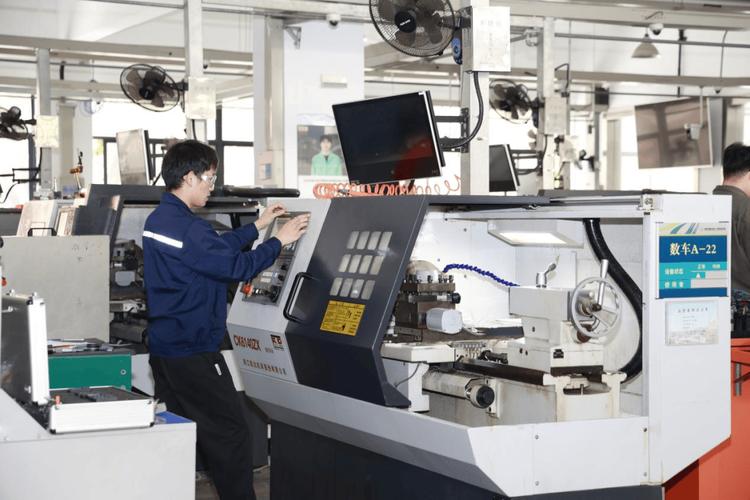 制造业老师傅调试数控机床手感传递现场照片
所以显化的起点不是“让专家多说话”,而是把判断放回任务现场。影子跟踪、刺激回忆、关键决策法、决策日志,这些手段的价值不在技巧花哨,而在于把“视情况而定”拆成可观察的条件。条件一具体,文本才有资格进入培训或模型语料。
把经验变成可训练信号,中间层比语料规模更关键
不少团队一上来就堆语料:录音转写、操作视频、故障案例。规模看着大,训练价值未必高。缺的是中间层——情境标签、决策节点、约束条件、失败对照。没有这一层,语料只是素材;有了这一层,素材才可能变成信号。
技术原理并不玄。先把任务切成可观察的决策节点,再标注每个节点上的输入线索、候选动作、取舍依据和后果。关键决策法适合高频高风险任务;概念图适合梳理专家脑中的因果链;双人标注能暴露专家之间不一致的边界。条件也明确:任务反馈周期短、结果可验证、专家愿意暴露错误。反例同样清楚——战略直觉、跨文化谈判、复杂伦理判断,显化成本极高,强行拆解容易制造伪精确。
 三甲医院手术室资深护士带教隐性经验场景照片
这里有个容易被忽略的限制:显化不是一次转录,而是多次对照。专家先讲一版,现场看一版,新手试一版,失败后再回访一版。每轮都在修正“他说的”和“他做的”之间的偏差。只做一轮,产出通常漂亮但不可用。
可验证的显化,得允许失败样本存在
 可验证的显化,得允许失败样本存在
验证标准不是专家点头。专家点头太便宜。更硬的验证是:新手在相似情境下能否做出可接受判断,并且知道什么时候不该照搬。要设计对照任务,保留失败样本,记录误用条件。没有失败样本,显化结果往往只剩正确路径,学习者遇到边界就崩。
指标也会异化。若只考核文档数量、案例条数、模型召回率,团队会倾向于生产安全而空洞的文本。更可行的做法是看迁移表现:在未见过但同分布的任务上,新手决策偏差是否收敛;在分布外任务上,系统能否主动标记不确定。这里没有单一指标,也不该有。
风险不在失真,而在把局部经验误当普遍规则
显化必然有损。真正危险的是把某个班组、某台设备、某个班次的经验,包装成普遍规则。知识半衰期一缩短,旧规则会以权威口吻误导新人。责任归属也绕不开:当显化结果进入辅助决策系统,出错时算专家、算系统、算组织流程?边界不写清,现场就会用脚投票。
趋势上看,多模态采集和大模型蒸馏会降低转录成本,却可能放大偏差。模型擅长把高频模式说得顺滑,对低频但关键的例外反而不敏感。更稳妥的路径是人机协同标注:机器负责对齐、检索、冲突提示,人负责边界裁定和责任签名。显化结果要能追溯到具体情境和具体专家,而不是一团无出处的“组织智慧”。
所以,隐性知识显化更像一场有损压缩后的可用性工程。压缩比越高,越要标清适用条件;标不清,文本越漂亮,现场越不敢用。