冷启动不是玄学:推荐系统技术的硬约束与反馈回路
九月底的南京,软件谷会议室空调开得很足。白板上画着召回、粗排、精排、重排四段链路,旁边有人写了一句“冷启动先上双塔”。这场景太熟了。推荐系统技术最容易被误读的一点,是把它当成一个排序模型。模型当然重要,可它只是链路里最后一截。前面数据怎么来、日志怎么记、反馈怎么偏,往往更决定线上效果。说实话,很多“模型不work”的争论,吵到收尾是在补数据债。
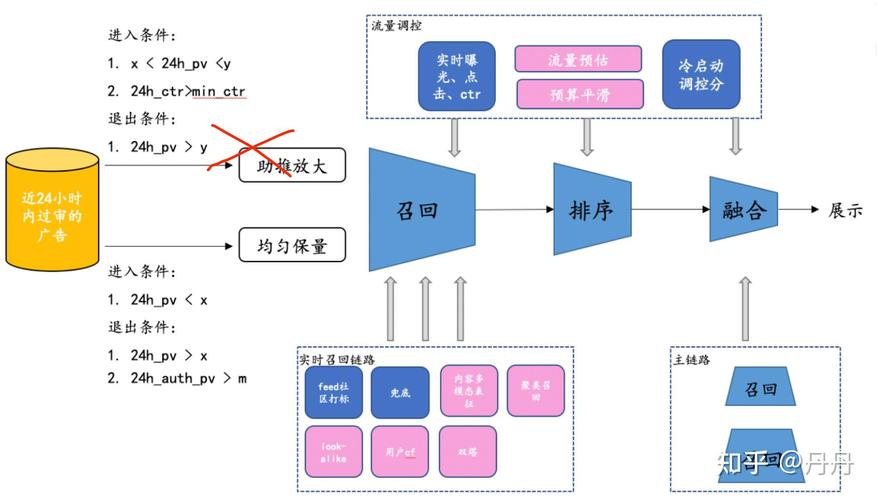 推荐系统技术冷启动数据流与特征回填示意图
 推荐系统技术多路召回与粗排精排链路架构图
冷启动先把责任还给数据
新用户进来,只有一次曝光、一次点击,甚至只有设备号和城市。此时协同过滤几乎无从下手,双塔召回的物品侧向量也未必可靠。常见做法是用内容特征、热门兜底、地域偏好做冷启动,再用探索策略收集反馈。这里有个硬约束:探索预算不是免费的。给新用户推长尾,短期点击率会掉;推热门,反馈又高度同质。工程上更稳的路径,是把冷启动拆成“可解释的规则兜底 + 受限的探索 + 快速的特征回填”,而不是指望一个端到端模型从零学会。南京这边做本地生活推荐时,地域粒度就特别敏感:新街口和江宁的偏好差异,可能比两个城市还大。用城市级先验直接套,容易把用户推到一个“看似合理、实际不对”的商圈。反例也有:某些低频品类,内容特征质量差,冷启动阶段强行个性化反而放大噪声,这时热门兜底并不丢人。多大事啊,先让系统跑起来,再谈精细。推荐系统技术冷启动数据流与特征回填示意图
召回不是漏斗的第一层那么简单
很多团队把召回当漏斗入口,觉得多路召回堆上去,总有一路能捞到。问题是,召回之间不是简单并集。多路召回的分数不可比,去重和截断会改变候选分布,粗排再一压,精排看到的样本已经偏了。更麻烦的是召回阶段的目标和最终目标经常错位:召回按点击概率捞,精排按转化率排,重排又加多样性约束,链路每一层都在“局部合理”地改写问题。做推荐系统技术评审时,我常问一句:召回截断的阈值是怎么定的?如果答案是“离线试出来的”,那就要看离线样本怎么采。曝光日志只记录被展示的物品,未展示的负样本是缺失的,直接当负例训练,会把“没机会”误判成“不喜欢”。这不是模型容量能补的。另一个限制是延迟。召回要覆盖百万级物品,双塔内积、ANN 索引、多路并发,任何一环抖一下,线上超时就会触发降级。降级策略如果只是“回退热门”,短期稳,长期会把反馈回路越拧越窄。推荐系统技术多路召回与粗排精排链路架构图