技术风险识别:我见过最贵的教训,叫“应该没问题”
凌晨两点四十七分。手机在枕头边震得跟电钻似的。我闭着眼摸到它,屏幕亮度调到了自动——黑夜里白得能把人晃瞎。一个平时死气沉沉的工作群,正在疯狂@我。
系统响应时间,从 200 毫秒飙到了十五秒。不,准确说是先慢,然后全红。
我大概用了十五秒从床上弹到电脑前。四十分钟后定位到根因:半年前一次数据库参数微调,连接池上限被改了。当时我在上线单上瞄了一眼,脑子里闪过三个字——应该没问题。
这个“应该没问题”,后来被写进了事故报告的第一行。那四个字也成了我后来做技术风险识别时,脑子里永远亮着的红灯。
风险识别这东西,根本不是“列清单”
很多团队一聊风险识别,第一反应是打开 Excel 开始列:服务器故障、网络中断、数据库宕机、第三方接口不可用……逐项打勾。这活儿我也干过。干完之后特别有安全感——你看,咱们什么都想到了。
错。大错特错。
真正会让你半夜爬起来的那类风险,从来不在你列的清单上。
这句话听着像段子,但它是技术风险识别里最反直觉的一个事实:你能写进清单的,几乎都是你已经有办法处理的风险。没写进去的那些,才是真疼。
那怎么办?我后来慢慢琢磨出一个思路:别找“问题”,找“边界”。
什么叫边界?就是系统“本来能扛住”和“扛不住”之间那条线到底画在哪儿。你不知道线在哪儿,你就不知道风险在哪儿。
举个例子。我们以前做订单系统,压测跑完,QPS 峰值到两万,稳稳的。群里一片“OK”表情包刷屏。然后我多问了一句:这个压测场景里,连接池的活跃连接数最高到了多少?
没人知道。
一查,最高 780。连接池上限 800。
你看。这就是“边界”。你的系统在 780 到 800 之间,只有 20 个连接的余量。任何一点小波动——某批请求变慢、某一台节点重启——连接池瞬间打满。打满之后所有新请求排队,排队超时被丢,被丢触发重试,重试又加倍消耗连接。雪崩就是这么来的。而这个风险,在你那张“风险清单”里根本找不到位置,因为你的清单上只写着“数据库故障”,可数据库明明没坏。
 订单系统数据库连接池监控截图
别在“已知的未知”里打转
 别在“已知的未知”里打转
风险管理圈有个说法,叫“已知的未知”和“未知的未知”。前者是你知道自己不知道的。后者是你不知道自己不知道的。
大部分团队把所有精力花在“已知的未知”上,写厚厚的预案。这没错,但不够。真正能救命的,是在“已知的已知”里面翻出那些被当成“没问题”的东西。
再举一个更过瘾的例子。
有一年我们做视频业务,要接一个云厂商的转码服务。方案评审一切顺利。延迟 OK,成本 OK,功能 OK。有人提了一句“他们有 SLA 吗”,对方扔过来一个 99.9%。于是通过。
我当时多看了一眼文档。月可用性 99.9% 的承诺,对月度出账的人来说意味着什么?意味着每个月允许你有 43 分钟不可用。而我们的直播业务,一次 43 分钟的故障可能直接上热搜。
更要命的是,那个 SLA 里写着“赔付以代金券形式发放”。对,代金券,不是现金。你系统挂了 43 分钟,用户跑了,厂商给你发券。
这件事里,技术风险识别真正要做的是什么?不是问“这个服务稳不稳”。是问:它不稳的时候,我们怎么办?
没有降级方案。没有备用通道。没有本地缓存。这三个“没有”,你没发现它,它就是隐患;你发现了它,它就是任务清单。
识别的实操:从“谁在这条链上”开始
说几个我实际在用的方法,不讲大词。
先画链路。把核心业务路径画成一条线:用户请求进来,经过网关、经过服务 A、B、C,调了数据库,调了缓存,调了队列,调了外部 API,最后返回。一个节点一个节点看。
然后针对每一个节点问三个问题。
第一,它挂了会怎样?不是“会不会挂”,是“挂了会怎样”。影响面多大,全挂还是局部,用户感知到什么程度。这个问题听起来简单,但逼着你去量化后果。
第二,它慢了呢?很多人只考虑宕机,不考虑变慢。说实话,变慢比宕机更危险。宕机是个确认的失败,变慢是种不确定的煎熬。连接池被慢请求占满,线程全部阻塞,最后表现出来的现象和宕机一模一样。但你的监控可能根本没报警——因为所有服务都“活着”。
第三,它有没有我们没注意到的隐性依赖?这是最容易踩的坑。一个看起来本地的功能,背后偷偷调了三个外部接口。一个看似不重要的 SDK,启动时偷偷做了次 DNS 查询。
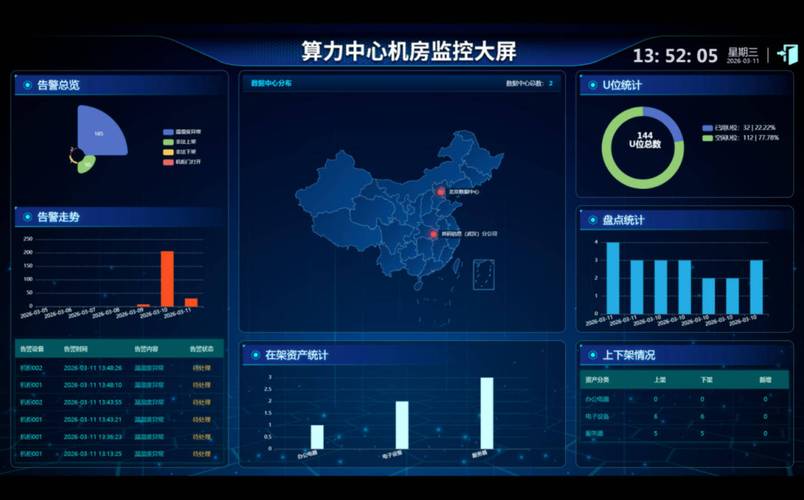 数据中心运维监控大屏告警实拍照片
我见过最离谱的一次,是一个团队内部的“工具类库”,所有业务都依赖它。某天那个库做了一次小版本升级,改动写着“优化时间处理”。听起来无害。结果第二天早上流量高峰,全站超时——那个升级把某个每次请求都会调用的时间格式化方法从纳秒级变成了毫秒级。累加下来,每次请求多花十几毫秒,直接把线程池打崩了。
这个风险,你怎么“列清单”?你根本列不出来。
所以技术风险识别的终点不是一张表,是一张图。一张标着“这里脆”“这里软”“这里还在猜”的系统图。
说几句反常识的
 说几句反常识的
风险不是越少越好,是越清楚越好。
我见过很多团队,把风险识别搞成“消灭风险”的运动。每次评审都要把所有风险项清零。结果呢?大家学会了报喜不报忧,把问题往下压,压成灰色地带。风险不会因为你没写它就不存在。它只会从明处转到暗处,然后在某个凌晨给你打电话。
别迷信压测结果,那只是半个真相。
压测是理想环境,线上是肮脏环境:有脏数据、有慢查询、有偶尔的网络抖动、有一万种你想象不到的使用方式。压测告诉你“能扛多少”,风险识别要你回答的是“为什么扛不住”。
最容易忽略的风险,是人。
我指的不是人犯错,是人“正确地做了不该做的事”。一个开发为了修 bug,紧急发版上线,没走完整的评审流程——他做对了吗?从修 bug 的角度,他做了该做的事。但从整体风险的角度,他绕过了你唯一能拦住风险的关卡。人这个变量在技术风险里的权重,比任何技术组件都大。
边界在哪
 边界在哪
说完这些,得说句清醒的话:技术风险识别不可能穷尽。
你不可能发现所有问题。承认这一点很重要,因为一旦你假装自己能发现所有问题,你就会陷入一种奇怪的自我安慰,然后下一次翻车的时候格外疼。
风险识别的目标不是“零风险”,是“把有限的风险预算花在刀刃上”。
什么叫风险预算?就是你的时间、人力、测试覆盖、回滚方案,这些都是有成本的。你不可能给每条链路都做双活,不可能给每个接口都做三层降级。所以识别本身,就是一次排序——哪些风险先管,哪些后管,哪些先记着不管。
最后一句,留给所有还在凌晨被叫醒的同行:技术风险识别不是让你在会议室里表现得像个预言家,是让你在凌晨三点接到电话时,内心毫无波澜。
因为你知道它在哪,你知道它为什么响,你也知道怎么让它不响。
这不酷。但这很值钱。