科研绩效评价:四十二个指标,能算出一个人的好奇心值多少钱吗?
我有个朋友,在某高校研究所做PI。去年年底考核,行政甩过来一张表——四十二个指标,分门别类,各自配权重。他指着“高水平论文”那一栏看了半天,然后说了句话,我到现在还记得:“我三年发了五篇,两篇自己觉得还行,两篇凑数,一篇纯粹为了填表。你告诉我,这绩效怎么算?”
行政答不上来。他也没指望有人能答上来。
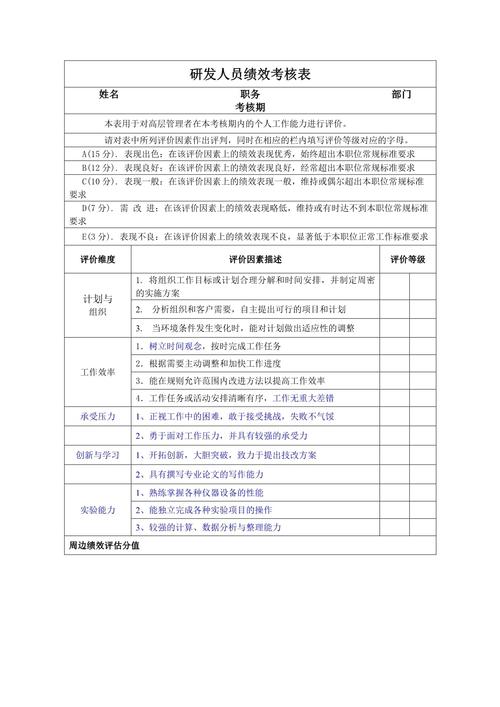 高校科研人员填写绩效考核指标表真实场景
这不是个别现象。你随便找几个做科研的聊聊,每个人都能倒出几肚子苦水。问题出在哪?似乎人人都知道“唯论文”不对,但真要把“不唯论文”落地,又发现无从下手。尴尬就尴尬在这儿。
指标是怎么长出来的:科研活动需要被“看见”
先别急着骂。科研绩效评价这套东西,最初是有合理性的。
你想啊——科研经费从哪来?财政拨款。钱花出去了,公众和主管部门总得知道花哪了、有什么产出。没有评价,就没有问责。没有问责,预算怎么持续?说白了,评价体系是一根链条上的必要环节,不是谁拍脑袋想出来的折磨人的玩意儿。
但麻烦在于,科研的产出和制造业不一样。工厂生产零件,一天产多少、良品率多少,数字清清楚楚。科研呢?
一个课题组,三年时间,可能只产出一个关键发现,也可能产出一堆半成品、失败数据、走了一半的路。你说怎么算?
量化指标的初衷就在这里:用一套可观测的信号,去近似衡量研究活动的质量和影响力。论文数、引用数、项目经费、专利数——这些东西不完美,但至少“看得见”。
 科研绩效评价指标体系层级结构示意图
所以行政才会疯狂堆指标。四十二项?我还见过更离谱的。
问题在于,当“近似”变成了“唯一”,整个游戏规则就变了。
古德哈特定律:你越看重一个数字,它就越不可靠
 古德哈特定律:你越看重一个数字,它就越不可靠
经济学里有个说法,叫“古德哈特定律”——当一个指标变成目标,它就不再是一个好指标。
举个例子。某个单位看重SCI论文数量,于是大家就疯狂灌水。灌着灌着,期刊审稿周期缩短了,版面费涨了,论文质量……你自己想。
再比如,看重项目经费总额。那好,大项目拆成小项目申报,或者联合几个单位凑一个大盘子,经费是上去了,但真正用来做研究的钱呢?
这不是道德问题,是激励结构问题。人会对激励做出反应,而且往往是最短路径的反应。
我有时候觉得,科研绩效评价最吊诡的地方在于——它本来是想解决信息不对称,结果制造了新的信息不对称。指标越堆越多,真正重要的东西反而被淹没在表格里。
你说一个做了十年冷板凳、最后发了一篇真正有分量的论文的研究者,和一个每年发五篇灌水论文的人,在表格上看起来谁更“优秀”?答案显而易见,但表格不这么认为。
行政系统当然知道这个问题。所以大家都在喊“破五唯”。但“破”了之后“立”什么?说实话,至今没有一个放之四海而皆准的答案。
同行评议:理想很丰满,落地很复杂
 同行评议:理想很丰满,落地很复杂
很多人说,学学国外,搞同行评议。
听起来很美。让同一领域的小同行来判断工作质量,而不是数数。
道理没错。可你仔细想想——同行评议的挑战在哪?
首先是成本。你要找一群真正懂行的人,花一两天时间仔细读你的本子或论文,然后给出有分量的判断。这件事的时间成本极高。很多人每年审几十份本子,他们真的有时间仔细看每一份吗?你不妨自己掂量掂量。
其次是圈子和人情。小同行就那么些人,抬头不见低头见。你说评审的时候完全没有“这位是谁谁的学生”的潜意识影响?我不信。结构性的偏见比数字偏见更隐蔽,也更难纠正。
然后是共识的困难。一个工作有没有价值,有时候当下根本判断不了。当年有几个同行能真正理解相对论的分量?你让同行评议去评这种突破,大概率也是低分。
所以同行评议和量化指标,各有利弊。前者更像慢思考,后者更像快照。理想状态是两者结合,但实际操作中,往往是量化指标侵占同行评议的空间——因为前者更便宜、更快、更容易交代。
那有没有稍微靠谱一点的做法?
先说结论:没有银弹。但有些方向值得试。
一个是分层分类。搞基础研究的,和搞应用开发的,和搞技术转移的,评价逻辑根本不一样。基础研究看的是长期影响力和学术贡献,应用研究看的是落地效果和社会价值。用同一套表格去卡所有人,本身就是荒谬的。
另一个是代表性成果评价。不数数量,让研究者自己挑几项最能代表其水平的成果,配上同行专家的深度评议。这比数论文数强,但前提是——你得有真正独立、专业的评议队伍。没有这个前提,再好的框架也会退化成“找人打个招呼”。
还有一个容易忽略的点:过程性评价。科研不是只有“结果”这一个环节。团队建设、人才培养、方法创新、开放共享——这些东西在传统指标里几乎没位置,但恰恰是一个健康科研生态的基石。
 科研团队组会讨论交流评价过程场景
说回我那个朋友。
他后来还是填了那张表。四十二项,逐项打分。他说填完以后有一种奇怪的疲惫感——“不是身体累,是觉得你做的那些真正有意思的事,在这张表上找不到对应栏。”
这句话我一直记着。
科研绩效评价这件事,说到底是在处理一个根本性矛盾:科研活动本质上是无法被完全量化的,但管理又需要量化信号。两者之间的张力,不会因为换一套指标就消失。
能做的是什么呢?可能是承认这个矛盾的存在,然后在具体操作中留出空间——给同行判断留空间,给长周期留空间,给那些“暂时说不清楚价值”的工作留一点余地。
毕竟,如果评价体系逼着每个人走最短路径,那我们最后得到的,就是一堆短平快的东西。看起来热热闹闹,仔细一瞧,没什么能留得住的。
而真正重要的发现,往往来自那些看起来“没什么绩效”的角落。