凌晨三点的告警:云计算平台构建里那个要命的“慢半拍”
凌晨三点十七分,我被电话叫醒。
监控大屏一片绿。CPU正常,磁盘正常,宿主机负载正常。可客户在群里甩来一句:新开的云主机,丢包快丢成筛子了。你说气不气?更气的是,故障只发生在“新建”的那批机器上,老机器稳如老狗。
那天我们查到最后,根子不在物理交换机,也不在网卡驱动。问题出在云计算平台构建里一个特别容易被轻视的环节:控制面和数据面之间的“时间差”。规则已经写进数据库,API也回了成功,但真正负责转发的那一层,还没完全收敛。用户看到的是“开了”,网络看到的还是“没开”。
先别急着骂网络:平台反应慢,得拆开看
云平台听起来虚,落到机房其实就三层东西。控制面,管“应该是什么样”,比如创建虚拟机、分配IP、下发安全组。数据面,管“现在怎么转发”,比如VXLAN隧道、路由表、ACL规则。管理面,管计费、审计、配额这些账本。
很多人搭平台,习惯把注意力砸在数据面:交换机选型、网卡队列、DPDK、SR-IOV,研究得头头是道。控制面呢?几台API服务器,一个数据库,一个消息队列,好像能跑就行。真出事,往往就是这“能跑就行”的地方。
VXLAN这词先解释一下。它把二层帧塞进UDP里,在物理网络之上再叠一层虚拟网络。好处是租户隔离灵活,坏处是每个端点都要知道“谁在哪”。这个“谁在哪”的信息,就是控制面下发的。下慢了,下错了,下漏了,数据面再猛也白搭。
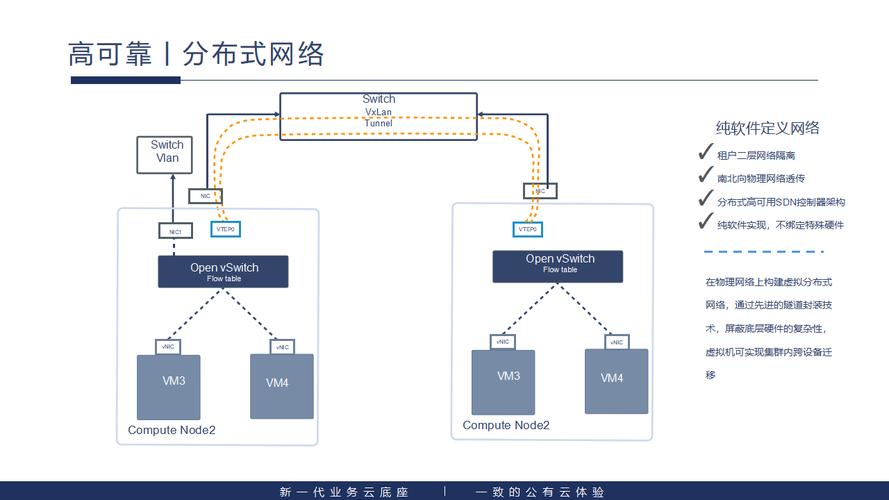 云计算平台多租户VPC网络VXLAN隧道封装示意图
我见过一个很典型的坑。新建VPC后,安全组规则先落库,再异步推送到各宿主机。推的过程中,API已经返回“创建成功”。用户手快,立刻起了两台机器做端口扫描。结果呢?规则还没完全生效,扫描流量被默认策略放过去了几秒。几秒,够写一篇事故报告了。
这不是“偶发bug”,这是平台构建时对最终一致性的代价没算清楚。分布式系统里,你很难让所有节点在同一毫秒看到同一份状态。能做的是:把“未收敛”的状态暴露出来,把默认动作设成拒绝,把重试和幂等做扎实。别让用户猜。
多租户网络,是云计算平台构建的试金石
单租户环境里,很多问题被掩盖了。一台机器、一个网段、一条路由,怎么都能通。多租户一上来,味道就变了。A租户的虚拟机不能看见B租户的MAC,不能蹭B的路由,不能因为B的广播风暴被拖死。听着像常识,做起来全是细节。
我们当时的做法不复杂:每个租户一个VPC,VPC内再划子网,子网之间用路由表控制。宿主机上跑OVS,VXLAN隧道封装,VTEP地址池单独规划。控制面用一套SDN控制器,负责把租户意图翻译成流表。听起来挺顺,对吧?
真跑起来,麻烦在“翻译”上。租户点一下“允许80端口”,控制器要算:源安全组、目的安全组、方向、优先级、有没有冲突规则、要不要下发到新宿主机。计算量不大,但并发一高,队列就堆。队列一堆,新机器上线时拿不到完整规则。这时候,默认拒绝救了我们——新机器前几秒谁都连不上,而不是谁都能连。
所以我现在看一个云平台靠不靠谱,不太看它API文档写得多漂亮。我看三个地方:新建资源后的收敛时间、规则冲突时的报错是否说人话、控制面挂掉后数据面还能撑多久。这三件事,比跑分实在。
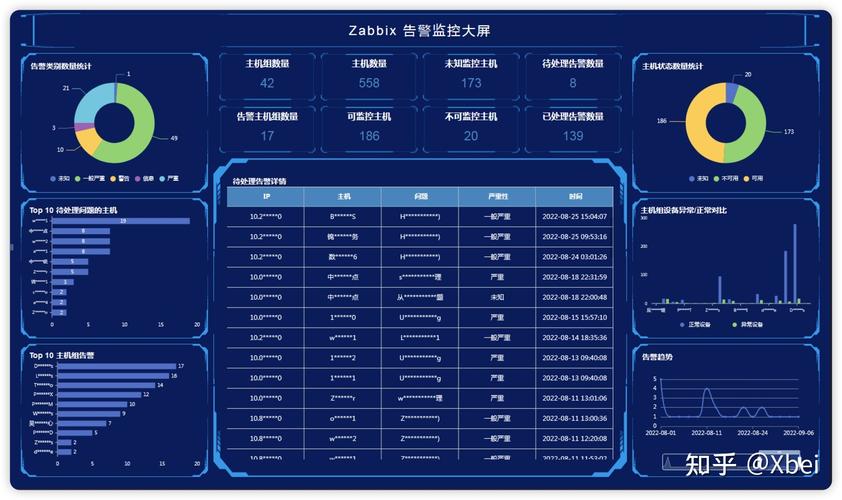 云平台控制面数据面分离架构监控告警大屏
还有个误区,得戳破。有人以为“云平台就是把物理机切成虚拟机,再加个网页控制台”。差远了。网页只是壳,底下是资源编排、配额、调度、镜像、网络、存储、审计一整条链。任何一环慢半拍,用户感知都是“这云真卡”。
反常识:自动化越顺,越要留人工刹车
有段时间我们追求“全自动”。创建、扩容、迁移、回收,最好一键到底。后来一次批量操作教我做人。某业务方写了个脚本,一口气创建八百个VPC。控制面队列直接打满,老租户的安全组更新排在后面,延迟从秒级飙到分钟级。没宕机,但体验崩了。
从那以后,我给平台加了几道“不优雅但管用”的闸。租户级速率限制,防脚本狂飙。控制器队列分级,老租户的变更优先于新资源创建。批量任务拆批,批间留冷却。还有土得掉渣的一招:高危操作要二次确认,别嫌烦。真出事的时候,烦比疼好。
这不是反对自动化。自动化是云计算平台构建的骨头,没它平台立不起来。但自动化得有边界。控制面的爆炸半径,得靠配额、限流、熔断、灰度一点点箍住。你把它当“万能遥控器”,它就敢给你演全楼跳闸。
另一个常被忽略的点:可观测性不是加几个监控图就完事。你得能回答“这个租户的这条规则,现在到底生效到哪几台宿主机了”。这需要状态机、事件追踪、收敛检测。没有这些,排障就像在黑箱里摸螺丝。
落地时,我盯的几件“小破事”
说点具体的。时间同步,必须做。别笑,控制面节点之间差几秒,事件顺序就能乱给你看。元数据服务,得扛住启动风暴。几百台虚拟机同时起来,都去查元数据,数据库连接池分分钟见底。审计日志,别只记“谁点了按钮”,要记“规则从哪来、到哪去、什么时候收敛”。
压测也别只压数据面。拿脚本猛打API,看控制面在并发下的队列深度、重试次数、错误率。备份恢复要真演练,别只备份不恢复。恢复一次,你才知道哪些状态是“可重建”的,哪些是“丢了就完”。
还有个边界得说清楚。云平台不是银弹。低延迟硬实时、超大规模裸金属高性能计算,很多时候物理机更合适。平台构建的目标不是把所有负载都塞进来,而是把适合的负载接住,把不适合的说清楚。这话不好听,但能少踩坑。
至于常见误解,我列两个。其一,“高可用就是多买几台服务器”。没有故障域规划、没有脑裂处理、没有演练,多买只是多几台一起挂。其二,“上云就是省事”。省的是采购和运维的一部分,换来的是平台团队要扛的复杂度。账,得算全。
回到凌晨三点那通电话。后来我们把收敛状态做成了可见指标,新建资源在控制台会短暂显示“网络配置中”。用户不再瞎猜,告警也少了。问题没消失,只是被摆到了明面上。
云计算平台构建这事,说到底是在跟“不一致”打交道。机器会慢,网络会抖,队列会堵。你能做的,是让系统在慢半拍的时候,仍然站在安全的一边。