包容性技术发展不是“慈善补丁”:语音、手语和老年交互的科研硬仗
先讲个让我有点恼火的细节。上周测某款会议转写工具,普通话标准得像个播音员,识别率漂亮;换我那位带闽南口音的同事一开口,字幕直接开始写诗。不是夸张,屏幕上蹦出“项目延期”写成“象鼻咽炎”。我当场愣住。这就是包容性技术发展最尴尬的地方:实验室里指标很好看,一到真人就露馅。
但别急着骂。科研圈这几年确实在动真格。只是动得没那么整齐,有的地方快,有的地方还在补作业。
语音识别:先别吹模型大,敢不敢把错误率按人群拆开
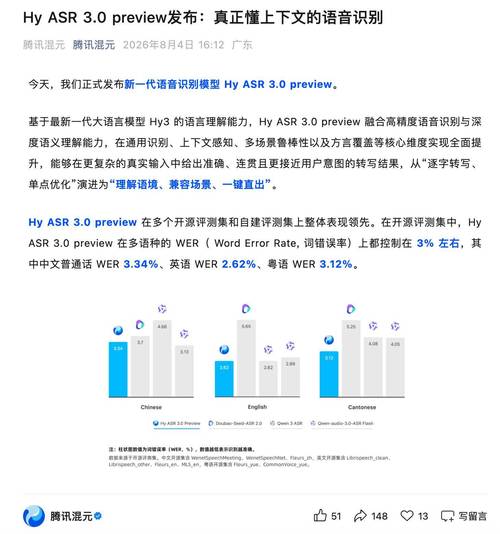 语音识别:先别吹模型大,敢不敢把错误率按人群拆开
语音识别是包容性技术发展里最容易被低估的战场。大家以为难点是噪声、远场、口音。对,但只说了一半。真正麻烦的是数据分布:谁的声音被采得多,谁的说话方式就成了“标准”。
2020年有项挺扎眼的研究,对比几家商业语音系统,发现对非裔美国人英语的平均词错误率明显更高。不是模型不努力,是训练数据里这类语音太少,标注质量也不稳定。后来Mozilla的Common Voice、各类口音挑战赛,都在补这块。效果呢?有进步。但离“谁开口都能用”还差得远。
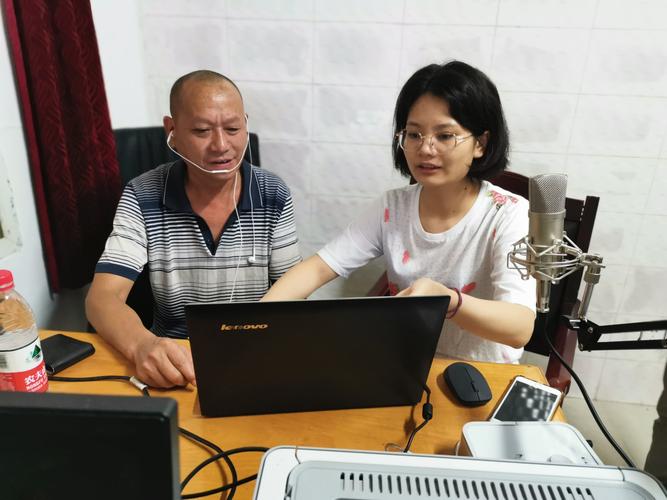 多方言语音识别数据采集现场
我最近看到一些团队的做法挺实在:不追求一个巨无霸模型通吃,而是先做分层评估。按口音、年龄、性别、语速、是否戴牙套、是否有构音障碍拆开看词错误率。听着笨,甚至有点土。可这比发布会上喊“支持100种语言”有用多了。语言列表长不等于包容,错误率不拆开就是耍流氓。
还有个小趋势:个性化语音前端。用少量用户语音做轻量适配,比如联邦学习在端侧更新声学特征,不把原始录音传走。对构音障碍用户,这招比通用模型硬扛更靠谱。隐私也保住了。不过话说回来,端侧算力参差不齐,老年机跑不动,工程上还得做降级方案。别问我怎么知道的,测试机烫得能煎蛋。
手语和视障交互:别把“翻译”当成“逐词替换”
手语识别这两年很热。热得有点过头。有些演示视频里,摄像头一比划,屏幕就蹦出中文词。外行看热闹,内行直摇头。手语有独立语法,有空间关系,有非手动特征。你把它拆成逐词手势再拼成汉语,等于把一首歌拆成音符然后念歌词。能用吗?能。好用吗?悬。
更关键的是参与式设计。我见过一个挺靠谱的科研项目,手语识别团队从需求定义阶段就拉聋人社区成员进来,不是最后找几个人“试用一下”。结果改了什么?把实时字幕的延迟阈值从1.5秒压到0.8秒,把识别失败时的提示从红色感叹号改成震动加文字。小改动,体验差一大截。
 听障用户参与手语识别产品测试场景
视障这边,生成式AI把图像描述的成本打下来了。惊喜吗?有一点。但别高兴太早。无障碍场景的幻觉是灾难。给视障用户描述一张街景图,模型编造一个不存在的台阶,后果不是体验差,是摔跤。所以现在不少团队在做的不是“更会写描述”,而是不确定性表达:没看清就说没看清,别硬编。这个方向我挺看好,虽然听起来一点都不酷。
还有老年交互。别一提老年人就只会放大字体。WCAG 2.2里对焦点可见、拖动替代、目标尺寸都有更细的要求。科研上更麻烦的是认知负荷。同一个流程,年轻人三步点完,老年人可能卡在第二步的术语上。怎么办?做可用性测试,别坐在办公室里猜。我见过一个银行App把“生物识别”改成“刷脸或按指纹”,完成率往上蹿。你说这是技术吗?是,也不是。包容性技术发展很多时候就藏在这种“说人话”的细节里。
法规在推,工程在拖:落地卡在采购和评估
政策端其实在加速。欧盟无障碍法案已经进入落地阶段,WCAG 2.2也早成了W3C正式推荐标准。国内《无障碍环境建设法》2023年9月施行。信号很清楚:无障碍不是可选项。但工程端呢?很多团队还是最后才补。UI稿定稿了,才想起来问“读屏能读吗”。晚啦。返工成本高得让人肉疼。
我越来越觉得,包容性技术发展的瓶颈不在算法,在评估流程。招投标文件里写“符合无障碍标准”,验收时却没人真拿读屏器走一遍。科研项目也一样,论文里报平均准确率,不报分层结果。评审看得过去,用户用得窝火。说句不好听的,这叫自我感动。
 视障用户使用手机读屏功能过马路场景
那怎么办?我偏乐观一点。现在有些大厂开始把包容性指标塞进CI流程:自动化扫描加人工走查,发布前卡一道。还有团队做“极端用户前置”,先找视障、听障、老年用户测,再回头服务主流用户。结果常常反哺:为认知障碍做的简化流程,普通用户在赶时间时也受益。这就是包容性技术发展最迷人的地方——它不是给少数人开后门,是把门修宽了,大家都好走。
当然,别指望一篇文章解决所有问题。我也没那本事。但至少下次看到“支持无障碍”的发布会,你可以多问一句:错误率按人群拆了吗?手语社区参与了吗?读屏器真跑过吗?问完这三句,很多泡沫就破了。