带伤运行的系统:韧性技术系统的工程边界
凌晨三点的告警,往往比架构图更能说明问题。一个接口超时,牵出数据库连接池耗尽;再往上追,是某个看似无关的证书轮换脚本。系统没有“整体崩溃”,却在一连串小故障里失去了关键能力。这类场景,才是韧性技术系统真正要处理的对象。
故障不是例外,是系统的常态输入
工程上容易把韧性和可靠性混在一起。可靠性关心故障发生的概率,韧性关心故障发生后的功能保持与恢复能力。两者相关,但不是一回事。一个高可靠组件仍可能因为配置错误、供应链污染或运维误操作进入失效状态;此时系统能否隔离故障域、保留核心功能、在可接受时间内恢复,才是韧性的考题。
这里有个硬约束:韧性有作用范围,不是无限兜底。设计者必须明确哪些功能在降级后仍须可用,哪些可以暂时关闭,恢复时间目标是多少。没有这些边界,冗余会变成堆料,预案会变成文档。反例并不少见:双机房互为备份,却共用同一套身份认证服务;链路做了冗余,但路由策略同源。故障一来,备份同时失效。
 数据中心双活容灾切换架构示意图
所以,韧性技术系统的起点不是“加一套备份”,而是故障域建模。电源、网络、时钟、证书、域名解析、公共配置,这些看起来边缘的依赖,经常是同源失效的入口。把它们画进故障传播图,比在架构图上多画几个副本更有用。
冗余的陷阱:同源失效与切换代价
冗余是常见手段,但冗余不等于韧性。两个副本如果共享同一套发布流水线、同一组运维账号、同一段配置生成逻辑,它们只是在统计上更像一个系统——仅此而已。更麻烦的是切换本身。主备切换需要探测、仲裁、状态同步和流量重定向;每一步都可能引入新故障。切换风暴、脑裂、数据回滚,这些词在事故复盘里出现得并不少。这很危险。
工业控制系统里有个典型矛盾:冗余环网能提高链路可用性,但协议收敛时间和设备兼容性会限制实际恢复速度。纸面上五十毫秒恢复,现场可能因为某台交换机固件版本不一致而拖到几秒。对流程工业,几秒足够让压力越限。这里的韧性不是“有环网”三个字,而是拓扑、协议、设备、运维窗口共同约束下的可验证恢复。
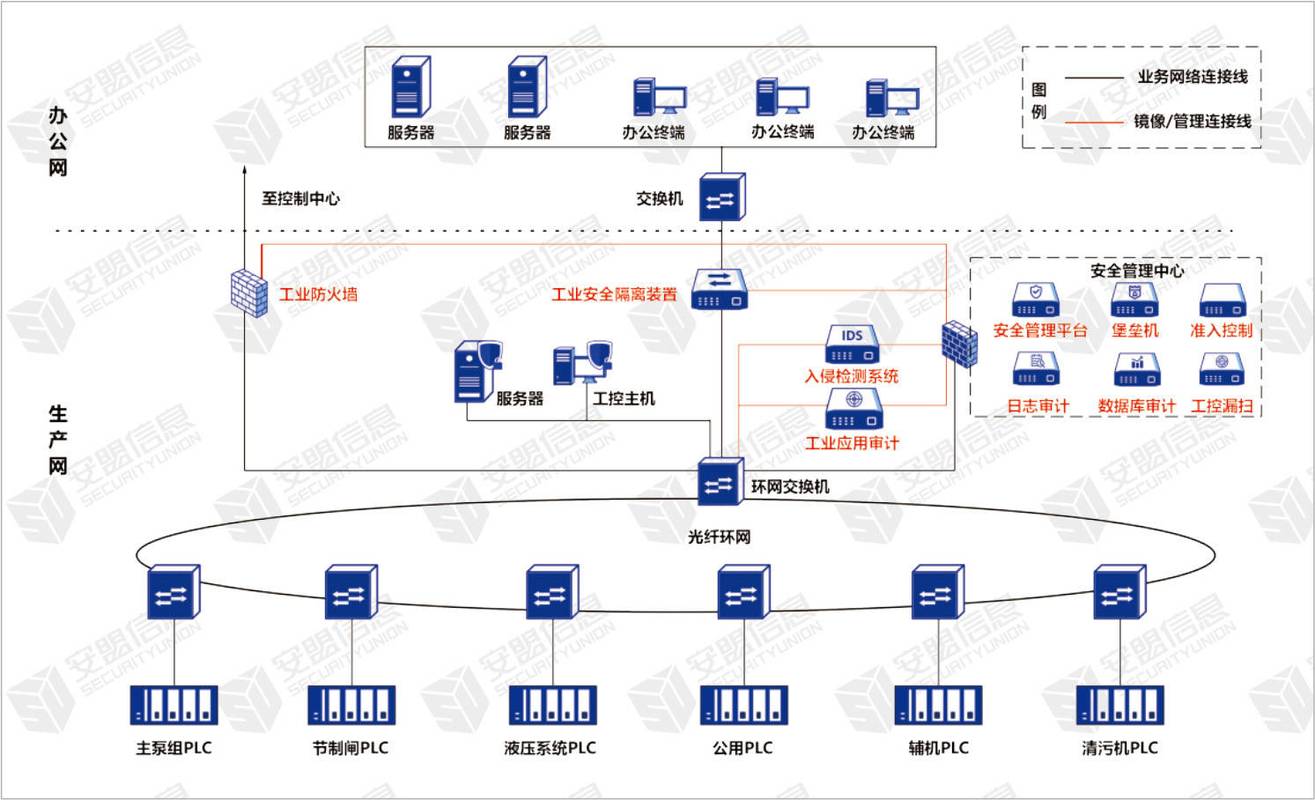 工业控制系统冗余环网故障恢复拓扑图
数据侧更微妙。多副本能扛住节点故障,却扛不住逻辑错误。一条错误的删除语句会被同步到所有副本,冗余反而加速了错误传播。此时需要的是延迟副本、不可变备份、审批闸门和可回滚的数据版本,而不是再加一个同步节点。说白了,韧性要区分“基础设施故障”和“逻辑故障”,两者的药方不同。
从“抗住”到“恢复”:度量与控制回路
 从“抗住”到“恢复”:度量与控制回路
韧性需要度量,但度量不能只盯平均恢复时间。平均值会掩盖长尾。一次三十分钟的恢复,和三十次一分钟的恢复,对业务的影响完全不同。更有意义的指标包括:关键功能降级比例、恢复点偏差、切换失败率、人工介入次数,以及恢复过程中的二次故障概率。指标不必多,但必须能驱动设计取舍。
验证手段也在变化。故障注入、混沌工程、容灾演练,目的不是证明系统“能扛”,而是暴露恢复路径上的断点。这里有个反例:演练脚本写得过于完整,执行时按步骤走,结果把真正的异常路径遮住了。有效的演练应该允许随机终止、依赖缺失和权限受限,让值班人员在信息不完整时做判断。否则,演练只是表演。
韧性技术系统的控制回路,至少应包含检测、隔离、降级、恢复和复盘五个环节。检测要能区分局部异常与全局异常;隔离要避免误杀共享依赖;降级要有明确的功能优先级;恢复要防止流量洪峰再次压垮系统;复盘要落到配置、代码和演练脚本,而不是停在会议纪要。任何一环缺失,恢复时间都会被拉长。
韧性不是免费品:成本、攻击面与组织摩擦
 韧性不是免费品:成本、攻击面与组织摩擦
加冗余、加演练、加可观测性,都要付出成本。更隐蔽的成本是复杂度。系统越复杂,配置漂移和权限蔓延越难控制,攻击面也越大。一个为了容灾而开放的多活通道,可能成为未授权访问的入口;一个为了快速恢复而保留的超级账号,可能绕过审计。韧性设计与安全设计在这里经常打架,需要联合评审,而不是各自加码。
组织摩擦同样真实。降级意味着业务让渡部分功能,谁来决定让渡哪部分?恢复演练需要停机窗口,谁来承担窗口成本?跨团队故障域隔离,往往涉及网络、数据库、中间件和业务方的责任边界。技术方案写得再漂亮,如果值班手册没有对应动作,故障现场仍会退化成电话会议。这里没有万能解,只有提前约定。
应用边界也要说清楚。不是所有系统都值得追求高韧性。失效后果有限、恢复窗口宽松、数据可重放的内部工具,过度设计反而拖慢迭代。判断条件可以很朴素:失效后果是否不可接受,恢复窗口是否短于人工介入时间,故障是否可能跨域传播。三个条件都不成立时,先把备份和监控做扎实,比堆多活更划算。
设计上的几条硬约束
 设计上的几条硬约束
如果要在工程上落地,几条约束绕不开。故障域要按依赖画,不按机房画;关键路径要保留手动兜底,但手动操作必须被演练过;降级开关要能灰度,不能只有全开全关;恢复动作要幂等,避免重试放大故障;数据修复要有独立通道,不能依赖正在恢复的系统。每一条都不新鲜,难的是在预算和工期里排优先级。
趋势上,韧性正在从“基础设施话题”变成“系统属性”。云原生提供了弹性,也把故障藏进了托管服务和控制平面;AI 运维能加速异常定位,却可能给出看似合理但错误的恢复建议。越是自动化,越需要保留可解释的刹车。否则,系统会在错误的方向上恢复得很快。
韧性技术系统的成熟标志,不是它从不告警,而是告警之后,系统和人都不至于失控。这个标准不高,但做到位,需要把故障当成常态输入,把恢复当成一等功能,把边界写在设计之前。