回路闭不上的时候:反馈循环机制的三处结构性裂缝
九月末在南京,一间会议室的空调开得过足。原本在聊某条智能产线的数据采集方案,聊到中途有人问了一句:这套系统上线之后,谁来看结果?沉默了几秒,然后话题转向了别处。这个停顿很有代表性。回路画在图纸上永远是闭合的,落到组织里、落到工程里,断口往往出现在最不起眼的位置——没有人负责读取,或者读了也不知道该改什么。反馈循环机制失效的方式,比它生效的方式要丰富得多。
一旦被测量,它就不再是原来的东西
讲反馈,绕不开一个前提:回路需要一个传感器。传感器的读数被当作“系统的真实状态”,但这个等号从来不成立。测量行为本身会改变被测量对象的策略空间,这是反馈设计里最容易被低估的一层。
英国国家医疗服务体系曾经推行过一条著名的指标:急诊患者从到达到被处置,不得超过四小时。逻辑上无懈可击——等待越久,风险越高,用时长做代理变量合理。落地之后发生了什么?医院把患者挪进救护车、挪进走廊、挪进临时观察区,只要离开“急诊”这个统计口径,计时就停了。数字漂亮了。人还躺在推车上。这事儿挺荒唐的。但真正值得琢磨的不是荒唐本身,而是:所有参与者都没有说谎,他们只是对回路做出了理性响应。
航空业有过类似的操作。准点率是个硬指标,于是把注定延误的航班直接取消,准点率的分母就干净了。推荐系统里也一样:用点击率作为用户满意度的代理,模型很快学会推送让人忍不住点但看完就后悔的内容。这不是模型学坏了,是反馈信号本身携带了偏差。
所以设计回路时,第一个要问的问题不是“怎么采数据”,而是“这个读数会不会被优化对象反向塑造”。如果答案是会,那么回路就有了一个内生的漂移项,且漂移方向总是朝着指标而非目标。
 急诊四小时目标指标操纵数据失真示意图
延迟是一笔隐性税,而且复利
回路里只要有延迟,就存在振荡的可能。这一点在控制论里是常识,在管理实践里却常常被当作玄学。
经典的例子是供应链的牛鞭效应。MIT 做过的啤酒游戏里,每个环节的决策者都只根据自己收到的订单调整库存,信息逐级放大,末端需求的微小波动在上游变成剧烈震荡。参与者都是聪明人,规则也不复杂,问题出在决策与后果之间的时间差——订货到收货有周期,看到缺货再补已经晚了,于是过度补货,然后库存积压,然后砍单。循环往复。
网络传输是同一个数学结构的工程版本。早期 TCP 的拥塞控制靠丢包作为拥塞信号,一旦链路带宽时延积拉大,反馈回传慢半拍,发送端还在按旧窗口加速,缓冲区就爆了。后来 BBR 这类算法干脆不把丢包当拥塞信号,转而估计带宽和往返时延——本质上是在绕开一个延迟过大的反馈通道,改用本地可观测的量做前馈。
这里有个判断准则:反馈周期必须短于被控对象的特征时间尺度,否则回路不但无益,还会主动制造波动。拿 A/B 实验来说,若用户行为的自然周期是以周为单位,而实验三天就下结论,得到的不是信号,是噪声的季节性切片。很多“数据驱动”的决策质量不佳,根子不在分析能力,在采样节奏和行为节奏错配。
工程上能做的其实很朴素:缩短回路,或者降低对回路的依赖。前者靠埋点密度和响应链路的精简,后者靠死区(deadband)和迟滞(hysteresis)——设一个不响应的区间,让系统对小幅抖动免疫。听起来粗糙,效果往往胜过把算法调得更聪明。
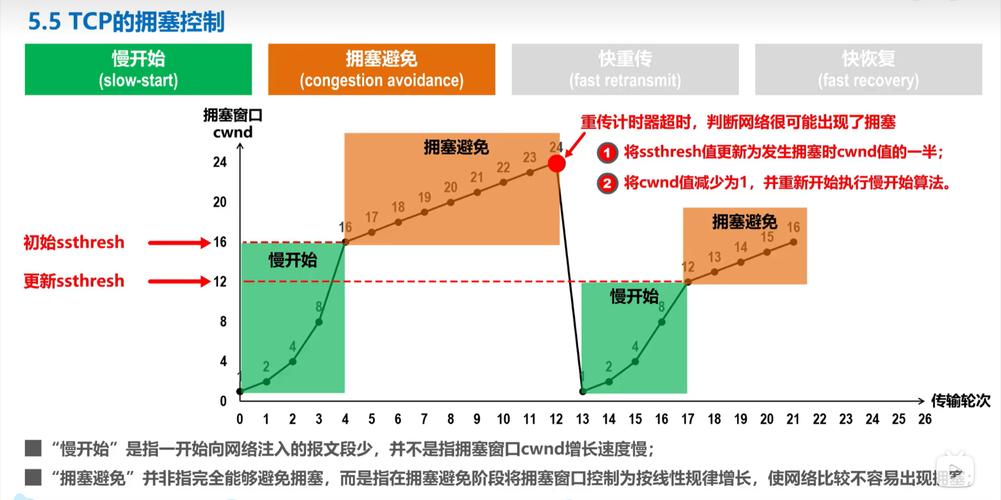 TCP拥塞控制窗口变化与往返时延曲线图
增益的甜区很窄,而且会移动
增益是回路的力度。调小了,偏差累积得比修正快,系统缓慢漂移;调大了,一个微小扰动被放大成过冲,然后反向过冲。中间那段稳定区,宽度取决于延迟、噪声和对象本身的惯性,没有一个通用值。
组织层面的例子特别直观。出了问题,加一层复核;复核拖慢了流程,于是再加一层抽检;抽检没抓到要害,于是升级为周会通报。每一层单独看都是合理的纠偏动作,叠起来却让回路的响应时间从一天变成三周,等到纠偏生效,问题的形态早就变了。这是增益在组织维度上的错觉——人们以为增加控制点等于增强控制,实际上多数时候只是在增加延迟。
Ashby 的必要多样性定律在这里很有解释力:控制器的调节能力必须不少于被控系统的扰动多样性。反过来说,如果扰动的种类已经超出回路能区分的范围,加大增益只会让系统在错误的维度上剧烈摆动。这时候该做的是扩充传感器的分辨力,而不是拧旋钮。
还有个更隐蔽的问题:增益的合适值不是常数,它随系统状态迁移。低频低噪阶段适用的力度,到了高频高噪阶段就是灾难。自适应增益、分段策略、人工介入的兜底阈值,本质上都是在承认单一增益的失效。承认这一点并不丢人,硬扛才是。
什么时候该放弃闭环
 什么时候该放弃闭环
反馈被奉为圭臬,但它有明确的适用边界,超过边界就是负担。
第一种情形:干预成本高于偏差损失。某些低频、低影响、随机性强的波动,闭环维护成本(监控、告警、复盘、人力)可能远超放任不管的代价。开环加一个宽松阈值,反而更经济。
第二种情形:因果关系不清。读数变了,但不知道是哪只手推的。此时闭环调参等于在多个变量上同时随机游走,收敛不了,还可能把系统推到更差的状态。先把归因做清楚,再谈自动纠偏。
第三种情形:正反馈已经压过负反馈。推荐系统里的流行度偏置是个典型——热门内容获得更多曝光,更多曝光带来更多互动,互动又被当成质量信号。这个循环自洽、自我强化,而真正的质量反馈被淹没。要打断它,靠调参没用,得在结构上注入反向扰动,比如强制探索配额、去偏采样。代价是短期指标下滑,这一点没法回避。
还有一种情况经常被忽略:反馈回路可能把系统锁死在局部最优。指标一旦稳定,探索的动力就消失了,回路本身成了创新的抑制器。这时候需要的不是更灵敏的反馈,而是周期性的、有意的失聪——一段时间内关掉指标压力,允许局部变差。
怎么判断一个回路真的在转
 怎么判断一个回路真的在转
验证方法不复杂,但多数团队不做。注入阶跃扰动,看响应曲线。给系统一个已知幅度的输入变化,观察它用多长时间回到基线、有没有过冲、有没有残余误差。三个指标分别对应延迟、增益、稳态偏差,一次实验全暴露。
第二个动作是留一个对照组长期不干预。这听着奢侈,但它是唯一能区分“指标改善”和“系统改善”的手段。没有对照组,你永远不知道数字变好是因为回路生效,还是因为别的地方在悄悄变化。
第三个是看行为有没有跟着指标一起动。如果指标变了而一线行为没变,回路就是空转;如果行为变了而指标没动,说明传感器选错了。两者都变,才谈得上回路成立。
回到那间空调过冷的会议室。后来有人补了一句话:其实我们每个月都在看报表。问题是没人有权改产线的排程。这就把问题说到底了——反馈循环机制的核心不在信息回流,而在回流之后有没有人握有改动系统的权限。回路闭不上,往往不是因为缺数据,是因为那条从读到改的路,中间没有接通。这跟算法无关,跟组织结构有关,也跟愿不愿意在指标好看的时候还承认它不好看有关。难的地方在这儿。