量子机器学习别急着封神:从变分线路到噪声现实,我看到的几条真进展
我先把话撂这儿:量子机器学习现在最怕两种人。一种觉得它马上要取代大模型,另一种一听“量子”就摇头说全是泡沫。上周跟做超导量子比特的朋友吃饭,他一句话把我逗乐了——“你们搞算法的,总想把Transformer塞进稀释制冷机,先问问同轴线答不答应。”
说实话,我刚开始跟踪这个方向也兴奋过。量子态在希尔伯特空间里指数级展开,听起来像给机器学习开了外挂。可翻完几篇实验论文,再看一眼线路深度和噪声数据,兴奋值立马掉一半。不是没进展,是进展长得跟宣传稿不太一样。
量子机器学习不是“把神经网络搬上量子芯片”
先把概念掰开。量子机器学习,英文QML,眼下主流玩法大概四类:用参数化量子线路当模型、量子核方法、量子生成模型、量子强化学习。最热的是第一类,叫变分量子算法。思路不复杂:设计一条量子线路,里面放一堆可调角度θ,跑完测量期望值,拿这个期望值当预测输出,再用经典优化器去调θ。
量子机器学习的核心不是“量子版PyTorch”,而是把量子线路当参数化模型,再让经典优化器去拧参数。这句话很重要。很多人以为量子计算机里跑着一个黑箱神经网络,其实大多数实验里,量子芯片只负责一小段线路,剩下全靠经典GPU在边上算梯度、做误差缓解、管数据搬运。
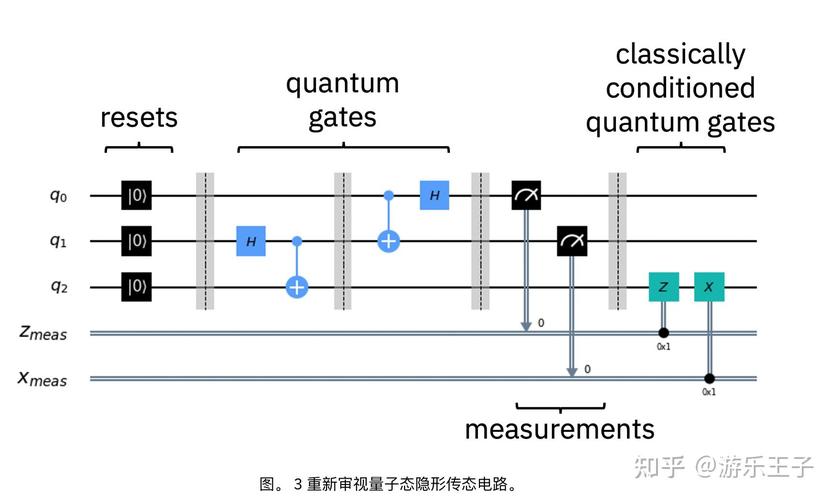 量子机器学习变分量子线路结构示意图
问题也在这儿。参数化量子线路的表达能力确实诱人,可训练地形经常烂得让人想摔键盘。贫瘠高原,barren plateau,听过吧?线路一深、纠缠一多,梯度指数级消失,优化器原地打转。我见过一个小组把线路从12量子比特堆到20,损失函数直接躺平,调学习率都没用。不是他们代码烂,是问题本身硬。
行业动态倒挺热闹。IBM的Qiskit、Xanadu的PennyLane、NVIDIA的CUDA-Q,都在往混合编程上砸资源。Qiskit 1.x强调线路编译和硬件后端切换,PennyLane把自动微分和量子线路绑在一起,CUDA-Q盯着GPU和量子处理器的协同仿真。听着很未来,对吧?但你去跑一个真实噪声设备,双比特门保真度、读出错误、串扰,分分钟教做人。
量子核方法:没那么炫,但更像能落地的活儿
我最近反而更愿意看量子核方法。它不搞深层线路,思路是把经典数据映射到量子态,再算量子态之间的内积当核函数,塞给支持向量机或者核岭回归。线路浅、参数少,误差缓解也好做。说白了,没那么“神经网络”,但更像能落地的活儿。
今年几篇实验论文里,量子核方法在小样本合成数据上确实跑出过一些有意思的结果。注意,是小样本、特定分布、精心设计的数据编码。你把它搬到ImageNet上,大概率被经典CNN按在地上摩擦。别急着喊通用量子优势。
在含噪声中等规模量子设备上,量子核方法比深层量子神经网络更稳,线路浅、参数少,至少更容易做误差缓解。这话我说得比较保守。因为量子核方法也有硬伤:数据加载。你把经典向量编码成量子态,这一步的成本经常被论文一笔带过。QRAM,量子随机存取存储器,理论很漂亮,工程上离实用还远。没有高效的数据加载,所谓加速就像在高速公路入口堵了三个小时。
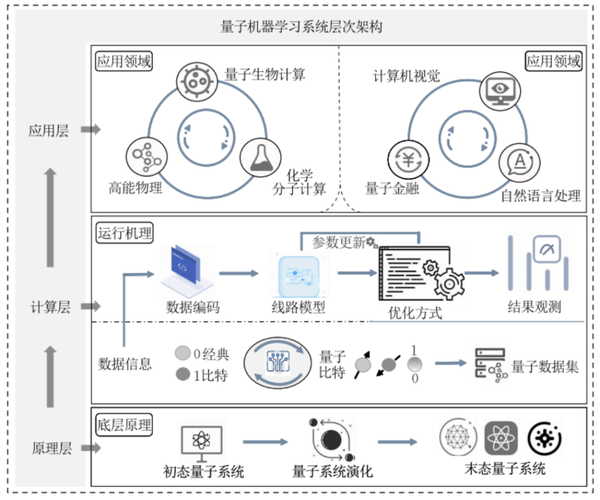 量子机器学习量子核方法特征映射示意图
不过话说回来,我挺烦那种“量子机器学习全是骗局”的论调。你去看看材料模拟里的费米子哈密顿量,看看药物发现里的小分子电子结构,经典方法算得直冒烟。量子机器学习未必是万能药,但在某些特定结构的数据上,它至少值得试。问题是别把“值得试”吹成“已经成”。
行业里真正值得盯的几个信号
硬件这边,Google Willow、IBM Heron、中性原子路线、离子阱路线,都在往前拱。可我最烦媒体标题只写“多少量子比特”。105个物理量子比特很酷,但逻辑量子比特的错误率、双比特门保真度、纠错码的盈亏平衡点,才是能不能跑算法的命门。真正值得看的不是又破了多少量子比特数,而是逻辑量子比特的错误率、双比特门保真度和经典-量子数据搬运带宽。
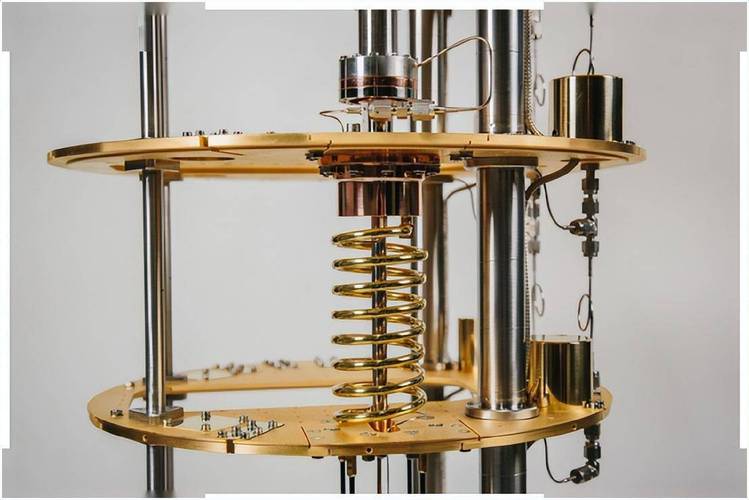 超导量子计算机稀释制冷机内部结构照片
软件栈也在变。以前大家各玩各的,现在CUDA-Q、Qiskit、PennyLane都在抢混合计算的工作流。什么意思?量子处理器以后大概率不是独立跑任务,而是跟GPU、CPU捆在一起,像协处理器。这个方向我认。因为近期不可能把所有东西都量子化,经典预处理、经典后处理、误差缓解,一个都少不了。
应用侧,我盯三块:材料与化学模拟、药物发现里的早期筛选、金融里的组合优化和风险分析。注意,是早期探索。Demo很漂亮,生产环境差着十万八千里。上周看一个量子生成模型的展示,生成几个小分子结构,台下鼓掌。我旁边做药化的朋友小声说:这几个结构专利里早有了。你看,这就是现实。
想入场,先避开这三个坑
 想入场,先避开这三个坑
第一个坑,数据加载。别一上来就假设QRAM存在。老老实实算编码成本,算线路深度,算读出次数。第二个坑,可扩展性。8个量子比特跑通不等于20个能跑,20个能跑不等于100个有优势。噪声会教你做人。第三个坑,评估基准。很多论文挑数据集比挑西瓜还精,专挑经典方法不擅长的分布。你要复现,先看它对比基线有没有调参,有没有用同样的数据预处理。
别一上来就追“量子大模型”,先把一个8到20量子比特的核方法或浅层VQA在真实噪声设备上跑通,比看一百页路线图有用。真的。我见过太多团队把时间花在画架构图上,最后连一个可复现的基线都没跑出来。
对了,如果你看到某篇论文说“量子机器学习实现指数加速”,先翻到实验部分,看它用了多少量子比特、什么噪声模型、对比基线是不是调过参。别嫌我泼冷水。这行当现在最缺的不是口号,是能复现的实验。就这样,我去补那篇量子核方法的附录了,头疼。