开源技术应用避坑实录:那晚,监控系统把我坑惨了
凌晨两点,手机炸了。不是女朋友查岗,是PagerDuty。
线上订单接口错误率飙到30%。
爬起来开电脑,打开Grafana大盘,满屏红。但奇怪的是,日志里啥也没有。折腾到四点,发现是Prometheus的采集配置里,一个relabel规则把某个关键标签给drop了。导致聚合查询全乱。
你说气不气?开源技术应用,真不是下载个Helm chart就完事。
说实话,我干了八年运维开发,开源软件用了一箩筐。但每次跟人聊起“开源技术应用”,我都想先泼盆冷水。不是开源不好,是很多人把它想得太简单了。比如我司新来的实习生,以为Prometheus装完就能高枕无忧。结果呢?头一个月就踩了五个坑。
一、开源监控不是“装完就灵”,得先搞懂它的数据模型
Prometheus的原理其实不复杂。它用的是拉模式——每隔一段时间,主动去目标机器上抓取指标数据。就像快递员定时上门取件,而不是你主动跑去寄。每个指标数据点,除了数值和时间戳,还带一组标签。标签是什么?就是快递单上的收件人、地址、电话。
Prometheus的核心是时间序列数据库,每条数据由指标名和一组标签唯一确定。
所以标签设计是门手艺。我们那次故障,是因为同事在relabel配置里写了action: labeldrop,把instance标签给干掉了。结果所有机器的数据混在一起。告警规则里sum by (instance)直接失效。你猜怎么着?错误率统计把测试环境算进去了。能不飙吗。
别小看一个标签。它能让你查不到数据,也能让你把测试环境当生产环境告警。
 开源监控系统Prometheus数据采集架构示意图
那为什么还用开源?省钱、可控、生态好。但风险也在这儿。没人给你兜底。社区issue可能半年没人理。你提个pr,可能被reviewer说“不符合设计哲学”。
不过话说回来,正是这种“没人管”的状态,逼着你把原理吃透。我后来养成了一个习惯:每引入一个开源组件,先花半天读它的官方文档,特别是“架构”和“推荐实践”那几页。别嫌烦。**把官方文档当合同看,别当广告看。**
二、从“拿来主义”到“真香”,中间隔着一次故障复盘
再讲个故事。我们团队用开源消息队列Kafka。一开始觉得社区活跃,文档全,直接上。上线后没几天,消费延迟飙到分钟级。查了三天,发现是消费者组配置里的session.timeout.ms和heartbeat.interval.ms没调好。默认值在云环境下不够。这不是Kafka的错,是我们没读文档。
你说这能怪谁?只能怪自己懒。
Kafka的消费者组有个协调机制。打个比方:一桌人吃饭,有人去上厕所,你得等他回来才能动筷子?不,你得设置一个等待时间。太长,菜凉了;太短,人没回来。调参就是找平衡。我们把session.timeout.ms从10秒调到30秒,心跳间隔从3秒调到10秒,问题消失。
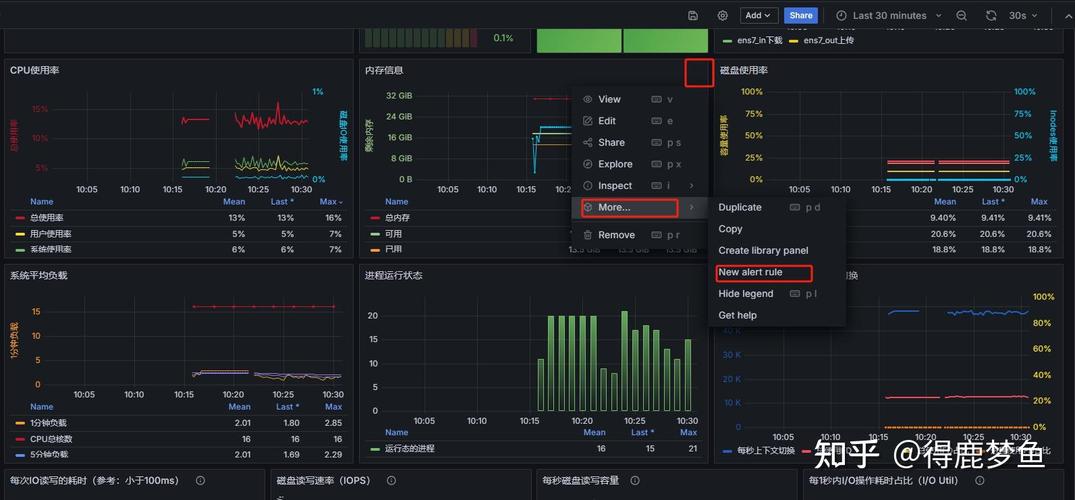 开源监控Grafana仪表盘告警规则配置界面
这件事让我对“开源技术应用”有了新认识。开源软件像一把好刀,但刀柄得自己缠。它的边界在哪?需要商业SLA的关键业务,可能得买企业版或者用云托管。不是所有场景都适合自己搭。我们后来把Kafka换成了云服务,虽然贵点,但省心。这就是权衡。
三、开源技术应用的“暗礁”:许可证、依赖与供应链
 三、开源技术应用的“暗礁”:许可证、依赖与供应链
还有个大坑,很多人不注意:许可证。我见过一家创业公司,用了GPL协议的库,结果被迫开源自己的核心代码。当然,GPL有边界,不是所有情况都触发。但这就像租房,你得看清合同。
开源许可证不是摆设,它是一份法律合同。
更隐蔽的是依赖。你npm install一下,几百个包。其中某个包的作者删库跑路,你的构建就挂了。比如几年前的left-pad事件。还有更狠的:供应链攻击。有人往开源包里塞恶意代码,你拉下来就中招。比如event-stream包被注入过恶意代码,专门偷比特币钱包。
防不胜防。怎么办?建立SBOM,也就是软件物料清单。用工具扫依赖,比如Dependency-Track或者Trivy。这事儿不是大厂专利,小团队也能做。花半天配置,能省很多麻烦。
回到那个凌晨。故障修好后,我在复盘文档里写了一句话:开源技术应用,本质是跟一群人协作,只不过这群人你大多没见过。你得懂它的脾气,也得接受它可能突然抽风。但话说回来,正因为有这些坑,我们才成长得快。对吧?
下次再看到“一键部署开源全家桶”的教程,先别急着点。想想标签、许可证、还有那个可能删库的作者。嗯……先泡杯咖啡。