微服务架构设计不是拆得越细越好:从3个南京踩坑项目聊落地逻辑
去年9月在南京江北的产学研对接会上,我碰到三个做工业互联网的创业团队,清一色把原本跑了两年的单体系统拆成了二十多个微服务。结果上线第一周,平均接口延迟从80ms涨到了320ms,运维的同学每天要处理十几个服务的告警,比拆之前累了三倍还多。我当时问他们为啥要拆,答案出奇一致:“行业都这么做,显得技术先进。”
我当时没好意思说,这套操作本质上是把原本能跑的稳定系统,拆成了一堆随时可能崩的分布式碎块。
拆之前先摸清楚限界上下文的边界
很多人拆服务的依据是现有代码的包结构,或者公司的组织架构——比如有个用户模块的代码,就拆成用户服务,有个订单模块的代码,就拆成订单服务,完全不管这些模块之间的调用耦合度到底有多高。去年南京本地有个政务服务平台,把用户体系按身份属性拆成了个人用户、企业用户、老年用户三个独立服务,结果改一个实名认证的接口,要同时协调三个服务的开发,排期比之前单体时代还长了两周。
拆错了。完全拆错了。
服务拆分的核心依据从来不是代码的物理边界,而是业务域的逻辑边界。简单说,就是这个模块的变更,是不是只影响某一类特定的业务场景?如果改一个用户手机号的接口,既要影响个人用户的登录,又要影响企业用户的资质审核,还要影响老年用户的补贴发放,那把用户体系拆成三个服务,本质上就是把原本进程内的方法调用,换成了跨网络的HTTP请求,平白多了网络开销和排障成本。
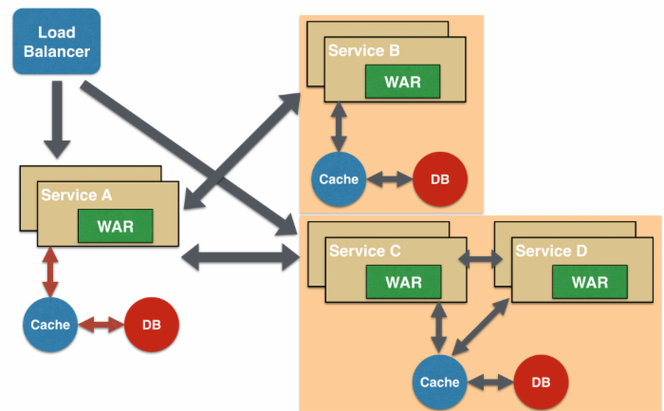 微服务限界上下文划分错误示意图
别上来就堆全套云原生组件
说到服务拆分,很多人第一反应就是上注册中心、配置中心、API网关、链路追踪、服务网格,恨不得把CNCF的毕业项目全装一遍。我见过最夸张的一个团队,总共只有8个开发,服务数量刚到12个,就引入了Istio,结果每次升级Istio版本,都要花两天时间调试适配,光Sidecar带来的资源开销,就占了整个集群CPU的20%。
图啥呢?
其实组件的引入完全要看实际规模。当服务数量少于15个,且全部部署在同一个机房的时候,用静态配置加Nginx做负载均衡,完全可以满足服务发现的需求,根本没必要上注册中心。跨机房部署的场景更要谨慎:南京江宁和江北两个园区的机房,跨机房的网络延迟大概在150-200ms,如果注册中心做了跨机房的多活同步,每次服务心跳的同步流量都会占用跨机房专线的带宽,高峰期甚至会挤占正常业务的调用流量。
 跨机房微服务注册中心同步拓扑图
观测体系要先于拆分动作落地
 观测体系要先于拆分动作落地
大部分团队的操作顺序是反过来的:先花两三个月把单体拆成多个服务,上线之后再补监控、补日志、补链路追踪。结果就是出了问题根本找不到根因——比如用户反馈订单提交失败,你得先猜是网关的问题,还是订单服务的问题,还是库存服务的问题,还是数据库的问题,翻日志翻到凌晨两三点是常事。
去年南京有个做生鲜配送的创业团队,拆完服务之后碰到了一个诡异的问题:每天下午高峰时段,大概有2%的订单会超时失败。他们查了整整三天,才发现是库存服务的数据库连接池配置得太小,高峰期连接被占满,导致库存扣减的请求排队超时。而他们之前搭的监控,只覆盖了接口的成功率和响应时间,根本没监控数据库连接池的使用率。
核心链路的全链路追踪覆盖率要做到100%,且要在拆分动作开始之前就落地。你得先知道每一个请求从进入系统到返回,经过了哪些服务、哪些数据库、哪些第三方接口,每个环节的耗时是多少,出了问题能直接定位到具体的代码行,不然拆得越细,排障的难度就越大。
不过话说回来,还有个绕不开的坑是跨服务的数据一致性。很多人拆完服务之后,碰到订单创建成功了库存扣减失败、支付成功了订单状态没更新的问题,第一反应就是上Seata的AT模式。可这种模式要给每个业务表加全局锁,性能损耗能到30%以上,大部分非核心的业务场景,比如积分发放、消息推送,用本地消息表加异步重试就够了。只有涉及到资金扣减的强一致性场景,才需要考虑TCC或者Saga模式,没必要为了极少数的场景,给所有业务都套上分布式事务的枷锁。
别把微服务当成什么银弹。它只是一种应对复杂业务系统的架构手段,不是技术升级的政绩。适合的才是最好的,对吧?