知识创造螺旋:从工装口袋的便签到组织资产的转译缝隙
上周在南京紫金山下的产学研对接会场,我蹲在工业机器人展区的边角,跟做精密减速器的老周聊了四十分钟。他工装口袋里露着半张皱巴巴的便签,上面是他每次调整行星齿轮侧隙时记的手感数值,旁边还沾着一点没擦干净的齿轮油。
他干了21年,闭着眼摸一下壳体的振动,就能把侧隙控制在0.01毫米的公差范围内。他的手感比仪器灵。但前两年公司让他把这套经验写成操作手册,他憋了三天,最后只写了半页纸的"注意事项",连新来的徒弟看了都摇头——根本不知道怎么落地。
藏在工装口袋里的经验,从来不是"未被记录的文档"
很多人对知识流转的第一重误解,就是觉得隐性知识只是"没写下来的显性知识",只要找个时间让大家坐下来把脑子里的东西倒出来,存到系统里就完事了。其实根本不是。
老周的经验里,有很大一部分是他在不同温度、不同批次的齿轮原材料、不同的装配压力下,长期试错攒出来的身体记忆。这种记忆根本没办法用抽象的文字直接表述——就像你没办法靠读游泳教材学会在浪里换侧泳的姿势,必须自己跳进水里呛几口水,肌肉记住那个发力的感觉才行。这就是隐性知识的具身性,它和人的感官、动作、长期在特定场景里的积累绑定在一起,不是可以随便剥离出来的信息块。
很多企业现在搞的"知识沉淀",本质上是把人当成了文档打印机,觉得只要把人脑子里的东西倒出来,就算完成了知识创造,完全忽略了这种具身的连接。
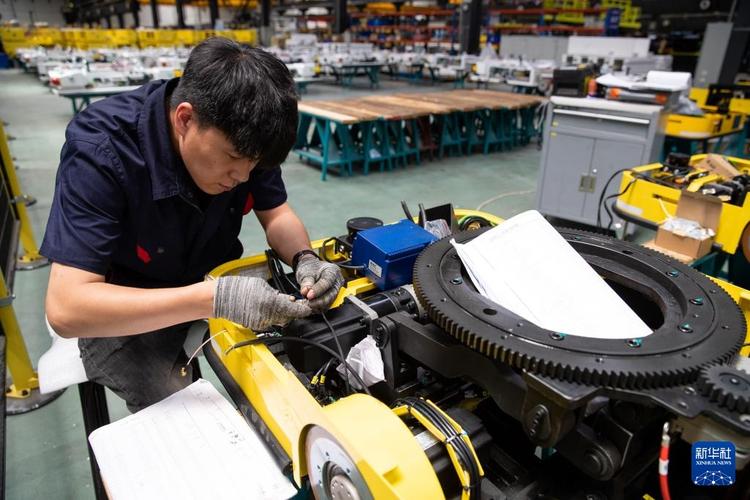 工业机器人装配车间老工程师手持千分尺调整齿轮副现场
转译的每个节点,都需要跨角色的"翻译官"
经典的知识流转模型把整个过程拆成了四个衔接的阶段,很多人看了印在教材上的平滑示意图,就觉得这是一个自动循环的过程,像拧螺丝一样顺着方向转就行。但实际跑起来的时候,每个节点都卡着看不见的门槛。
比如从隐性到隐性的传递,不是老周站在徒弟旁边讲两句话就能完成的,得让徒弟跟着他一起拆三次因为间隙不对报废的减速器,手上沾到和他一样的齿轮油,在同一个温度的车间里站够同样长的时间,摸到同样的振动频率,这个传递才真的发生。很多公司的师徒制最后走了形式,就是因为只走了签协议的流程,根本没给这种共同体验留空间。
再到从隐性到显性的环节,这里最容易出问题。老周自己写不出手册,不是因为他藏私,是因为他的感知已经变成了自动的反应,根本没办法拆解成一步步的动作。后来他们团队花了三个月,拉着老周、数据分析师、一线操作工三个人组成了小团队,把老周每次调间隙的操作过程拍了视频,同步记录下当时的壳体振动频率、输出轴扭矩、车间环境温度,一共攒了327组数据,最后才拟合出一个带温度修正系数的经验公式。这个过程里,没人是全知的,老周知道什么时候手感不对,数据分析师知道怎么从一堆零散的数值里找规律,操作工知道现场操作的时候哪些步骤是最容易出错的,三方凑在一起,才把那些飘在空中的隐性经验,落到了可量化、可复用的规则上。这就是跨职能转译角色的核心作用——没有谁能独自完成从身体记忆到通用规则的跨越。
 野中郁次郎知识创造螺旋四阶段转译示意图 标注跨职能协作节点
剩下的两个节点,从显性到显性的规则组合,还有从显性到隐性的动作内化,同样不是自动完成的。比如你把拟合出来的公式做成了操作手册,发到每个操作工的手里,不代表大家就会用——得让大家拿着手册在实际操作里练够几十次,把新的规则变成自己的肌肉记忆,才算真的完成了内化。很多企业的知识管理系统最后变成了没人看的数字仓库,就是因为跳过了这些环节,只完成了"把文档存进去"的动作,根本没有做跨角色的转译,也没有做落地的训练。
不是所有经验,都值得转成可复制的资产
 不是所有经验,都值得转成可复制的资产
现在很多人把这个流转过程当成了一个必须无限制循环的目标,好像企业里所有的知识都要往这个方向转,转得越快越好。但实际算投入产出账的时候,根本不是这么回事。
老周的这套调间隙的经验,之所以值得花三个月去转译,是因为他们的精密减速器每年要卖2万多台,每台因为间隙问题导致的返修成本是1200块,只要这套经验能把出厂的返修率降2个百分点,三个多月的人力投入不到半年就能收回来。但如果是那种只做定制化单台设备的小团队,每台设备的结构、参数都完全不一样,这次攒出来的经验下次根本用不上,你让他花几个月的时间把经验写成标准化手册,那就是纯纯的无效投入。这里的投入产出边界,是很多做知识管理的人最容易忽略的前提——脱离了复用场景的知识转译,本质上是在浪费大家的时间。
说真的,我见过太多公司的知识管理部门,每年的KPI是"知识库存量文档增长多少""跨部门分享会开了多少场",从来不算这些沉淀下来的内容,到底帮一线的人省了多少时间,减少了多少错误。这种做法本质上是把流转的方向拧反了——螺旋的核心是在流转中长出新的、有价值的知识,不是往仓库里堆那些没人看的旧文件。
现在不少企业开始用大语言模型来帮着做知识转译,把老员工的操作视频、语音记录、过去的维修笔记都喂给模型,想让模型自动生成操作手册。这个方向是好的,但如果没有一线的人做校验,很容易出大问题。比如老周的经验里有个细节:冬天车间温度低于10度的时候,他会把齿轮间隙多留0.02毫米,因为润滑油的粘度会变高,留的间隙太小容易出现卡滞。这个细节他从来没专门写下来过,只是每次操作的时候顺手就做了。如果模型在学习的时候没捕捉到这个场景关联的细节,生成的操作手册到了冬天就会让一批设备因为间隙太小报废。这种风险,靠算法是解决不了的,必须要靠懂现场的人在转译的过程里把这些藏在细节里的经验补回来。
那天在会场跟老周聊完,他从口袋里掏出那张皱巴巴的便签,指给我看上面歪歪扭扭记的数字,说他最近也在跟团队的年轻人一起,把他记了十几年的笔记整理成可以在车间里用的操作指引,不是为了应付公司的检查,是怕自己再过几年干不动了,那套摸了二十多年的手感,跟着他一起退休。
其实哪有什么天生的螺旋啊。
所有能往下传、能长出新东西的知识,本质上都是人跟人在具体的场景里,磨出来的连接。