别把产业渗透率当KPI:你算的数可能从根上就错了
最近跑了三场产业对接会,发现一个特别有意思的现象。不管是做硬科技的创业团队,还是做地方产业规划的职能部门,PPT里总少不了一个核心指标,翻来覆去讲这个指标现在到了多少,未来还有多少空间。但是翻来覆去算,十份报告里有八份的口径,从一开始就错了。
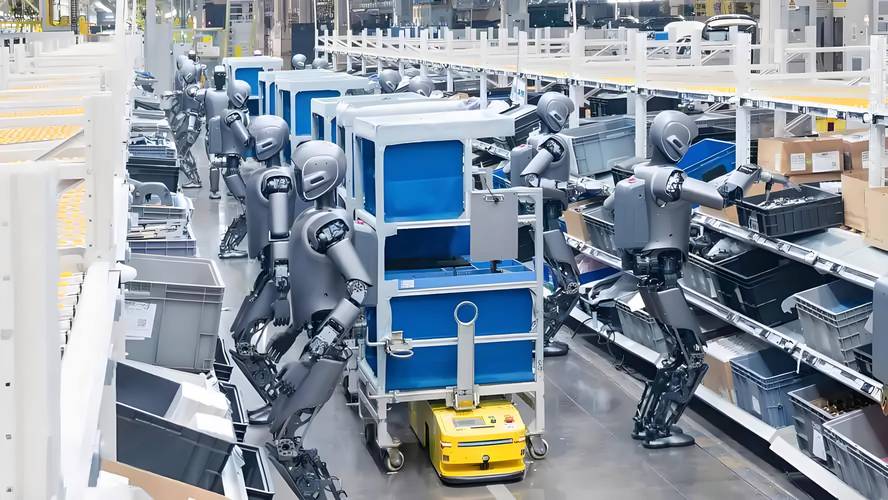 制造企业工业机器人实际工位部署场景对照图
有效计数的核心判定标准,从来不是采购动作的发生,而是技术要素对原有生产流程的替代深度。同样是采购了云服务的小微企业,是把核心生产排程、财务对账、客户管理全流程搬到云端,实现了跨区域的团队协同,还是只是买了个云存储账号存了几份对外的宣传物料,这两类主体对整个产业生态的贡献度天差地别,但在粗口径的统计里,他们会被完全画上等号。
差得远了。
要是把这些只做了表面功夫的主体全算进去,最后得出来的数值,比真实的有效渗透水平高个30%-50%都是常事。拿这种数去做产能规划、去申请政策补贴,最后大概率要踩坑。
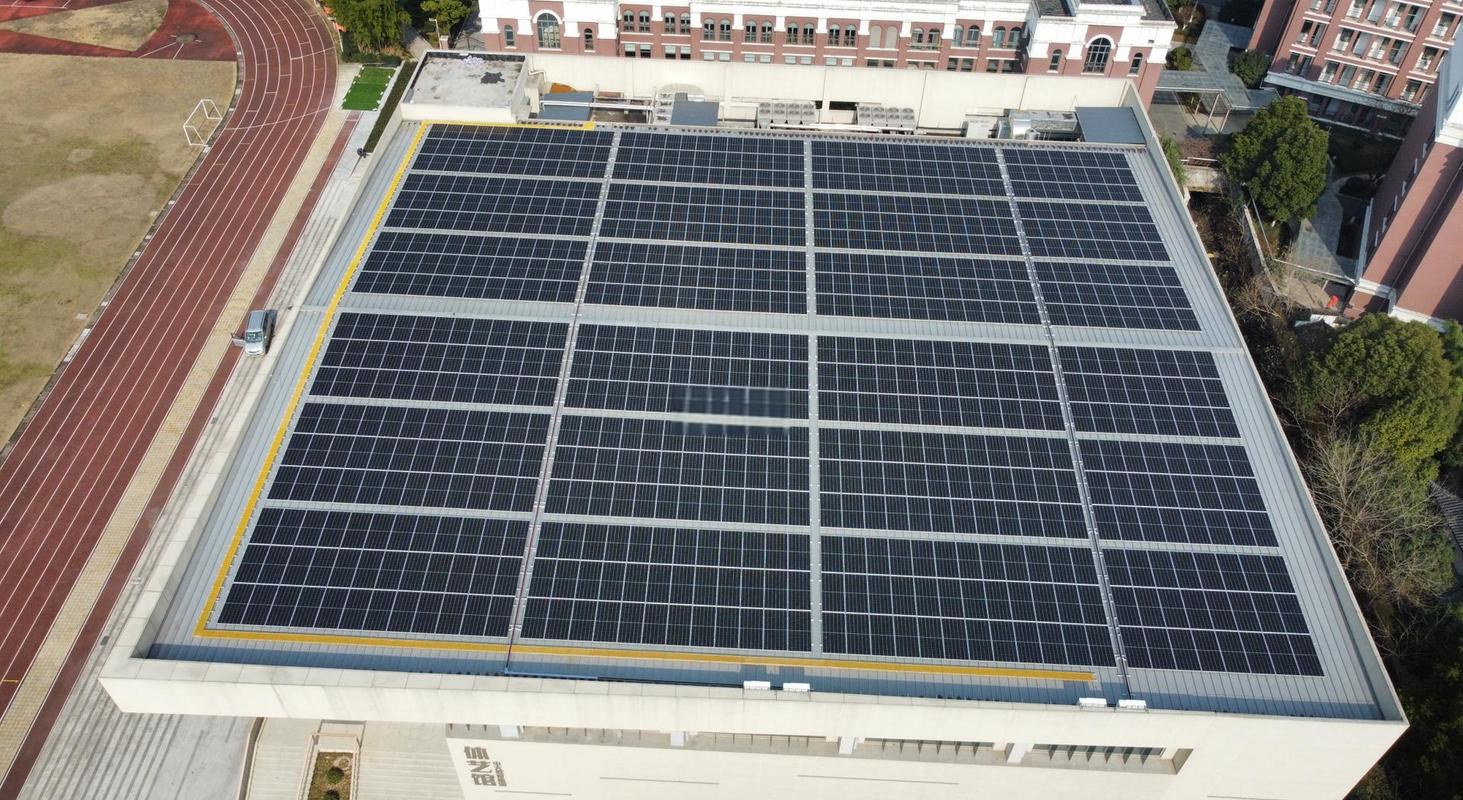 工商业厂房屋顶光伏可安装容量实地测算图
这种偏差带来的误导性极强。很多创业团队看到公开数据里的整体覆盖水平很低,就觉得市场空间巨大,砸钱铺渠道做推广,跑了半年才发现,剩下的样本里大半都是根本没法转化的无效用户,投入的获客成本比预想的高了三四倍。
拿这种错位的数值去做商业测算,不亏才怪。
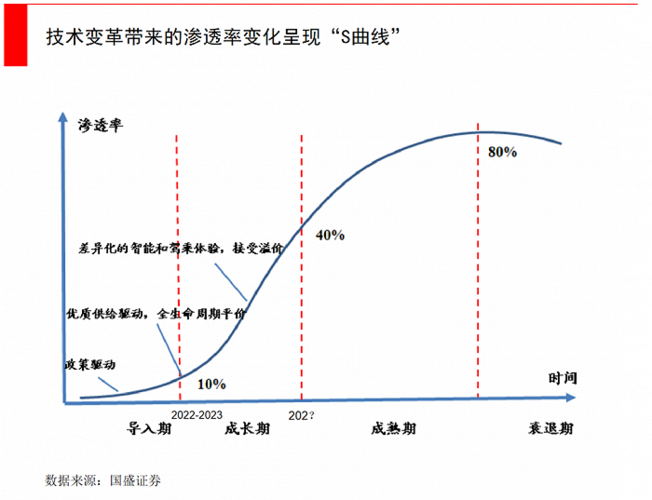 产业渗透阶段增长曲线机制切换示意图
真正的增长拐点,从来不是某个固定的数值刻度,而是驱动增长的核心要素发生切换的节点。比如早期的增长靠政策,中期的增长靠供应链规模效应带来的成本下降,后期的增长靠存量替换的刚性需求。要是没搞懂这个切换节点在哪里,直接拿早期的高速增长斜率算未来的需求,最后出现产能过剩、库存积压,都是大概率的事。
之前车载激光雷达的行业判断就是典型的例子。2021年的时候,行业里算出来的新车搭载率不到2%,一堆人站出来说这个技术路线成本太高,根本没法普及,结果到2023年,这个数值到了15%左右,整个供应链的产能已经铺了好几轮。为啥之前的判断错了?因为把试点阶段的低数值,当成了技术路线的最终市场接受度,完全没算到供应链规模化之后带来的成本下降幅度,会比预想的快得多。
分子端的无效计数
很多人算的时候,习惯把“发生过采购行为”的主体直接算成有效覆盖对象。比如算工业机器人在离散制造领域的普及度,有人把所有采购过至少一台工业机器人的工厂全部计入分子,根本不去核实这台设备到底是在生产线上承担了核心工序,还是摆在展厅当参观道具。 之前接触过长三角一家做汽车结构件的工厂,2022年花120万采购了两台六轴机器人,就放在车间入口的空地上,连电源都没接全,每次有客户来参观,就开个两分钟摆摆样子,实际的焊接工位还是二十多个老师傅拿着焊枪在干活。但在当地的产业智能化统计台账里,这两台设备直接被算成了“智能化改造覆盖企业”的典型案例,计入了对应的统计数值里。 这种计数带来的偏差有多大?制造企业工业机器人实际工位部署场景对照图
有效计数的核心判定标准,从来不是采购动作的发生,而是技术要素对原有生产流程的替代深度。同样是采购了云服务的小微企业,是把核心生产排程、财务对账、客户管理全流程搬到云端,实现了跨区域的团队协同,还是只是买了个云存储账号存了几份对外的宣传物料,这两类主体对整个产业生态的贡献度天差地别,但在粗口径的统计里,他们会被完全画上等号。
差得远了。
要是把这些只做了表面功夫的主体全算进去,最后得出来的数值,比真实的有效渗透水平高个30%-50%都是常事。拿这种数去做产能规划、去申请政策补贴,最后大概率要踩坑。
分母端的边界错位
比分子计数错误更离谱的,是分母的选择。很多人算的时候,习惯把整个行业的全量主体都拉进分母的范围,根本不去筛选那些从一开始就不具备技术适配条件的主体。 比如算分布式光伏在工商业领域的覆盖水平,有人直接把所有工商注册的企业总用电规模、总厂房屋顶面积算成分母,完全不考虑冶金类的高耗能企业,厂房屋顶常年承受高温烟气腐蚀,承重能力根本达不到光伏板的安装要求;也不考虑很多位于核心城区的写字楼,根本没有独立的屋顶使用权,周边的并网容量也早就被占满了。这些主体从一开始就不在可覆盖的范围内,把他们硬塞进分母,最后算出来的数值,会比真实可触达市场里的实际覆盖水平低一大截。 之前和西部某省电网的基层员工聊过,他们2023年做的分布式光伏推广数据,公开口径算出来的整体覆盖比例连12%,但内部摸查的结果是,在所有具备安装条件的工商业主体里,实际的安装率已经超过47%。为啥差这么多?因为算公开数据的时候,把露天矿山堆场、临时搭建的活动板房、根本没有独立产权的街边商铺全算进了总样本里,相当于把没资格参赛的选手全拉进了参赛名单,最后算出来的“参赛率”自然低得离谱。工商业厂房屋顶光伏可安装容量实地测算图
这种偏差带来的误导性极强。很多创业团队看到公开数据里的整体覆盖水平很低,就觉得市场空间巨大,砸钱铺渠道做推广,跑了半年才发现,剩下的样本里大半都是根本没法转化的无效用户,投入的获客成本比预想的高了三四倍。
拿这种错位的数值去做商业测算,不亏才怪。
静态数值的误导性
就算把分子和分母的口径都校准了,也别把某个时间点算出来的静态数值,当成未来长期增长的固定锚点。 很多企业做产能规划的时候,习惯直接拿早期的增长速度线性外推。比如看到某个新技术在市场上的覆盖比例到了10%,就直接算3年后就能到50%,甚至更高。但根本没意识到,渗透的增长从来不是匀速的,每越过一个阈值,对应的驱动机制就会发生本质变化。 早期的覆盖用户,基本都是对价格不敏感、对新技术接受度极高的尝鲜群体,这阶段的增长靠的是政策补贴、行业标杆的示范效应,速度自然快。但当覆盖比例越过20%的阈值之后,剩下的用户基本都是对价格、安装成本、后续服务敏感度极高的群体,增长曲线会从之前的指数型,直接掉到线性,甚至会出现很长时间的平台期。产业渗透阶段增长曲线机制切换示意图
真正的增长拐点,从来不是某个固定的数值刻度,而是驱动增长的核心要素发生切换的节点。比如早期的增长靠政策,中期的增长靠供应链规模效应带来的成本下降,后期的增长靠存量替换的刚性需求。要是没搞懂这个切换节点在哪里,直接拿早期的高速增长斜率算未来的需求,最后出现产能过剩、库存积压,都是大概率的事。
之前车载激光雷达的行业判断就是典型的例子。2021年的时候,行业里算出来的新车搭载率不到2%,一堆人站出来说这个技术路线成本太高,根本没法普及,结果到2023年,这个数值到了15%左右,整个供应链的产能已经铺了好几轮。为啥之前的判断错了?因为把试点阶段的低数值,当成了技术路线的最终市场接受度,完全没算到供应链规模化之后带来的成本下降幅度,会比预想的快得多。