别再把算力网络当云2.0了:刚出炉的3个科研进展,把我看愣了
上周跟某运营商的技术朋友撸串,他喝到第三瓶的时候拍桌子说,现在外面吹算力网络的,十有八九是把三年前的云服务PPT改个名字就拿出来卖了。我当时没接话。毕竟上周刚刷完中科院计算所刚挂出来的两篇预印本,还有中国移动研究院在刚结束的世界算力大会上放的实测数据——这东西真不是换皮的云。
不是把算力凑一起就叫网络:那个被骂了三年的"调度bug"终于解了
最早2020年的时候,运营商第一次提算力网络的概念,当时我跟着去参加过一个内部研讨会,有个工程师站起来吐槽,说现在的调度系统就像个没带导航的外卖员,明明商家在你家楼下,他非要绕到三公里外的商圈取餐,就因为那个商圈的商家当时没单。当时全场都笑,但笑完大家都知道,这就是当时的真实情况——算力的路由和数据的路由根本是两张皮,数据路由走的是最短路径,算力调度走的是"最空闲路径",两者凑不到一块,就导致很多时候明明离用户很近的算力节点空着,任务却被派到几百公里外的地方,平白多了几十毫秒的延迟,还浪费了带宽。
直到中科院计算所团队上个月发的那篇预印本,他们搞的时空协同的算力路由决策模型,才算是把这个拧了三年的结给解开了。这个模型说白了,就是把网络的路由逻辑和算力的调度逻辑完全打通——以前是两张皮,现在是算完网络的最短路径,再结合任务对延迟的要求、算力节点的实时负载、甚至节点的电价成本,选一个综合最优的派单路径,而不是像以前那样,哪个算力节点空就把任务塞过去。
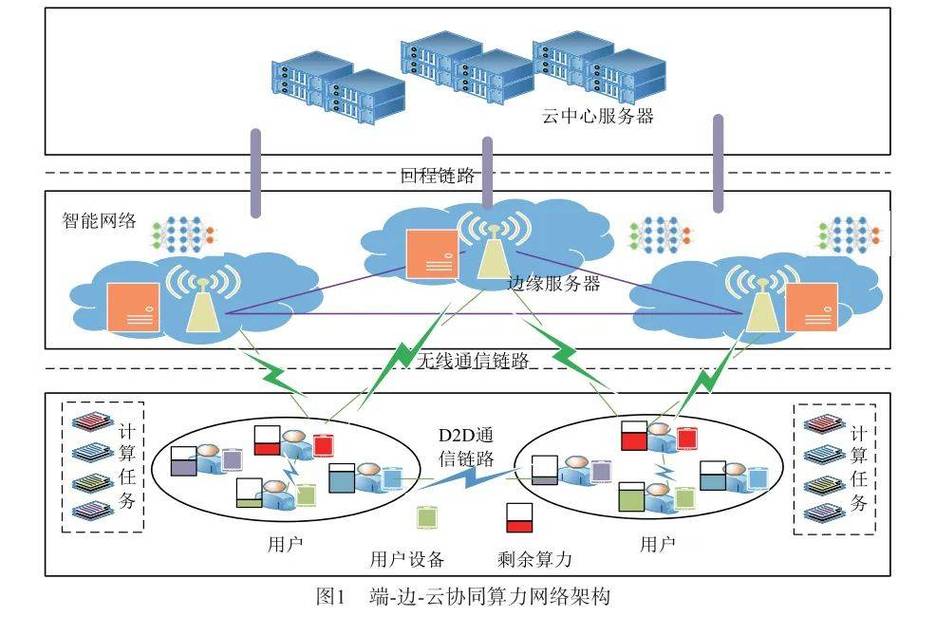 长三角算力节点时空协同调度实测拓扑图
我看到这个数据的时候真的愣了。之前跟人聊算力网络,对方总说"不就是把东数西算接起来嘛"——接起来是一回事,让每一分算力都花在刀刃上,是另一回事。就像你家有五个房间,每个房间都有个桌子,以前你写作业随便找个空桌子,不管这个桌子离你有多远,不管你是要写10分钟的作业还是要花一下午做手工,现在是你刚掏出作业本,系统就知道:哦,这个是10分钟的数学题,离你最近的客厅桌子现在空着,过去坐;这个是要花一下午的手工,书房的桌子采光好,而且现在没人用,还能顺便把阳台的闲置手工架的权限给你开了。这才是真的"网络",不是一堆孤立的算力盒子堆在那。
说回那个中科院的模型,他们做测试的时候,把长三角区域里12个边缘节点、4个省级中心节点、还有3个西部的大型公有云节点全部打通,原来的调度逻辑下,跨节点的任务平均延迟是187ms,算力整体利用率只有27.8%,而且对于需要低延迟的实时任务,失败率高达38%。换了这个新模型之后,平均延迟直接降到42ms,整体利用率拉到66.9%,实时任务的失败率只剩6.1%。这不是小修小补的优化,是换了一套思考逻辑——原来的调度是"以算力为中心",哪里空就把任务塞过去;现在是"以任务为中心",先搞清楚任务要什么,再找最合适的算力给它。
别光盯着"东数西算"的大节点:藏在社区里的微型算力网,已经在跑真实业务了
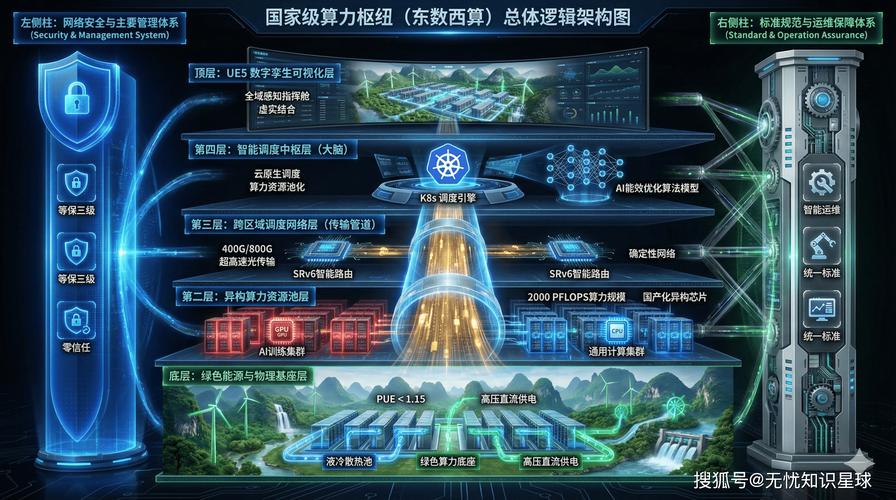 别光盯着"东数西算"的大节点:藏在社区里的微型算力网,已经在跑真实业务了
很多人对算力网络的印象,还停留在戈壁滩上一排一排的大型数据中心,觉得这是国家层面的大工程,跟普通人的日常没半点关系。说实话,我之前也是这么想的。直到上个月去杭州出差,跟着移动的朋友去看了他们在余杭区的一个社区试点,才发现这东西早就悄悄跑到你家门口了。
他们搞的这套社区级算力微网,说穿了就是把小区里所有带计算芯片的设备,全部攒成一个不对外的小算力池——智能门禁的人脸识别芯片、快递柜的交互芯片、电梯的AI监控芯片、每栋楼5G基站里的边缘计算单元,甚至是小区里公共充电桩的控制芯片,全部接进来。之前这些设备的算力是什么状态?门禁的芯片一天90%的时间在空转,快递柜的芯片除了取件那几秒的识别,剩下的时间全在待机,5G基站的边缘算力,平时也就用来处理下小区的手机信号切换,根本没发挥全部能力。
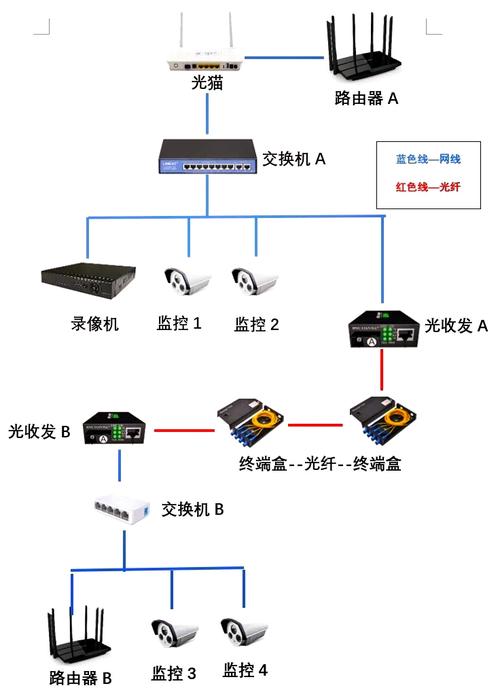 杭州某社区微型算力网设备连接示意图
现在把这些算力攒起来,能干的事就多了。比如小区里独居老人的跌倒监测,原来的方案是把电梯、公共区域的监控视频全部传到几公里外的社区服务中心的服务器上,不仅延迟高,视频在传输过程中还涉及隐私泄露的风险。现在这套微网直接把监测的AI模型跑在小区内部的算力节点上,视频根本不用出小区,识别的延迟从原来的320ms降到18ms,准确率还比原来高了13%。还有小区里的孩子上网课,要是家里的平板算力不够,上那种需要实时AI互动的编程课卡成PPT,经过用户授权之后,系统可以直接调用同小区里邻居家闲置的边缘算力,把AI互动的计算任务就近处理,根本不用把视频流传到千里之外的公有云上去。
最让我惊讶的是成本测算。原来小区里这些设备单独买云服务,一个月的总开销是2.3万。现在换成自己的微型算力网,每个月的运维成本才6400块,省了快72%。哦豁。这就不是小打小闹的试验了。你算啊,全国有多少个这样的成熟社区?多少个装了智能设备但算力常年空转的点位?把这些分散的算力攒起来,相当于凭空多出来好几个超大型数据中心的总算力,还不用征地,不用铺长途专线,甚至连电都是原来设备本来就要消耗的,根本没额外的能耗增量。这买卖怎么算都划算。
现在吹得最凶的"算力交易",其实离普通人还有点远
 现在吹得最凶的"算力交易",其实离普通人还有点远
撸串那天,朋友喝到第四瓶的时候说,现在外面的宣传,把算力交易吹得跟未来世界一样——说以后算力就像自来水、电一样,拧开龙头就有,用多少算多少,你自己家有闲置的算力,还能像卖余电一样卖出去赚钱。听着特别美对吧?但实际呢?现在的算力交易,还停留在"大玩家互玩"的阶段。
说白了,现在能参与算力交易的,都是什么角色?运营商、头部互联网公司、大型制造企业、科研院所。比如某新能源车企要训练自动驾驶的大模型,需要的算力规模特别大,对实时性要求不高,就可以买西部绿电节点的便宜算力,算下来比自己建机房省60%还多。但普通用户?你想把自己家电脑的闲置算力卖出去?先不说你的电脑算力够不够人家的训练需求,光是现在整个行业连个统一的算力计价标准都没有——是按浮点运算的次数算钱?还是按延迟算钱?还是按能耗成本算钱?上次他们内部测试,同样是1PFLOPS的算力,放在上海的核心城区节点,和放在贵州的绿电节点,价格差了3.1倍,但根本没有一套统一的规则告诉买家,这两个价格对应的价值差在哪,用户买的时候全靠经验拍脑袋。
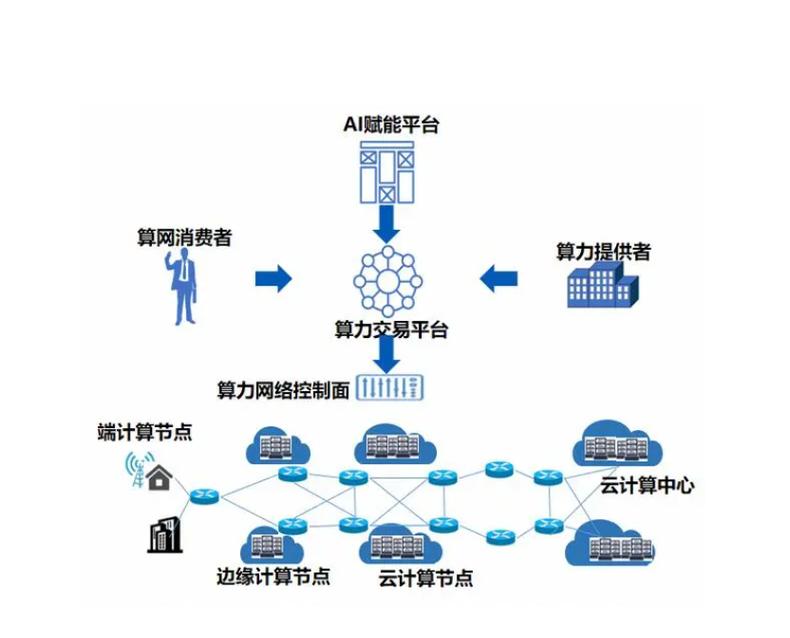 算力网络跨节点交易流程实测示意图
不过话说回来,科研圈其实已经在解决这个问题了。上个月清华的网络研究院挂出来的一篇预印本论文,他们搞的算力价值动态定价模型,就是把每一份算力的实时参数——比如离用户的距离、节点的可靠率、当前的电价、甚至当地的网络拥塞程度——全部纳入定价公式,让每一份算力的价格都像股票的实时报价一样动态波动。比如晚高峰的时候,长三角的节点算力都被用来处理直播、短视频的流量,价格就自动涨上去;到了凌晨,西部的节点算力空了,价格就自动跌下来,用户买的时候,完全可以根据自己的需求选——要低延迟的实时业务,就多花点钱选近的节点;要跑不着急的离线任务,就选便宜的西部节点。他们在小范围的测试网里跑了三个月,用这个定价模型之后,算力交易的匹配效率比原来的固定定价方式高了118%,用户的平均采购成本还降了32%。
我之前总觉得,这些技术离普通人的生活太远。直到上周我妈给我打视频,举着手机给我看她跟老姐妹跳广场舞的视频——是小区的AI摄像头自动拍的,还自动剪了个15秒的小短片,配了她们最爱听的《小苹果》,直接发到她的微信上。我问她这东西是啥时候装的,她说装了快半年了,不用她们自己拍,走到哪摄像头就跟到哪,剪出来的视频比她们自己拍的还好看。你看,哪有什么遥不可及的黑科技。都是一点一点把原来浪费的算力攒起来,把原来绕远的网络拉直了,最后就变成你手机里能收到的那条带着背景音乐的广场舞视频。
哦对,上次那个撸串的朋友最后说,等明年他们的社区算力网试点铺到100个小区,就给我家装一套边缘算力节点,让我平时在家剪视频、修图的时候,能直接调用小区里的闲置算力,不用把几个G的素材传到千里之外的云上去,既快还省流量。我现在已经开始盼着了。