散落的算力拼图:重新理解众包技术平台
很多人对它的第一印象,还停留在“网上找网友干活赚零花钱”。比如数据标注、问卷填写,或是设计征集。
这是非常浅的误解。
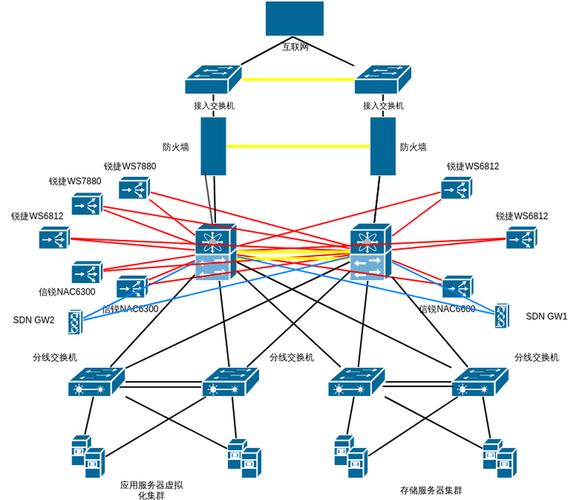 众包分布式任务调度拓扑图
现有成熟的调度机制,会给每个参与者建立动态的能力画像,从任务接单数、完成时长、历史准确率多个维度更新参数,拿到新任务的时候,会优先推给匹配度最高的群体,而不是撒网式投放。这一步,已经把90%没摸到门道的选手挡在了门外。
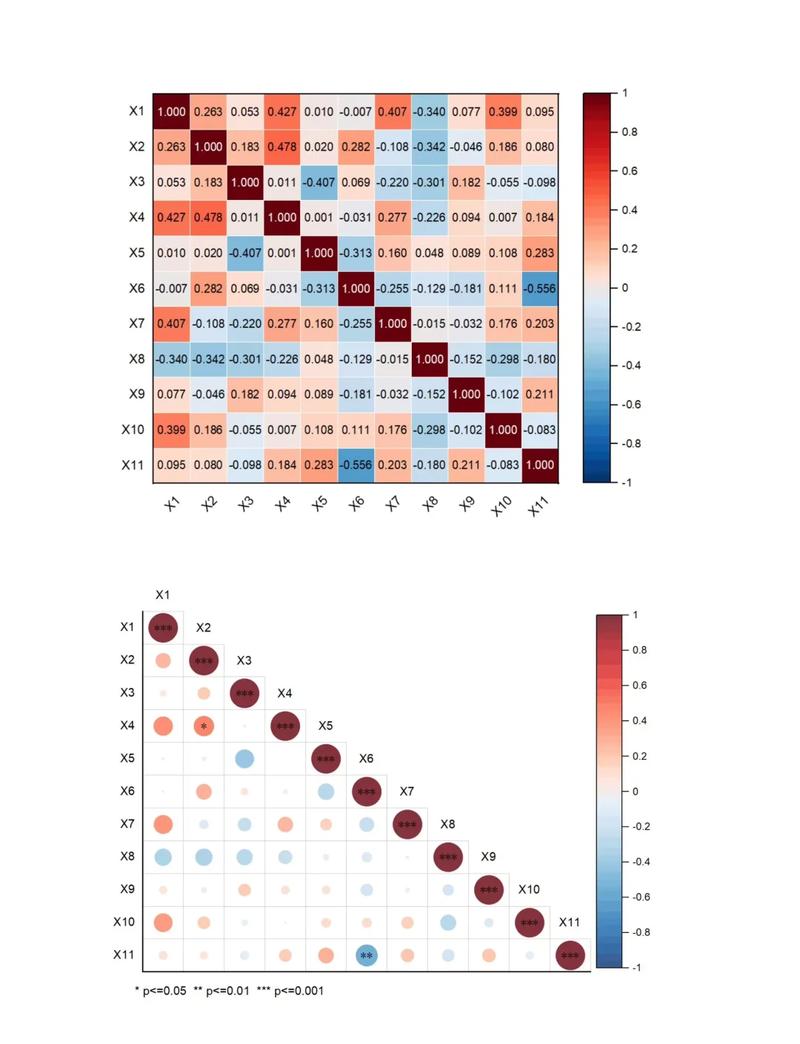 众包标注结果一致性热力对比图
现在行业里试了很多新方法,比如给参与者动态分配权重,历史准确率高的人,结果权重更高,新人权重低,等准确率上来再提权重。这个方法解决了多数投票的问题,但是又带来了新的问题:新人哪怕这次标对了,因为权重低,结果不被采纳,慢慢就留不住人,整个平台的参与者就变成了一群老人,能力圈固化,接不了新领域的任务。
 未来的演化方向
最近两年大模型起来之后,行业里有了新的变化。原来切任务、拼结果都是人工做,现在大模型可以自动把复杂的大任务拆解成符合不同参与者能力的小任务,最后还能自动把零散的结果汇总整合,省去了差不多70%的人工协调成本。
不过话说回来,技术再升级,最核心的问题还是激励和信任。你给的报酬匹配不上工作量,人家就会随便应付,技术再怎么校准也救不了质量。现在做得好的团队,都开始做阶梯式的激励和信用体系,干得好不仅单价更高,还能优先接到高报酬的新任务,形成正向循环,比原来干一块钱一张的死工资强太多。
它从来不是要替代传统的专业机构,更像是对现有生产体系的补充——把那些大企业没时间做、小机构做不了的零散任务,分给社会上闲置的智力和劳动力,把散落的拼图拼成完整的图案。至于那些喊着颠覆一切的口号,听听就好,真要落地,还是得一个坑一个坑填过去。
被简化的“分布式分工”本质
它的核心,从来不是把任务拆碎了发出去收钱这么简单。本质是分布式异构能力的动态聚合——和云计算中标准化的服务器算力不同,参与任务的每个个体,能力、时间、准确度、擅长领域全不一样。 有人一天能标一万张普通图像,准确率95%。有人一周只能标一百张医疗影像,准确率能到99%。怎么把不同的任务,匹配给最合适的人,再把零散的结果整合成可用的最终产出,这才是技术的核心。 说实话,我见过太多创业团队栽在这里。拉个群,找一批学生,切吧切吧就把任务发出去,最后收上来的东西错漏百出,根本用不了。众包分布式任务调度拓扑图
现有成熟的调度机制,会给每个参与者建立动态的能力画像,从任务接单数、完成时长、历史准确率多个维度更新参数,拿到新任务的时候,会优先推给匹配度最高的群体,而不是撒网式投放。这一步,已经把90%没摸到门道的选手挡在了门外。
绕不开的质量校准死结
哪怕调度做对了,质量问题依旧是悬在头上的刀。 标注任务里,同一张模糊的道路图像,十个人可能出三个不同的结果。古生物化石轮廓标注,业余爱好者甚至会把岩石缝隙当成化石轮廓,十个人八个错,你靠多数投票出结果,最终肯定错。 质量校准的常规操作,是抽一定比例的结果交给领域专家复核,用专家结果做金标准反推整个批次的准确率,再调整参数。但这里的限制非常明显:抽10%的量,成本直接涨一倍,很多项目本来就是冲着低成本来的,根本扛不住。抽1%,又很容易漏掉系统性的错误。 这不是危言耸听。去年接触过一个做自动驾驶训练数据的团队,就是靠低价抢单,把复核比例压到了0.5%,结果交付给车企的数据集里,12%的雨天非机动车标注错了类别,模型训练出来直接把电动车识别成路牌,差点出了测试事故,最后整个项目全额退款,公司直接没了。众包标注结果一致性热力对比图
现在行业里试了很多新方法,比如给参与者动态分配权重,历史准确率高的人,结果权重更高,新人权重低,等准确率上来再提权重。这个方法解决了多数投票的问题,但是又带来了新的问题:新人哪怕这次标对了,因为权重低,结果不被采纳,慢慢就留不住人,整个平台的参与者就变成了一群老人,能力圈固化,接不了新领域的任务。
容易被忽略的应用边界
现在圈子里总有人炒概念,说未来所有工作都可以拆解放上来,其实根本不是这么回事。它有非常清晰的适用边界。 适合的场景,一定是任务可拆分、结果可独立校验的。比如AI训练数据标注,本身每一张图的标注都是独立的,拆出来给不同的人做,最后拼起来不影响结果。再比如小众市场的创意征集,本来就是要不同背景的人出不同方案,拆分本身就是价值。 那什么不适合?需要深度协同、强流程依赖的任务。比如一款新芯片的整体设计,前端设计和后端验证环环相扣,每个模块的接口标准必须统一,拆给几百个不同背景的人做,最后根本拼不起来,光接口调试就能把人逼疯。还有涉及核心敏感数据的任务,哪怕你把数据拆成了碎片,也架不住有心人把碎片重新拼接还原。之前国内某城商行做用户行为分析,把脱敏后的拆分数据放出去,结果被第三方拼接出了上千名高净值用户的完整信息,引发了非常大的隐私危机。 还有知识产权的模糊地带,很多平台的用户协议只写了平台可以使用成果,没说清楚委托方的所有权,最后征集到好方案,设计者反过来告委托方侵权,这种官司每年都有好多起。未来的演化方向
未来的演化方向
最近两年大模型起来之后,行业里有了新的变化。原来切任务、拼结果都是人工做,现在大模型可以自动把复杂的大任务拆解成符合不同参与者能力的小任务,最后还能自动把零散的结果汇总整合,省去了差不多70%的人工协调成本。
不过话说回来,技术再升级,最核心的问题还是激励和信任。你给的报酬匹配不上工作量,人家就会随便应付,技术再怎么校准也救不了质量。现在做得好的团队,都开始做阶梯式的激励和信用体系,干得好不仅单价更高,还能优先接到高报酬的新任务,形成正向循环,比原来干一块钱一张的死工资强太多。
它从来不是要替代传统的专业机构,更像是对现有生产体系的补充——把那些大企业没时间做、小机构做不了的零散任务,分给社会上闲置的智力和劳动力,把散落的拼图拼成完整的图案。至于那些喊着颠覆一切的口号,听听就好,真要落地,还是得一个坑一个坑填过去。