航天摔过的坑,喂大了容错计算技术
前几年跟航天口的老工程师吃饭,听他讲了九十年代的一件旧事。当年发一颗试验卫星,上天没半个月就彻底失联,最后查原因,就是控制系统里一个存储位出错,指令算错了,卫星直接偏轨。就这么点错。毁了几个亿的投入。要是那时候他们用了成熟的容错计算技术,结果完全不一样。
错是常态,不是例外
很多人觉得,计算机是绝对理性的,说一不二,怎么会出错?
说实话,错才是硬件运行的常态。哪怕你工艺做到最顶尖,一块指甲大的芯片上几十亿个晶体管,总有一个会出问题。更别说还有来自太空的宇宙射线,随时打在内存上,一不小心就把一个bit的数值给改了——这个就是业内常说的bit翻转,听起来玄乎,其实每天都在世界各地的服务器里发生。
 宇宙射线引发内存bit翻转示意图
我刚入行那年,跟着师傅修银行的前置机,好好的机器每周总有那么一次,莫名其妙对不上账,查了半个月代码都没找到bug,最后换了带纠错的内存,问题立刻解决。原来就是宇宙射线搞的鬼,偶尔翻一个bit,刚好改了记账的数字,你说找哪说理去?
容错计算的核心从来不是杜绝错误,而是包容错误。说白了,就是提前想好:哪可能出错?出了错之后怎么接着干活?怎么不让小错变成崩整个系统的大错?不是跟错误死磕非要消灭它,是揣着错误还能把事儿给办了。
说起来好像很复杂,其实思路跟我们生活里的做法一模一样。你出门旅游,把重要证件放你包里,再放一份复印件在你伴侣包里,这不就是容错?你跟客户签合同,写完了自己核对一遍再让同事核对一遍,这不也是容错?技术只是把这套人类早就会用的思路,给系统化搬到了计算机系统里而已。
最接地气的容错,其实你天天在用
很多人觉得容错计算是航天、核工业这种高大上领域才用的玩意儿,跟我没关系。不对,你今天能刷手机逛网站存照片,全靠容错计算在背后兜着。
就说你存照片的云盘吧,几十上百张照片存在云端,从来没丢过吧?背后的分布式存储,用的就是最基础的容错思路:把你的文件拆成块,存多份在不同的硬盘不同的服务器上,哪一块硬盘坏了,直接从别的块拼回来就行了,你根本感觉不到。
早年玩台式机的朋友可能听过硬盘阵列,其中最常见的RAID5就是典型的容错设计。N块硬盘一起干活,你存一份数据,会留出一块硬盘的空间存校验信息,只要不同时坏两块盘,坏了任意一块,换个新盘上去就能把原来的数据完完整整算出来,业务一点都不耽误。
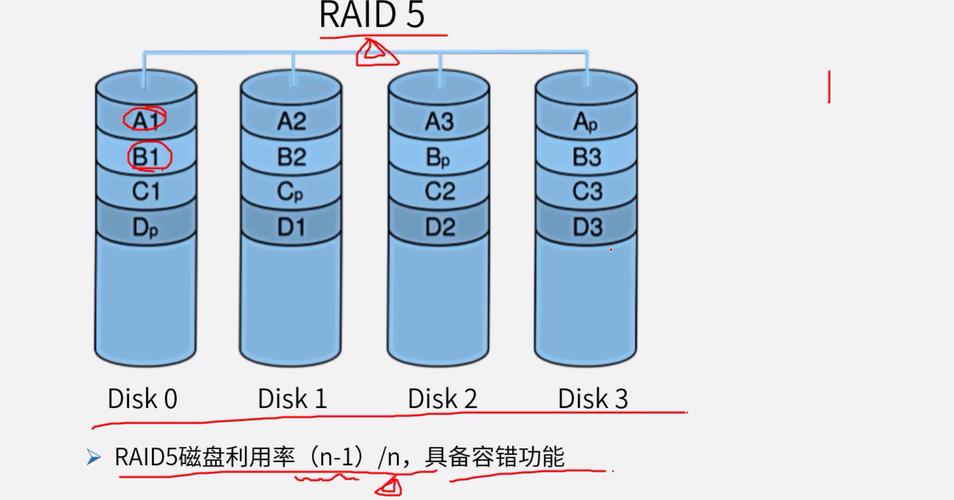 磁盘阵列RAID5容错原理图
你现在用的手机,旗舰款基本都带ECC纠错内存,就是每存几个bit就带一个校验位,万一错了一个,内存控制器自动就能改过来,不会让你好好的聊天突然闪退,更不会让你付账的时候刷不出来。这些都是容错计算落地上百年,做到千家万户的例子。
不过话说回来,不是只有硬件需要容错,软件也需要。你写代码,谁能保证自己写的代码一点bug都没有?好的容错设计,就是某一个模块出bug崩了,不会连累整个系统,监控自动把这个模块重启,或者把请求转到别的正常模块上,用户该用什么用什么,根本感觉不出来。我之前做电商系统,大促的时候总有个别模块出点小问题,因为做了容错降级,最多就是少一个推荐商品的功能,付钱买货一点不耽误,总比整个网站瘫了强吧?
别神化,容错也有绕不开的边界
 别神化,容错也有绕不开的边界
现在很多做架构的朋友,张口闭口就是高可用多活,上来就要堆九个九的可用性,好像不做满容错就是技术不行。其实我一直觉得,这就是被忽悠瘸了。
容错不是零错,更不是万能的,它从根上就带着代价,成本永远是容错绕不开的坎。你要做多份冗余备份,就得买更多的硬盘更多的服务器,就得花更多的带宽更多的电费,就得写更多的代码维护这套逻辑,这些都是真金白银。
你一个个人博客,一天访问量才几百,犯得上搞三地五中心多活吗?服务器崩了重启十分钟,最多也就少十个访问,犯得着花几十万堆容错吗?反过来,航天火箭的控制系统,银行的记账系统,社保的结算系统,错一次就是人命就是上亿损失,那砸多少钱堆容错都值得。容错是跟着你的风险走的,不是为了堆技术而堆。
还有一个常见误区:觉得容错能扛所有类型的错误。不对。比如你整个系统的设计逻辑错了,所有人都按错的逻辑跑,容错再怎么兜也兜不住。再比如分布式系统里的拜占庭问题,简单说就是你的多个节点里,有坏节点故意给你发错消息,还串通起来骗你,普通的容错根本搞不定,得专门的拜占庭容错算法才能扛,而且算法本身成本就高得离谱,不是所有场景都能用。
现在大模型训练火了,容错计算又有了新的用场。你想啊,训练一个大模型要几千块GPU跑好几个星期,中途只要一个GPU出点错,整个训练过程就废了,重新跑一遍几十万就没了。现在常用的做法就是每隔一段时间存一次检查点,出了错就从最近的检查点接着跑,不用从头来,这不就是新场景下的容错思路吗?
说实话,我干了十几年技术,越来越觉得容错计算是个挺浪漫的技术。它从一开始就是接受了“这个世界不完美”这个前提,没有吹什么“我们能做到百分百不出错”的牛逼,只是默默在背后给所有可能出错的地方兜着底。你平时感觉不到它的存在,它也不需要你感觉到,真出事了,它站出来把问题接了,让你该干嘛干嘛。
这大概就是所有基础设施该有的样子吧。不抢风头,只兜底线。