数字孪生技术:是风口噱头,还是真落地的产业革命?
上个月去上海参加工业博览会,转了一圈,十个做工业数字化的展商,八个展台都挂着数字孪生的牌子。说实话,我一开始以为又是资本炒出来的新概念,就跟前几年蹭热度的元宇宙一样,圈完一轮融资就没声了。直到进去跟一个做电力运维的老工程师聊了三个小时,我才发现,这玩意儿跟那些空壳概念真不一样。
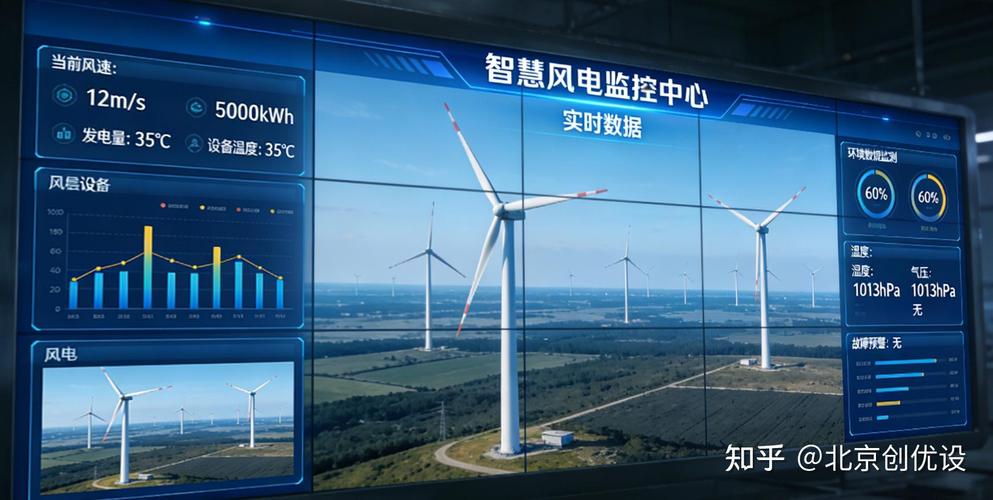 风力发电场数字孪生实时监控界面
其实这概念一点都不新鲜,早在上世纪60年代NASA就用它来做航天飞行器的故障模拟了。那时候算力贵得离谱,传感器也不普及,根本做不到实时数据同步,所以一直躺在实验室的论文里吃灰。直到最近十年,云计算成本降到了原来的十分之一,普通工业传感器几十块钱就能买到,5G能做到毫秒级数据传输,这东西才真的走出实验室,走到产业里。很多厂商把它吹得玄之又玄,剥开包装看本质,就是给物理实体做一个会“呼吸”的虚拟分身,帮你省成本、赚大钱,没那么多虚的。
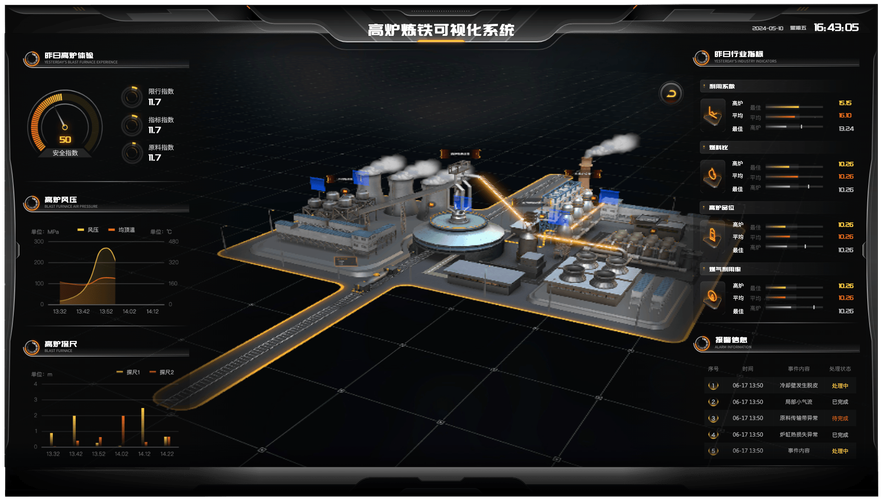 钢铁厂炼钢高炉数字孪生运维系统图
不过话说回来,能做成这样的项目真的太少了。我之前接触过一个地级市的智慧城市项目,预算八千万做数字孪生城市大脑,结果七千万都花在了做城市三维模型和拼接大屏上,真正对接交通、水电实时数据的部分,只花了不到一千万,最后就是个好看的摆设,点开动不了几分钟就卡,挺浪费钱的。
 数字孪生技术接下来要闯过哪几道坎?
现在行业里最大的误区,就是所有人都盯着前端好看的大屏,没人愿意啃后端的数据硬骨头。做数字孪生最难的根本不是建3D模型,现在建模工具已经很成熟了,几千块就能搞定一个普通设备的模型。难的是把工厂里不同厂商、不同年代的老设备数据,统一标准,实时同步出来。很多十几年的老工厂,设备连联网接口都没有,你怎么拿数据?全工厂新装一遍传感器,大几千万砸进去,中小企业根本扛不住这个成本。
其次就是模型的准确率问题。现在大部分数字孪生模型,应对常规运行状态没问题,碰到极端情况——比如地震、超负载、极端天气,模拟出来的结果跟实际情况差得不是一点半点,没人敢把核心决策完全交给模型。最近两年大模型跟数字孪生来结合,倒是出了挺让人惊喜的新方向。上个月我看清华大学水利系的最新科研成果,他们把大模型用到了水利大坝的数字孪生模型里,不用人工一点点调参数,大模型能自己根据历史数据优化模型,对洪水渗漏隐患的预判准确率比原来提高了32%,能提前一周预判小型渗漏,这放在以前根本做不到。
还有个绕不开的问题就是标准不统一。现在各家做数字孪生都是各搞各的标准,你做的风机孪生模型,放到另一个品牌的风场里就用不了,数据格式不兼容,接口接不上,每次都要重复开发,成本一下就上去了。好在工信部今年已经开始推进数字孪生的行业标准制定,估计再过两三年,这个问题能慢慢理顺。
我现在对数字孪生技术的态度,就是不吹也不黑。它不是什么一夜改变世界的超级神器,也不是资本炒出来割韭菜的噱头。它就是数字化发展到今天,水到渠成出来的一个工具——你有了全链路的数据,有了足够便宜的算力,自然就想做一个一模一样的虚拟分身,帮你试错、帮你优化,帮你赚更多钱。
再过五年你再看,数字孪生就会变成工业领域跟CAD、PLC一样普通的基础工具,没人再拿它当新奇概念吹了。那时候,才是它真正改变产业的时候。
别被PPT忽悠了,数字孪生技术到底是什么?
很多人看宣传册上花里胡哨的3D效果图,就以为数字孪生就是给工业设备做个好看的三维模型,用来撑门面。不对。数字孪生的核心,是把物理实体的全维度运行数据,实时同步映射到虚拟空间,最终用虚拟模型来模拟、预判、优化实体的运行状态。 举个最简单的例子,你造一台离岸风力发电机,不是做完设计模型拍个宣传照就完了。是要把风机每一片叶片的实时受力、轴承的温度变化、风场的分钟级风速风向,每秒都同步到虚拟模型里。这个虚拟分身能提前三个月告诉你,哪个部位的轴承可能会疲劳出故障,能算出今天这个风力条件下,叶片转什么角度发电效率最高。风力发电场数字孪生实时监控界面
其实这概念一点都不新鲜,早在上世纪60年代NASA就用它来做航天飞行器的故障模拟了。那时候算力贵得离谱,传感器也不普及,根本做不到实时数据同步,所以一直躺在实验室的论文里吃灰。直到最近十年,云计算成本降到了原来的十分之一,普通工业传感器几十块钱就能买到,5G能做到毫秒级数据传输,这东西才真的走出实验室,走到产业里。很多厂商把它吹得玄之又玄,剥开包装看本质,就是给物理实体做一个会“呼吸”的虚拟分身,帮你省成本、赚大钱,没那么多虚的。
那些真金白银落地的项目,都做成了什么样?
实话实说,现在市面上90%号称做数字孪生的项目,都是面子工程。花大价钱做个超高清的3D大屏,放在企业展厅或者政务中心给领导参观,参观完门一锁就断电落灰。但剩下那10%真扎进业务里的项目,已经开始实实在在改变行业了。 去年夏天南方那场创纪录的大高温,很多人应该都还有印象。那时候广东电网全网负荷破了历史极值,放在十年前,调度员只能靠着经验判断,哪里不够电就先拉哪里的闸,很容易误判影响居民用电。现在南方电网搭的数字孪生电网,每秒钟更新一次全网的负载数据,能提前24小时算出哪个区域会过载,哪个变电站的冗余容量可以调度过去,那波大负荷愣是没出现大范围的拉闸限电。 宝钢的数字孪生炼钢高炉更实在。以前高炉内壁的侵蚀程度,只能靠人工定期停炉检测,一停炉就是几百万上千万的产量损失,不检测又怕出安全事故。现在呢?数字孪生模型通过炉壁上千个传感器的实时数据,能算出内壁剩余厚度,预判检修时间,准确率超过95%,光减少停炉次数这一项,一年就能省下两个多亿。钢铁厂炼钢高炉数字孪生运维系统图
不过话说回来,能做成这样的项目真的太少了。我之前接触过一个地级市的智慧城市项目,预算八千万做数字孪生城市大脑,结果七千万都花在了做城市三维模型和拼接大屏上,真正对接交通、水电实时数据的部分,只花了不到一千万,最后就是个好看的摆设,点开动不了几分钟就卡,挺浪费钱的。
数字孪生技术接下来要闯过哪几道坎?
数字孪生技术接下来要闯过哪几道坎?
现在行业里最大的误区,就是所有人都盯着前端好看的大屏,没人愿意啃后端的数据硬骨头。做数字孪生最难的根本不是建3D模型,现在建模工具已经很成熟了,几千块就能搞定一个普通设备的模型。难的是把工厂里不同厂商、不同年代的老设备数据,统一标准,实时同步出来。很多十几年的老工厂,设备连联网接口都没有,你怎么拿数据?全工厂新装一遍传感器,大几千万砸进去,中小企业根本扛不住这个成本。
其次就是模型的准确率问题。现在大部分数字孪生模型,应对常规运行状态没问题,碰到极端情况——比如地震、超负载、极端天气,模拟出来的结果跟实际情况差得不是一点半点,没人敢把核心决策完全交给模型。最近两年大模型跟数字孪生来结合,倒是出了挺让人惊喜的新方向。上个月我看清华大学水利系的最新科研成果,他们把大模型用到了水利大坝的数字孪生模型里,不用人工一点点调参数,大模型能自己根据历史数据优化模型,对洪水渗漏隐患的预判准确率比原来提高了32%,能提前一周预判小型渗漏,这放在以前根本做不到。
还有个绕不开的问题就是标准不统一。现在各家做数字孪生都是各搞各的标准,你做的风机孪生模型,放到另一个品牌的风场里就用不了,数据格式不兼容,接口接不上,每次都要重复开发,成本一下就上去了。好在工信部今年已经开始推进数字孪生的行业标准制定,估计再过两三年,这个问题能慢慢理顺。
我现在对数字孪生技术的态度,就是不吹也不黑。它不是什么一夜改变世界的超级神器,也不是资本炒出来割韭菜的噱头。它就是数字化发展到今天,水到渠成出来的一个工具——你有了全链路的数据,有了足够便宜的算力,自然就想做一个一模一样的虚拟分身,帮你试错、帮你优化,帮你赚更多钱。
再过五年你再看,数字孪生就会变成工业领域跟CAD、PLC一样普通的基础工具,没人再拿它当新奇概念吹了。那时候,才是它真正改变产业的时候。