大数据技术研发:跳出纸面的真创新和踩过的坑
去年跟某大厂出来创业的朋友吃饭,他拍着桌子吐槽,见了快二十个做大数据研发的团队,一半拿出来的方案还是五年前的Lambda架构套壳,改改参数就敢说自己是新一代实时数仓。
现在的大数据技术研发,早就不是十年前只要能搭起来集群就能交差的时代了。
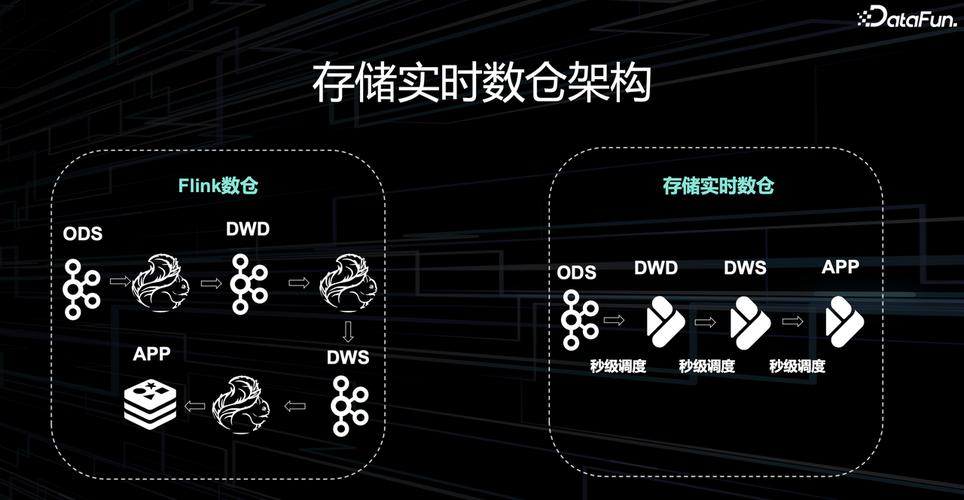 大数据研发实时数仓生产部署对比图
现在研发的门槛,早就从“会搭集群”变成了“会省成本”,会根据业务的体量做适配。
你能把一个十万级QPS的实时计算任务,把成本压到原来的一半,比你搞十个花里胡哨的新架构都有用。
对吧?
 大数据研发冷数据压缩性能测试对比图
之前跟国内做时序数据库的团队聊天,他们说现在产品能打,核心就是解决了一个别人都没当回事的小问题:工业场景下设备时钟偏移导致的乱序数据重写。
听起来很low对不对?但工业监控场景下,成百上千台设备根本做不到统一授时,数据飘个十分八分钟是常事,你不解决这个问题,用户的趋势图就是乱的,报警天天误报,再牛逼的写入吞吐有什么用?
说实话,现在大数据技术研发早就过了拼宏观概念的阶段,真能打出差异化的,都是把这些细碎的问题磨到极致的团队。我见过一个团队,为了优化星型模型下多表关联的速度,把关联键的编码方式改了七次,最后把内存占用降了40%,查询速度提了一倍,这才是真本事。不是什么宏大叙事,就是一刀一枪磨出来的。
 研发落地最难的关:得跟业务一起趟泥巴
很多做研发的朋友跟我吐槽,我算法写得漂亮,顶会论文也发了,为什么做出来的产品就是没人用?
问题就出在,你从来没下过业务的泥坑,所有的优化都是对着测试集来的,脱离了真实场景。
举个例子,前年有个朋友的团队做大数据用户画像研发,测试集上标签准确率快98%,一上线全乱了。为什么?原来真实业务里,同一个“高价值用户”,电商部门认GMV,内容部门认停留时长,运营部门还要算分享转发率,你拿着统一的公式一套,出来的结果谁都用不了。
最后他们怎么解决的?拉了三个业务分析师进研发组,一起住了半个月办公室,天天改规则,最后把标签生成做成了可配置的分层架构,不同业务线可以自己拼规则,改拼接逻辑不用找研发排期,一下子就活了,现在这个产品已经变成了公司营收最高的ToB产品。
不过话说回来,现在很多做研发的还是放不下身段,觉得我搞底层技术的,为什么要管业务那些乱七八糟的破事?
哦,你搞的是大数据技术研发啊。大数据本身就是从业务里来,到业务里去的,你脱离了真实业务,你的技术不就是空中楼阁吗?
我去年听一个农业大数据团队分享,他们给牧场做牛的健康监测,研发团队一开始在实验室调参数,准确率怎么都上不去,最多60%,后来负责人直接让所有研发去牧场住了一个月,跟着喂牛的师傅天天转,才发现原来传感器放的位置不对,牛走路蹭栏杆会干扰信号,还有不同年龄段的牛体温基线根本不一样,你用统一的阈值当然错。改完之后,准确率直接涨到92%,现在已经铺了快十万头牛了。
你说,这跟你在实验室对着公开数据集调参能一样吗?
现在好多人喊,大数据技术研发已经到瓶颈了,没什么新东西可做了。哪是没新东西,是你不愿意往下走,不愿意蹲到泥坑里找问题啊。
满地都是没解决的问题,满地都是机会,就看你愿不愿意弯腰去捡。那些天天追热点炒概念的,最后都是一地鸡毛,反而那些闷头啃硬骨头,跟业务一起趟坑的,最后都攒出了真东西。
对吧?
别拿PPT架构凑数,门槛早变了
说实话,现在不管是大厂还是创业公司,要的从来不是“听起来很厉害”的架构,是真能解决问题,还不花钱。 你给一个年营收不到一个亿的线下零售做方案,上来就要人家搭三个可用区存算分离集群,光存储一年就要几十万,人家疯了才用你的方案。 很多人现在还在追热点,向量数据库火了全做向量,大模型火了全做RAG,根本不管客户真的需要什么。去年我见过一个创业团队,拿了融资就全栈换了向量引擎,做了大半年,最后连第一个付费客户都找不到——大部分中小企业连标注好的百万级向量数据集都凑不出来,要你这个从零写的向量引擎干嘛?找个成熟开源项目改改参数,完全够用。大数据研发实时数仓生产部署对比图
现在研发的门槛,早就从“会搭集群”变成了“会省成本”,会根据业务的体量做适配。
你能把一个十万级QPS的实时计算任务,把成本压到原来的一半,比你搞十个花里胡哨的新架构都有用。
对吧?
现在的真突破,全在细碎的细节里
不知道你有没有发现,这两年顶会上大数据方向的好论文,很少再有那种“颠覆整个体系”的大创新了,几乎全是抠细节抠出来的成果。 之前我看一篇国内清北团队发的成果,就是优化了冷数据归档场景下的LZ4压缩编码,把压缩率提了18%,解压速度还不降反升。听起来没什么了不起对不对?但你想想,国内互联网公司每年新增的冷数据都是EB级别的,18%的压缩率,就是几千万上亿的存储成本省下来了。这就是研发的实打实价值。大数据研发冷数据压缩性能测试对比图
之前跟国内做时序数据库的团队聊天,他们说现在产品能打,核心就是解决了一个别人都没当回事的小问题:工业场景下设备时钟偏移导致的乱序数据重写。
听起来很low对不对?但工业监控场景下,成百上千台设备根本做不到统一授时,数据飘个十分八分钟是常事,你不解决这个问题,用户的趋势图就是乱的,报警天天误报,再牛逼的写入吞吐有什么用?
说实话,现在大数据技术研发早就过了拼宏观概念的阶段,真能打出差异化的,都是把这些细碎的问题磨到极致的团队。我见过一个团队,为了优化星型模型下多表关联的速度,把关联键的编码方式改了七次,最后把内存占用降了40%,查询速度提了一倍,这才是真本事。不是什么宏大叙事,就是一刀一枪磨出来的。
研发落地最难的关:得跟业务一起趟泥巴
研发落地最难的关:得跟业务一起趟泥巴
很多做研发的朋友跟我吐槽,我算法写得漂亮,顶会论文也发了,为什么做出来的产品就是没人用?
问题就出在,你从来没下过业务的泥坑,所有的优化都是对着测试集来的,脱离了真实场景。
举个例子,前年有个朋友的团队做大数据用户画像研发,测试集上标签准确率快98%,一上线全乱了。为什么?原来真实业务里,同一个“高价值用户”,电商部门认GMV,内容部门认停留时长,运营部门还要算分享转发率,你拿着统一的公式一套,出来的结果谁都用不了。
最后他们怎么解决的?拉了三个业务分析师进研发组,一起住了半个月办公室,天天改规则,最后把标签生成做成了可配置的分层架构,不同业务线可以自己拼规则,改拼接逻辑不用找研发排期,一下子就活了,现在这个产品已经变成了公司营收最高的ToB产品。
不过话说回来,现在很多做研发的还是放不下身段,觉得我搞底层技术的,为什么要管业务那些乱七八糟的破事?
哦,你搞的是大数据技术研发啊。大数据本身就是从业务里来,到业务里去的,你脱离了真实业务,你的技术不就是空中楼阁吗?
我去年听一个农业大数据团队分享,他们给牧场做牛的健康监测,研发团队一开始在实验室调参数,准确率怎么都上不去,最多60%,后来负责人直接让所有研发去牧场住了一个月,跟着喂牛的师傅天天转,才发现原来传感器放的位置不对,牛走路蹭栏杆会干扰信号,还有不同年龄段的牛体温基线根本不一样,你用统一的阈值当然错。改完之后,准确率直接涨到92%,现在已经铺了快十万头牛了。
你说,这跟你在实验室对着公开数据集调参能一样吗?
现在好多人喊,大数据技术研发已经到瓶颈了,没什么新东西可做了。哪是没新东西,是你不愿意往下走,不愿意蹲到泥坑里找问题啊。
满地都是没解决的问题,满地都是机会,就看你愿不愿意弯腰去捡。那些天天追热点炒概念的,最后都是一地鸡毛,反而那些闷头啃硬骨头,跟业务一起趟坑的,最后都攒出了真东西。
对吧?