智能决策支持:别把“辅助”做成“替代”的韭菜生意
我上个月跟做连锁零售的老陈在大排档喝酒,他拍着木桌子吐槽,脑门上青筋都跳出来。说前两年跟风花八十多万上了一套号称“全自动智能决策”的系统,选址拓店全交给系统算。结果选出来的黄金位置,开了不到八个月就关门,亏了小两百万。
很多人一听到智能决策支持,要么觉得神乎其神能包治百病,要么觉得全是割韭菜的骗局。其实两边都走了极端。
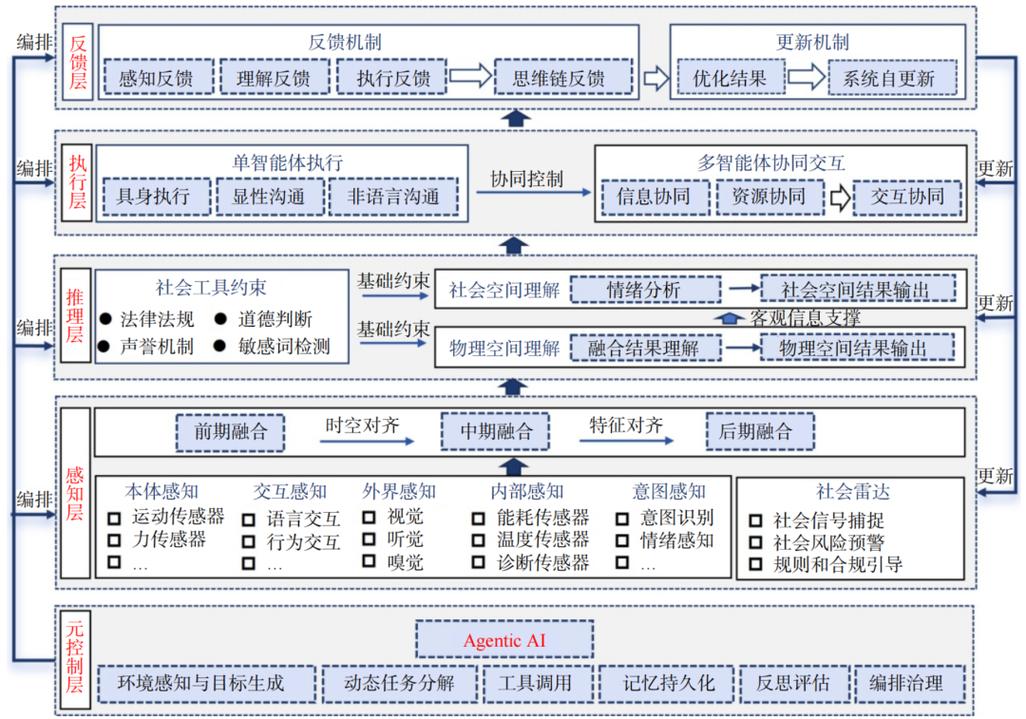 智能决策支持人企协同框架图
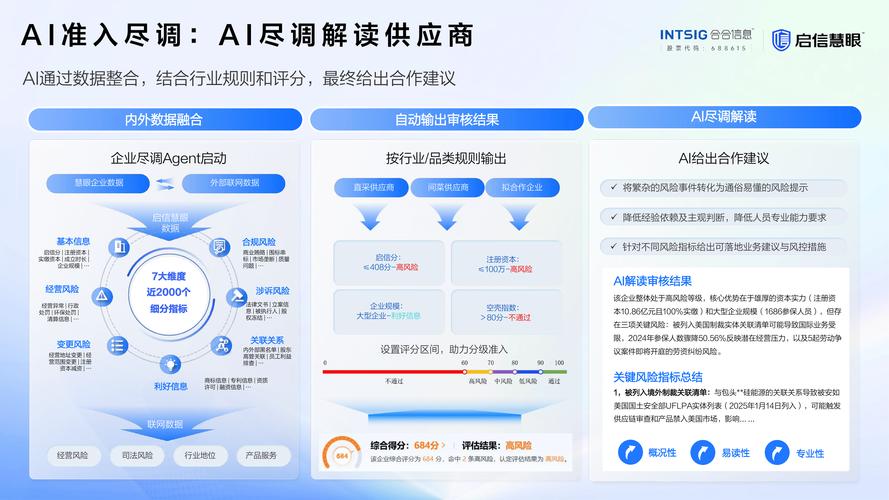 大模型供应链智能决策风险标注界面
 选对工具,别踩九成的人都会踩的坑
现在很多企业想上智能决策支持,一上来就被厂商带偏了。我接触过的行内人,都公认几个踩坑踩出来的经验。
第一个,别贪大而全,就盯着你最痛的那个点来。你是库存周转慢,那就找专门针对库存优化的智能决策支持工具;你是线上投放ROI上不去,就找投放决策支持的,别上来就要搞覆盖全公司的智能决策系统,钱花了一大堆,能用起来的功能没几个。
第二个,数据匹配度比模型参数大小重要一万倍。很多厂商吹我们模型有千亿参数,我们是大模型改的,听起来很牛,要是训练数据跟你的行业不沾边,那就是个花架子。你是做社区生鲜的,给你用训练了一堆金融数据的模型,它连小区早上八点到十点是买菜高峰这种基础常识都不知道,能给你出什么对的结果?反过来,哪怕模型参数不大,训练的时候用的都是你这个区域、你这个行业的真实数据,就好用得多。
第三个,永远把最终决策权握在自己手里。智能决策支持能算出来所有能数据化的东西,但是算不出来那些隐性的信息。比如新商圈对面要开一个大型超市抢人流,这个消息可能还在保密阶段,进不了系统;比如跟你合作的供应商老板最近资金链出问题,产能肯定保不住,这个也进不了系统。这些信息,只有你在行业里摸爬滚打了这么多年,才能拿到,最终拍板还是得你自己来。
说实话,我挺看好这行未来的发展。过去只有大企业花得起几百万上千万做定制化的智能决策支持,现在随着技术落地,中小商家也花得起几万块钱用得上适配自己行业的工具了,这其实是帮很多中小商家降低了决策的试错成本。对吧?很多创业者失败,不是能力不行,是决策的时候信息不够,漏了好几个关键变量,一步错步步错。现在有工具帮你把能想到的变量都理清楚,把坑都指出来,成功率自然高很多。
不过话说回来,这行走歪的人也确实多。前几天跟一个做智能决策支持创业的朋友喝茶,他说他们公司不接那种要求“全自动决策”的单子,只做“帮客户把盲区补全”的生意。我觉得这才是做对了。智能决策支持的核心,从来都不是抢决策者的位置,是帮你做更好的决策。这句话,不管是对卖家,还是对买家,都适用。
从根上说,它的定位从来都是“支持”,不是“替你决策”
早在上世纪七十年代,学术界就提出了智能决策支持的概念,从那时候定下的核心框架,就是以人为核心的辅助工具,从来没说过要取代决策者。 去年MIT斯隆管理学院公开发表了一篇跟踪三年的实证研究,样本是120多家不同规模的中小企业,覆盖零售、制造、物流三个行业,结论挺戳破泡沫的:那些完全放权给系统做最终决策的公司,平均净利润下滑了14.2%;那些把系统当做“外脑”,用来筛选方案、提示风险,最终拍板结合行业经验和本地信息的公司,平均净利润上涨了23.7%。 差了快四十个百分点。说白了就是差在对“智能决策支持”的定位错了。很多厂商卖货的时候,故意把“支持”两个字藏起来,只说“智能决策”,吹什么“零经验也能开公司”“躺着就能赚钱”,说白了就是抓住了很多创业者想偷懒的心理,割一波就走。智能决策支持人企协同框架图
大模型时代,智能决策支持真的变好用了
吐槽归吐槽,这两年技术进步真的快,我前两年接触到的智能决策支持,还只能跑固定的报表,给你列几个干巴巴的选项,遇到一点突发情况就废了。大模型出来之后,整个逻辑都变了。原来的系统是“你给我提明确需求,我给你出结果”,现在的新系统,能主动给你挖你想不到的盲区。 今年上半年,中科院自动化所的团队发了一个面向制造企业供应链的智能决策支持科研成果,我看过他们的内部演示。原来企业做季度备货,要自己把原材料价格、物流成本、订单波动一个个输进去,遇到突发情况比如东南亚港口罢工,得重新改参数算好几天。现在这套系统,会自动爬取全球港口的拥堵数据、大宗商品的期货价格,甚至还能扫出来主要供应商所在地区的极端天气预测,把这些变量实时放进模型推演,十分钟就能输出十几种不同备货方案的潜在风险和收益,还会把你没考虑到的隐性成本给标红。 我当时看了都惊讶。放在五年前,这根本想都不敢想。还有做临床智能决策支持的,现在已经能帮医生快速梳理病人的过往病史、匹配最新的同症状临床研究成果,把可能的误诊风险标出来,相当于给医生加了一个实时更新的移动知识库,大大降低了漏诊的概率。这些都是实打实的科研落地进步,不是吹出来的。大模型供应链智能决策风险标注界面
选对工具,别踩九成的人都会踩的坑
选对工具,别踩九成的人都会踩的坑
现在很多企业想上智能决策支持,一上来就被厂商带偏了。我接触过的行内人,都公认几个踩坑踩出来的经验。
第一个,别贪大而全,就盯着你最痛的那个点来。你是库存周转慢,那就找专门针对库存优化的智能决策支持工具;你是线上投放ROI上不去,就找投放决策支持的,别上来就要搞覆盖全公司的智能决策系统,钱花了一大堆,能用起来的功能没几个。
第二个,数据匹配度比模型参数大小重要一万倍。很多厂商吹我们模型有千亿参数,我们是大模型改的,听起来很牛,要是训练数据跟你的行业不沾边,那就是个花架子。你是做社区生鲜的,给你用训练了一堆金融数据的模型,它连小区早上八点到十点是买菜高峰这种基础常识都不知道,能给你出什么对的结果?反过来,哪怕模型参数不大,训练的时候用的都是你这个区域、你这个行业的真实数据,就好用得多。
第三个,永远把最终决策权握在自己手里。智能决策支持能算出来所有能数据化的东西,但是算不出来那些隐性的信息。比如新商圈对面要开一个大型超市抢人流,这个消息可能还在保密阶段,进不了系统;比如跟你合作的供应商老板最近资金链出问题,产能肯定保不住,这个也进不了系统。这些信息,只有你在行业里摸爬滚打了这么多年,才能拿到,最终拍板还是得你自己来。
说实话,我挺看好这行未来的发展。过去只有大企业花得起几百万上千万做定制化的智能决策支持,现在随着技术落地,中小商家也花得起几万块钱用得上适配自己行业的工具了,这其实是帮很多中小商家降低了决策的试错成本。对吧?很多创业者失败,不是能力不行,是决策的时候信息不够,漏了好几个关键变量,一步错步步错。现在有工具帮你把能想到的变量都理清楚,把坑都指出来,成功率自然高很多。
不过话说回来,这行走歪的人也确实多。前几天跟一个做智能决策支持创业的朋友喝茶,他说他们公司不接那种要求“全自动决策”的单子,只做“帮客户把盲区补全”的生意。我觉得这才是做对了。智能决策支持的核心,从来都不是抢决策者的位置,是帮你做更好的决策。这句话,不管是对卖家,还是对买家,都适用。