隐私计算技术:打破数据孤岛的隐形钥匙
你早上出门跟朋友随口聊了一句想换个最新款的无线耳机,半小时后打开社交软件,首页推荐全是各家耳机的广告。这种毛骨悚然的匹配度,相信大多数人都碰到过。
我们一边享受数据带来的精准服务,一边又怕自己的隐私被卖得底朝天。
平台也冤。想联合其他平台做个效果更好的模型,又不敢随便交换用户数据,现在监管这么严,出了事直接罚到肉疼。不合作吧,数据锁在自己家里,就是一堆没用的死数字。
这个矛盾了快十年的问题,终于被隐私计算技术给撬开了一条缝。
 互联网行业数据孤岛问题场景示意图
说白了,隐私计算解决的核心问题,就是实现了数据可用不可见。
很多人误解,以为隐私计算是把你的隐私数据加密藏起来不让任何人用。不对。它是让需求方只用数据的计算价值,拿不到原始的个人信息。比如银行想和电商联合做风控模型,不需要电商把所有用户的购物信息、地址电话发给银行,通过隐私计算,双方在不交换原始数据的前提下,就能训出一个比单独一方准确率高很多的风控模型,两边都赚,用户的隐私也没泄露。
之前试过很多方法,比如数据匿名化,把名字身份证号去掉再共享。可早十几年前就有实验证明,只要结合公开的其他数据,哪怕去掉了标识,也能精准定位到具体某个人。网飞当年办的那个算法比赛,就是活生生的例子。
隐私计算才是真正从技术逻辑上解决了这个问题。
 三种主流隐私计算技术性能对比图
不过话说回来,现在真正落地的项目,几乎没有只用单一路线的,都是混着来。要速度的时候用可信执行环境扛着,要核心数据安全的时候用安全多方算,大模型训练用联邦学习接进去,灵活搭配才是正道。那些吹“我的路线天下第一”的,大多是出来割融资的,听听就好。
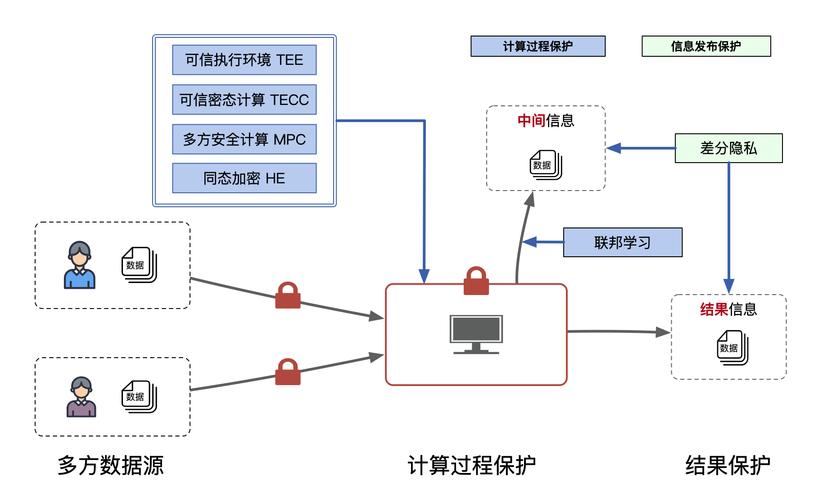 隐私计算技术落地,现在卡在哪?
别听媒体吹得那么神,什么“万亿市场爆发”,实际上现在大部分项目还是POC测试,真正大规模跑起来的商用项目,真没那么多。
第一个卡脖子的就是性能和成本。哪怕这几年优化了很多,隐私计算的速度还是比明文计算慢个几倍甚至几十倍,要支撑互联网级别的千万级并发,成本真的太高了。现在用得起的,都是银行、头部互联网大厂这种不差钱的主儿,中小企业想蹭一波数据流通的红利,根本掏不起这个钱。
第二个问题是标准不统一。你用A家的联邦学习框架,我用B家的,两个框架接口不兼容,根本没法对接,那还怎么联合计算?现在全国还没有一个统一的行业标准,各个厂商自己玩自己的,好不容易找到数据合作方,结果对接就要花好几个月,太折腾了。
第三个是认知误区。很多人觉得隐私计算就是绝对安全,用上就万事大吉了。真不是。去年就有好几篇顶会论文,说攻击者可以通过模型的参数更新,反推出原始数据里的个人信息,哪怕是用了联邦学习也没用。隐私计算只是把安全门槛提得很高,不是完全没漏洞,还是要持续攻防迭代的。
但哪怕有这么多问题,我还是看好这个方向。毕竟政策端推得太猛了,东数西算工程里明确把隐私计算列为核心支撑技术,全国各大数据交易所,几乎都配了隐私计算平台,就是为了让数据能够合法流通。
举个现成的例子,长三角的跨省异地医保结算,之前各个省市的医保数据都不敢往外拿,集中起来又怕泄露,现在用了隐私计算,不用集中数据,就能跨区域核对报销信息,用户直接异地结算,也没泄露任何个人的医保隐私,这不就是实实在在的落地吗?
以后隐私计算肯定会变成数字世界的基础设施,就像现在的HTTPS加密一样,你平时感受不到它的存在,但它悄悄帮你把隐私守得好好的,同时还能让数据安安稳稳创造价值。
想想其实挺美好的,对吧?
为什么隐私计算技术突然就火了?
往前推五年,除了圈子里的几个学术大牛,没多少人听说过这个词。这两年突然就成了香饽饽,互联网大厂、金融机构、政府数据平台,全在往里砸钱。 核心原因其实就两个。 第一,监管红线勒紧了。《个人信息保护法》《数据安全法》落地之后,明文交换用户数据直接就是违法,谁也不敢碰。之前那种买用户数据、共享用户信息的玩法,彻底死了。 第二,数据的价值越来越被看重,大家都想打破数据孤岛,把分散在各个机构的数据用起来,又不能碰隐私红线。互联网行业数据孤岛问题场景示意图
说白了,隐私计算解决的核心问题,就是实现了数据可用不可见。
很多人误解,以为隐私计算是把你的隐私数据加密藏起来不让任何人用。不对。它是让需求方只用数据的计算价值,拿不到原始的个人信息。比如银行想和电商联合做风控模型,不需要电商把所有用户的购物信息、地址电话发给银行,通过隐私计算,双方在不交换原始数据的前提下,就能训出一个比单独一方准确率高很多的风控模型,两边都赚,用户的隐私也没泄露。
之前试过很多方法,比如数据匿名化,把名字身份证号去掉再共享。可早十几年前就有实验证明,只要结合公开的其他数据,哪怕去掉了标识,也能精准定位到具体某个人。网飞当年办的那个算法比赛,就是活生生的例子。
隐私计算才是真正从技术逻辑上解决了这个问题。
现在主流的隐私计算技术路线,到底谁更实用?
说实话,现在圈儿里吵得厉害,各路厂商都吹自己的路线才是未来。实际上目前主流就是三条路线,各有优劣,没人能通吃所有场景。 第一条是联邦学习。简单说就是,数据不动模型动。各个机构都在自己本地训练模型,只交换训练过程中的参数更新,不碰原始数据。相当于大家一起凑钱做蛋糕,每个人都不用把自己的面粉拿给别人看,最后一起分到做好的蛋糕。这种适合大数据量的场景,比如联合广告建模、跨机构风控,现在落地最多的就是它。 第二条是安全多方计算。多个参与方共同完成计算,每个参与方都只能拿到自己的输入,除了最终计算结果,谁也看不到别人的原始数据。它的安全性是最高的,精度也最好,缺点就是计算开销大,速度慢,处理亿级数据的时候成本很高,目前一般用在对安全性要求极高的小体量数据场景。 第三条是可信执行环境。它依赖硬件,把计算过程放到一个加密隔离的硬件区域里,原始数据进去计算,只有结果能出来,任何外部程序都看不到里面的数据。相当于把数据锁在一个只有计算程序能进的黑盒子里,大家都信这个盒子不会泄密。速度快,兼容性好,缺点是安全依赖硬件厂商,万一硬件有漏洞,那就全完了。三种主流隐私计算技术性能对比图
不过话说回来,现在真正落地的项目,几乎没有只用单一路线的,都是混着来。要速度的时候用可信执行环境扛着,要核心数据安全的时候用安全多方算,大模型训练用联邦学习接进去,灵活搭配才是正道。那些吹“我的路线天下第一”的,大多是出来割融资的,听听就好。
隐私计算技术落地,现在卡在哪?
隐私计算技术落地,现在卡在哪?
别听媒体吹得那么神,什么“万亿市场爆发”,实际上现在大部分项目还是POC测试,真正大规模跑起来的商用项目,真没那么多。
第一个卡脖子的就是性能和成本。哪怕这几年优化了很多,隐私计算的速度还是比明文计算慢个几倍甚至几十倍,要支撑互联网级别的千万级并发,成本真的太高了。现在用得起的,都是银行、头部互联网大厂这种不差钱的主儿,中小企业想蹭一波数据流通的红利,根本掏不起这个钱。
第二个问题是标准不统一。你用A家的联邦学习框架,我用B家的,两个框架接口不兼容,根本没法对接,那还怎么联合计算?现在全国还没有一个统一的行业标准,各个厂商自己玩自己的,好不容易找到数据合作方,结果对接就要花好几个月,太折腾了。
第三个是认知误区。很多人觉得隐私计算就是绝对安全,用上就万事大吉了。真不是。去年就有好几篇顶会论文,说攻击者可以通过模型的参数更新,反推出原始数据里的个人信息,哪怕是用了联邦学习也没用。隐私计算只是把安全门槛提得很高,不是完全没漏洞,还是要持续攻防迭代的。
但哪怕有这么多问题,我还是看好这个方向。毕竟政策端推得太猛了,东数西算工程里明确把隐私计算列为核心支撑技术,全国各大数据交易所,几乎都配了隐私计算平台,就是为了让数据能够合法流通。
举个现成的例子,长三角的跨省异地医保结算,之前各个省市的医保数据都不敢往外拿,集中起来又怕泄露,现在用了隐私计算,不用集中数据,就能跨区域核对报销信息,用户直接异地结算,也没泄露任何个人的医保隐私,这不就是实实在在的落地吗?
以后隐私计算肯定会变成数字世界的基础设施,就像现在的HTTPS加密一样,你平时感受不到它的存在,但它悄悄帮你把隐私守得好好的,同时还能让数据安安稳稳创造价值。
想想其实挺美好的,对吧?