联邦学习技术:数据隐私围墙下,AI照样能干活
前几个月和一个做医疗AI的朋友喝酒,他拍着桌子叹气,说做肺癌早筛模型攒了三年数据,还是不够,找别家医院要,人家谁敢给?出了问题谁担责?
放在五年前,大家可能还会铤而走险匿名化打个包传过来,现在个人信息保护法摆在这里,一旦出事,核心管理层都得负责任。
这僵局,居然被联邦学习破开了。
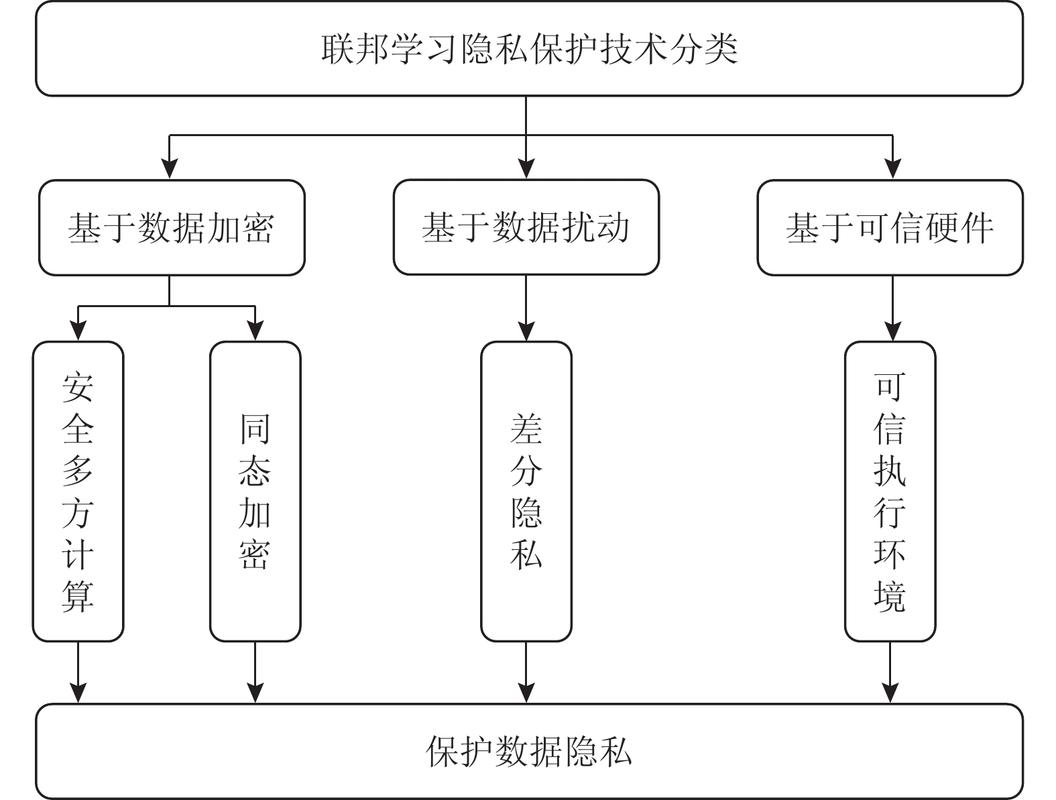 传统数据共享与联邦学习隐私保护对比图
说白了就是,我用了你家数据的价值,但是我拿不到你家任何一个用户的原始信息。完美踩中了现在合规的需求,这不火才怪。
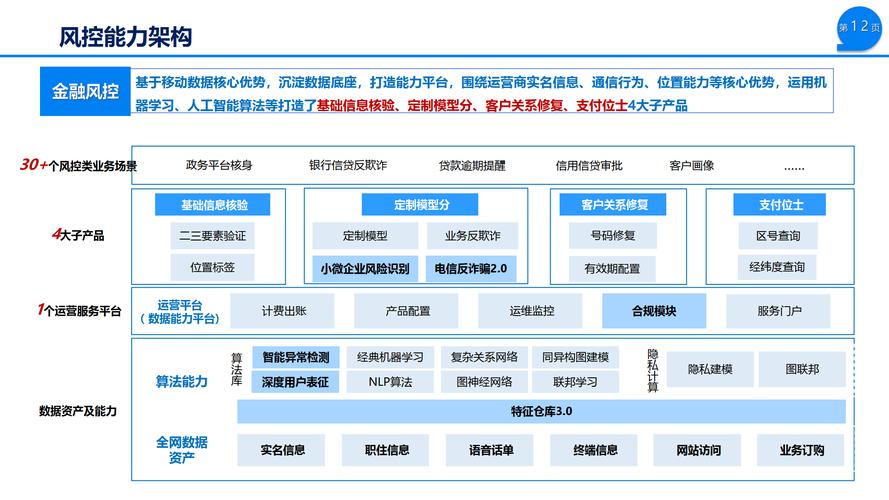 金融行业联邦学习联合风控部署示意图
医疗领域现在也跑起来了,去年就有顶级团队用联邦学习做多中心的糖尿病视网膜病变筛查模型,五家三甲医院一起参与,数据全留在本地机房,训出来的模型准确率和把所有数据凑一块训的几乎没差。你说香不香?
不过话说回来,现在联邦学习的坑也不少。我认识的算法工程师吐槽,参与方多了之后,通信开销能涨几十倍,传个梯度都要等半天,对带宽和服务器配置要求太高,中小公司根本玩不起。
还有安全漏洞,之前看过一篇顶会论文,说就算你不传原始数据,也能通过梯度信息反推出用户的原始数据,虽然概率不高,但是对金融医疗这种敏感领域,还是不敢掉以轻心。
现在很多厂商吹联邦学习万能,其实真不是,它就是解决特定问题的方案,你要是自己家数据够、合规,完全没必要凑这个热闹。
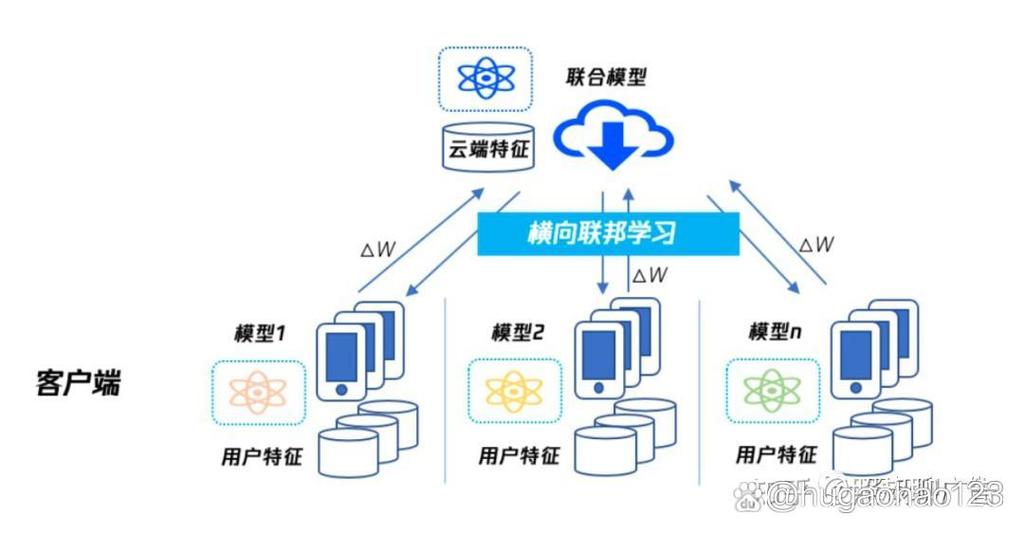 联邦学习技术接下来的风口在哪?
现在最火的方向就是和大模型结合。大家都知道,大模型训练需要巨量的数据,很多高质量的行业数据都散在不同机构手里,根本凑不齐。
现在大家都在做联邦大模型,说白了就是用联邦学习的方式,把各家手里的行业数据用起来,训行业大模型,又不用碰原始数据,完全合规。比如最近几个国有银行都在测基于联邦学习的金融行业大模型,用了不同分行、不同合作机构的数据,没有数据出域,效果比用单一数据源好太多。
还有就是轻量化,现在很多开源社区都在做轻量的联邦学习框架,往下砸门槛,原来部署一套一套要几百万,现在几万块就能搭起来跑通小项目,中小公司也能用得起。
还有就是和其他隐私技术的融合,比如结合差分隐私、同态加密,把梯度泄露的风险压到几乎为零,解决安全的后顾之忧。
说实话,我挺看好这个方向的,现在合规越来越严,数据流通的红线越来越清楚,原来那种裸奔式的数据共享肯定走不通了,市场必然需要一种既能用数据,又不碰隐私的技术。联邦学习刚好踩中了这个点。
当然,现在还有很多问题要解决,效率、安全、成本哪一个都不是小问题,但是哪项新技术刚出来不是这样?十几年前AI也没人觉得能大规模落地,现在不就无处不在了?
你说呢?
为什么联邦学习突然就火了?
核心原因不是技术突然突破了,是合规卡脖子了。 这么多年,AI想吃数据,数据都被圈在一个个孤岛上。银行要做风控,需要用户的社交数据、消费数据,都在互联网大厂手里,人家不会给你,你也不敢拿。医院要做多中心临床研究,每家医院的数据都只能存在自己机房,跨机构调数据等于违法。 出过事之后,没人敢冒这个险了。 联邦学习最绝的一点,就是数据可用不可见,模型动数据不动。你品品这个逻辑,要训练模型,不用把各家数据凑到一块中心化存储,只需要各家在本地完成训练,把训练出来的模型参数或者梯度信息传过来聚合,原始数据从来不会离开你自己的地盘。传统数据共享与联邦学习隐私保护对比图
说白了就是,我用了你家数据的价值,但是我拿不到你家任何一个用户的原始信息。完美踩中了现在合规的需求,这不火才怪。
现在的联邦学习,真的能落地了?
很多人说联邦学习不就是停在论文里的PPT技术吗?我之前也这么想,直到去年逛金融展,才发现好多银行都已经用上了。 现在最成熟的落地场景就是联合风控。举个例子,城商行要做小微企业信贷风控,自己只有企业的金融数据,没有企业的水电、物流、电商经营数据,这些数据分别在电网、物流公司、电商平台手里,谁都不能把原始数据交出来。 用纵向联邦学习就能解决,各家对齐用户ID,各自在本地计算梯度,聚合之后就能训出比原来准好几个点的风控模型,没有一家泄露原始数据。 要是十几家区域性银行一起训信用卡反欺诈模型,大家都有不同用户、相同的特征维度,用横向联邦学习就搞定,训出来的模型效果比单一家用自己数据训的好太多,谁都不用把自己的用户数据交出去。金融行业联邦学习联合风控部署示意图
医疗领域现在也跑起来了,去年就有顶级团队用联邦学习做多中心的糖尿病视网膜病变筛查模型,五家三甲医院一起参与,数据全留在本地机房,训出来的模型准确率和把所有数据凑一块训的几乎没差。你说香不香?
不过话说回来,现在联邦学习的坑也不少。我认识的算法工程师吐槽,参与方多了之后,通信开销能涨几十倍,传个梯度都要等半天,对带宽和服务器配置要求太高,中小公司根本玩不起。
还有安全漏洞,之前看过一篇顶会论文,说就算你不传原始数据,也能通过梯度信息反推出用户的原始数据,虽然概率不高,但是对金融医疗这种敏感领域,还是不敢掉以轻心。
现在很多厂商吹联邦学习万能,其实真不是,它就是解决特定问题的方案,你要是自己家数据够、合规,完全没必要凑这个热闹。
联邦学习技术接下来的风口在哪?
联邦学习技术接下来的风口在哪?
现在最火的方向就是和大模型结合。大家都知道,大模型训练需要巨量的数据,很多高质量的行业数据都散在不同机构手里,根本凑不齐。
现在大家都在做联邦大模型,说白了就是用联邦学习的方式,把各家手里的行业数据用起来,训行业大模型,又不用碰原始数据,完全合规。比如最近几个国有银行都在测基于联邦学习的金融行业大模型,用了不同分行、不同合作机构的数据,没有数据出域,效果比用单一数据源好太多。
还有就是轻量化,现在很多开源社区都在做轻量的联邦学习框架,往下砸门槛,原来部署一套一套要几百万,现在几万块就能搭起来跑通小项目,中小公司也能用得起。
还有就是和其他隐私技术的融合,比如结合差分隐私、同态加密,把梯度泄露的风险压到几乎为零,解决安全的后顾之忧。
说实话,我挺看好这个方向的,现在合规越来越严,数据流通的红线越来越清楚,原来那种裸奔式的数据共享肯定走不通了,市场必然需要一种既能用数据,又不碰隐私的技术。联邦学习刚好踩中了这个点。
当然,现在还有很多问题要解决,效率、安全、成本哪一个都不是小问题,但是哪项新技术刚出来不是这样?十几年前AI也没人觉得能大规模落地,现在不就无处不在了?
你说呢?